Description
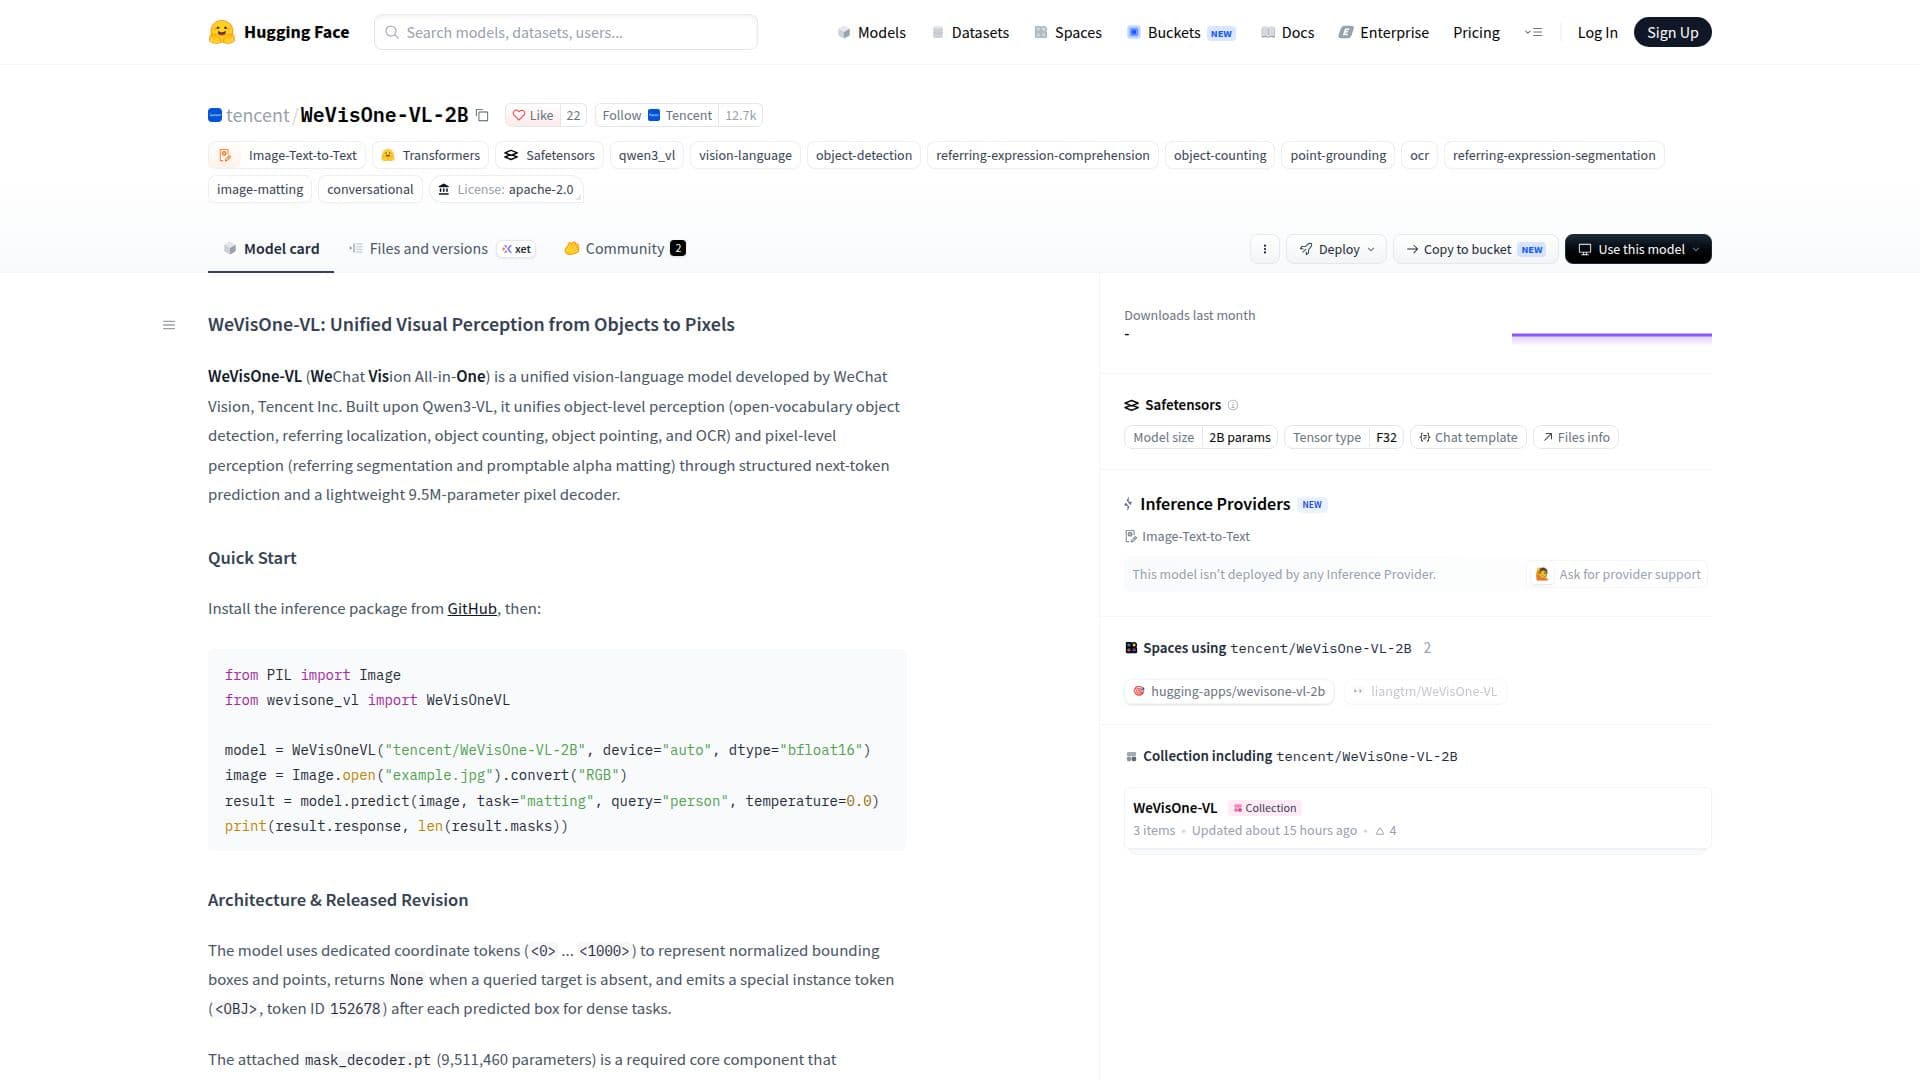
WeVisOne-VL est un modèle sophistiqué de vision-langage développé par WeChat Vision, une division de Tencent Inc. Ce modèle est construit sur le cadre Qwen3-VL et est conçu pour unifier les tâches de perception au niveau des objets et au niveau des pixels. Il est capable de gérer la détection d'objets à vocabulaire ouvert, la localisation référentielle, le comptage d'objets, le pointage d'objets et la reconnaissance optique de caractères (OCR).
Lire la suite
De plus, il prend en charge des tâches au niveau des pixels telles que la segmentation référentielle et le matting alpha promptable.
Le modèle utilise une prédiction structurée du prochain jeton et dispose d'un décodeur de pixels léger avec 9,5 millions de paramètres. Un composant clé de WeVisOne-VL est le mask_decoder.pt, qui intègre un Adaptateur de Caractéristiques Visuelles, un Décodeur de Requêtes Guidées par Boîte et une Tête de Prédiction Dense Conditionnée par Instance. Ces composants travaillent ensemble pour affiner les prédictions et produire des alpha mattes haute résolution.
WeVisOne-VL est destiné aux applications de recherche en ancrage visuel, localisation, pointage, comptage, OCR, segmentation et matting d'images. Il n'est pas conçu pour la prise de décision autonome ou l'identification individuelle. Le modèle est optimisé pour la perception d'images en un seul tour et ne prend pas en charge les grilles vidéo.
Le modèle est publié sous la licence Apache 2.0, les composants tiers conservant leurs licences d'origine. Les utilisateurs sont encouragés à consulter les fichiers source pour des détails spécifiques sur les licences.
- CatégorieOutils de vision par ordinateur
- Modèle tarifaireOpen source
- DéploiementCloud
- PlateformesWeb
Points forts de WeVisOne-VL
Modèle unifié de vision-langage
Perception au niveau des objets
Perception au niveau des pixels
Détection d'objets à vocabulaire ouvert
Segmentation référentielle
Matting alpha promptable
Prédiction structurée du prochain jeton
Décodeur de pixels léger
Premiers pas avec WeVisOne-VL
Accéder à la page du modèle : Visitez la page du modèle Hugging Face
S'authentifier : Connectez-vous à votre compte Hugging Face
Configurer : Configurez le modèle avec les paramètres nécessaires
Envoyer des invites : Saisissez vos données visuelles pour traitement
Ajuster : Modifiez les paramètres du modèle pour des tâches spécifiques
Cas d'utilisation de WeVisOne-VL
- Ancrage Visuel
- Détection d'Objets
- Matting d'Images
- Localisation OCR
- Segmentation Référentielle