Description
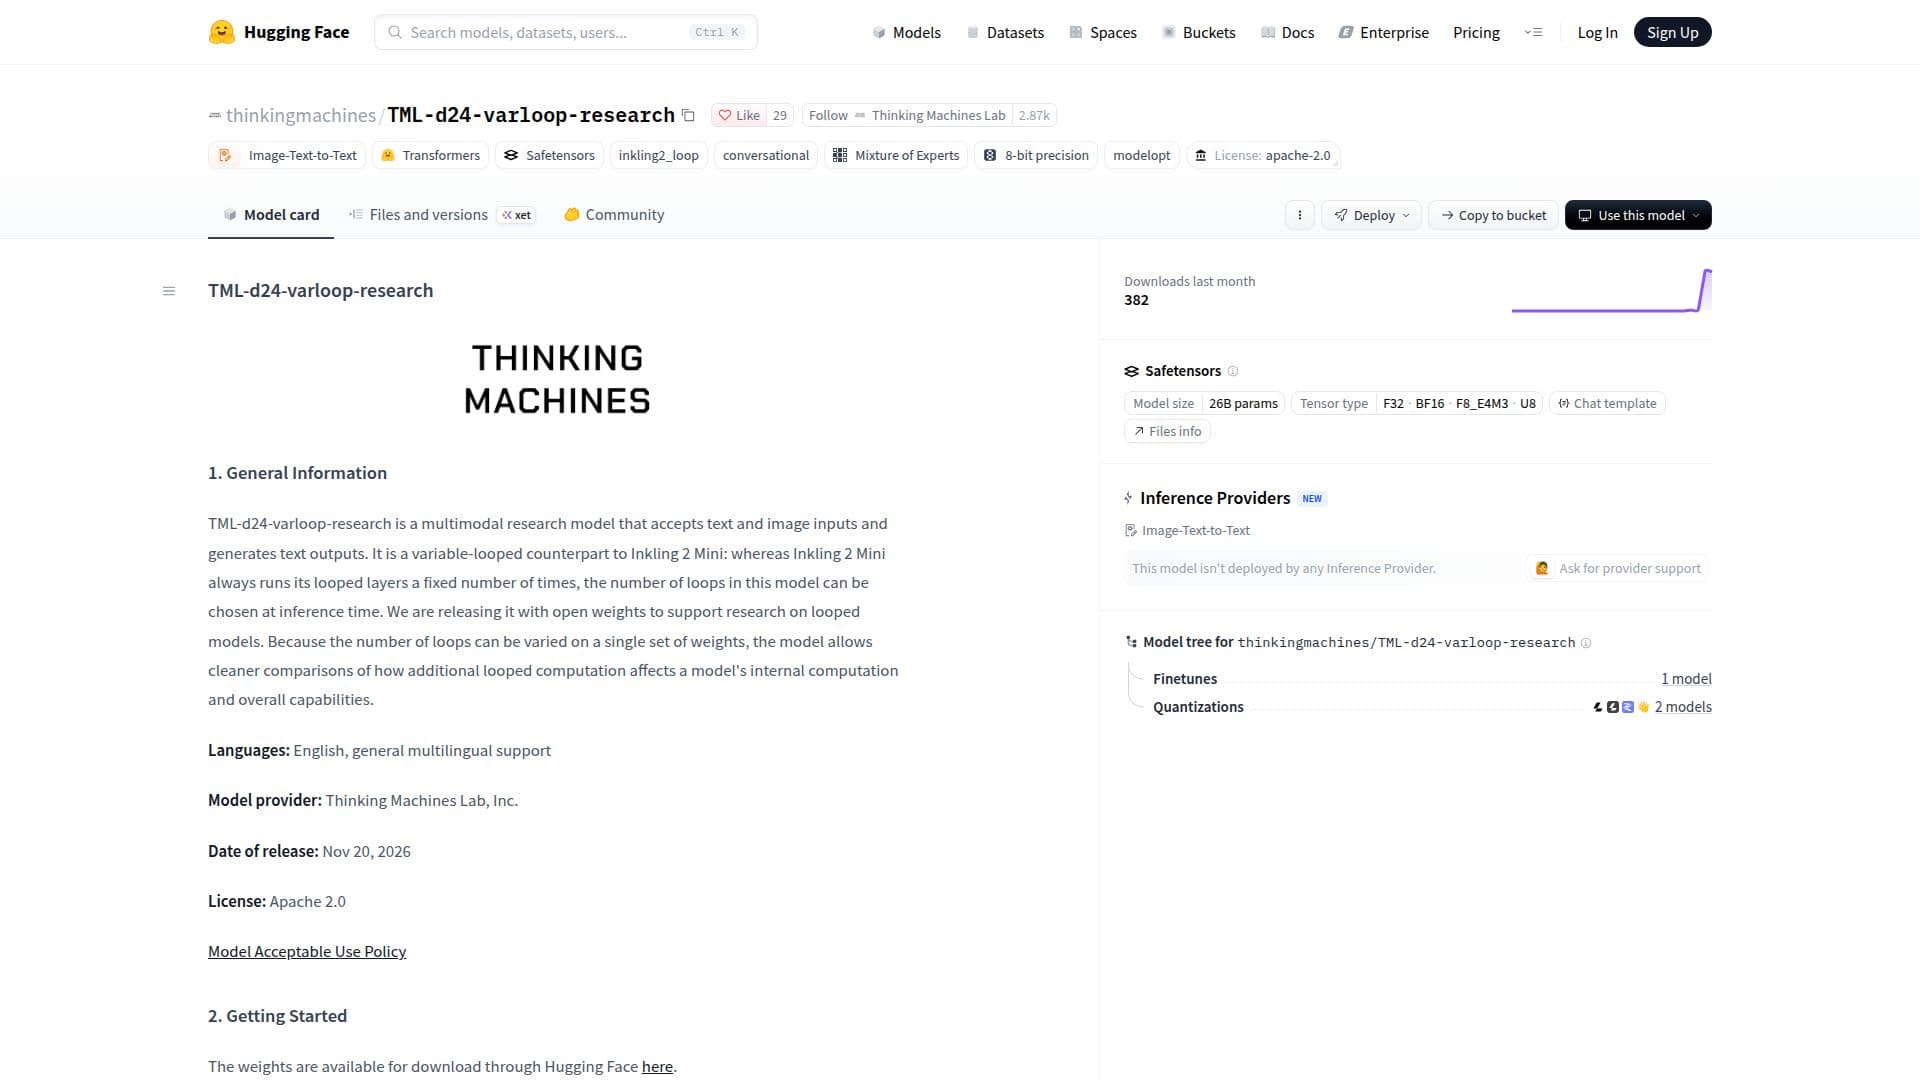
TML-d24-varloop-research est un modèle de recherche multimodal développé par Thinking Machines Lab, Inc., conçu pour traiter à la fois des entrées textuelles et des images et produire des sorties textuelles. Publié le 20 novembre 2026, sous une licence Apache 2.0, ce modèle constitue une contribution significative au domaine des modèles en boucle, offrant une architecture à boucle variable contrairement à son homologue à boucle fixe, Inkling 2 Mini. Les chercheurs peuvent ajuster dynamiquement le nombre de boucles pendant l'inférence, permettant des comparaisons plus claires de l'impact de calculs supplémentaires sur les processus internes d'un modèle et ses capacités globales.
Lire la suite
Le modèle est distribué sous forme de poids ouverts via Hugging Face, avec une taille de point de contrôle unique d'environ 20 Go. Il nécessite une machine avec au moins 32 Go de mémoire GPU ou unifiée, compatible avec des configurations telles que NVIDIA DGX Spark, GPU NVIDIA (par exemple, GeForce RTX 5090 ou RTX PRO 6000 Blackwell), ou des Macs avec puce Apple. TML-d24-varloop-research prend en charge l'inférence locale en utilisant divers frameworks, y compris Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth, llama.cpp, Llama App, Ollama et Exo Labs. Il prend également en charge le post-entraînement avec Miles et SkyRL.
Architecturalement, TML-d24-varloop-research est un transformateur à 24 couches uniquement décodeur avec des couches feed-forward Mixture-of-Experts (MoE) éparses. Les 12 couches centrales peuvent s'exécuter un nombre variable de fois, partageant des poids, et ont été entraînées avec 1 à 5 passes. Chaque couche dirige des jetons vers 8 des 128 experts, et l'attention est un hybride de couches locales et globales. Le modèle est nativement multimodal, encodant des images via un transformateur de vision et les traitant conjointement avec du texte dans un espace caché partagé. Il dispose de 26,4 milliards de paramètres (3,4 milliards actifs à 1 passe) et prend en charge les numérics NVFP4 et MXFP8. Il gère des textes encodés en UTF-8 et des entrées d'images basées sur des pixels (de 40 px à 4096 px par dimension) avec une fenêtre de contexte allant jusqu'à 1 million de jetons.
Les données d'entraînement pour TML-d24-varloop-research comprennent une large variété de types de contenu provenant de sources disponibles publiquement, d'acquisitions tierces et de données générées en interne/synthétiquement. La curation des données a impliqué un nettoyage, une dé-duplication et un filtrage pour garantir la qualité et la sécurité. Le modèle partage son pré-entraînement et sa première étape de mi-entraînement avec Inkling 2 Mini mais diverge dans les étapes ultérieures, en particulier dans son entraînement à boucle variable, où 1 à 5 passes ont été échantillonnées. Bien que les évaluations montrent des performances variables par rapport à Inkling 2 Mini à travers des benchmarks tels que l'Agentic Coding, l'Interprétation Visuelle et le Raisonnement, il est principalement destiné à être un artefact de recherche et n'est pas recommandé pour une utilisation en production en raison de comportements potentiellement imprévisibles à différents nombres de passes et des limitations générales communes aux modèles de base, telles que l'hallucination et les biais provenant des données d'entraînement.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireOpen source
- DéploiementExécution locale
- PlateformesWeb
Points forts de TML-d24-varloop-research
Entrée multimodale : Accepte à la fois des entrées textuelles et des images
Sortie textuelle : Génère du texte basé sur les entrées
Bouclage variable : Le nombre de couches en boucle peut être choisi au moment de l'inférence
Poids ouverts : Disponibles en téléchargement pour soutenir la recherche
26,4 milliards de paramètres : Modèle à grande échelle avec 3,4 milliards de paramètres actifs à 1 passe
Support multilingue : Support général pour plusieurs langues
Licence Apache 2.0 : Licence open-source pour utilisation et modification
Support d'inférence locale : Compatible avec Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth, llama.cpp, Llama App, Ollama, Exo Labs
Support post-entraînement : Peut être post-entraîné avec Miles et SkyRL
Mixture-of-Experts (MoE) éparse : Utilise des couches feed-forward MoE
Attention hybride : Combine des couches d'attention locales et globales
Multimodalité native : Images encodées via un transformateur de vision et traitées conjointement avec du texte
Fenêtre de contexte élevée : Prend en charge jusqu'à 1 million de jetons
Numériques à précision mixte : Prend en charge NVFP4 et MXFP8
Premiers pas avec TML-d24-varloop-research
Télécharger les poids : Accédez aux poids du modèle via Hugging Face.
Préparer le matériel : Assurez-vous qu'une machine unique avec au moins 32 Go de mémoire GPU ou unifiée est disponible.
Installer le logiciel : Configurez les frameworks d'inférence requis comme Hugging Face, SGLang ou vLLM ainsi que leurs dépendances.
Configurer le modèle : Chargez le point de contrôle de 20 Go dans votre framework choisi.
Définir les passes de boucle : Choisissez le nombre de couches en boucle souhaité pour l'inférence.
Fournir des entrées : Alimentez le modèle avec du texte encodé en UTF-8 et des images basées sur des pixels (dimensions de 40 px à 4096 px).
Générer la sortie : Recevez des sorties textuelles du modèle en fonction des entrées fournies.
Cas d'utilisation de TML-d24-varloop-research
- Recherche multimodale
- Études de modèles en boucle
- Génération de texte à partir d'images
- Traitement de texte multilingue
- Développement de modèles à poids ouverts
- Déploiement d'inférence locale
- Ajustement du modèle