Description
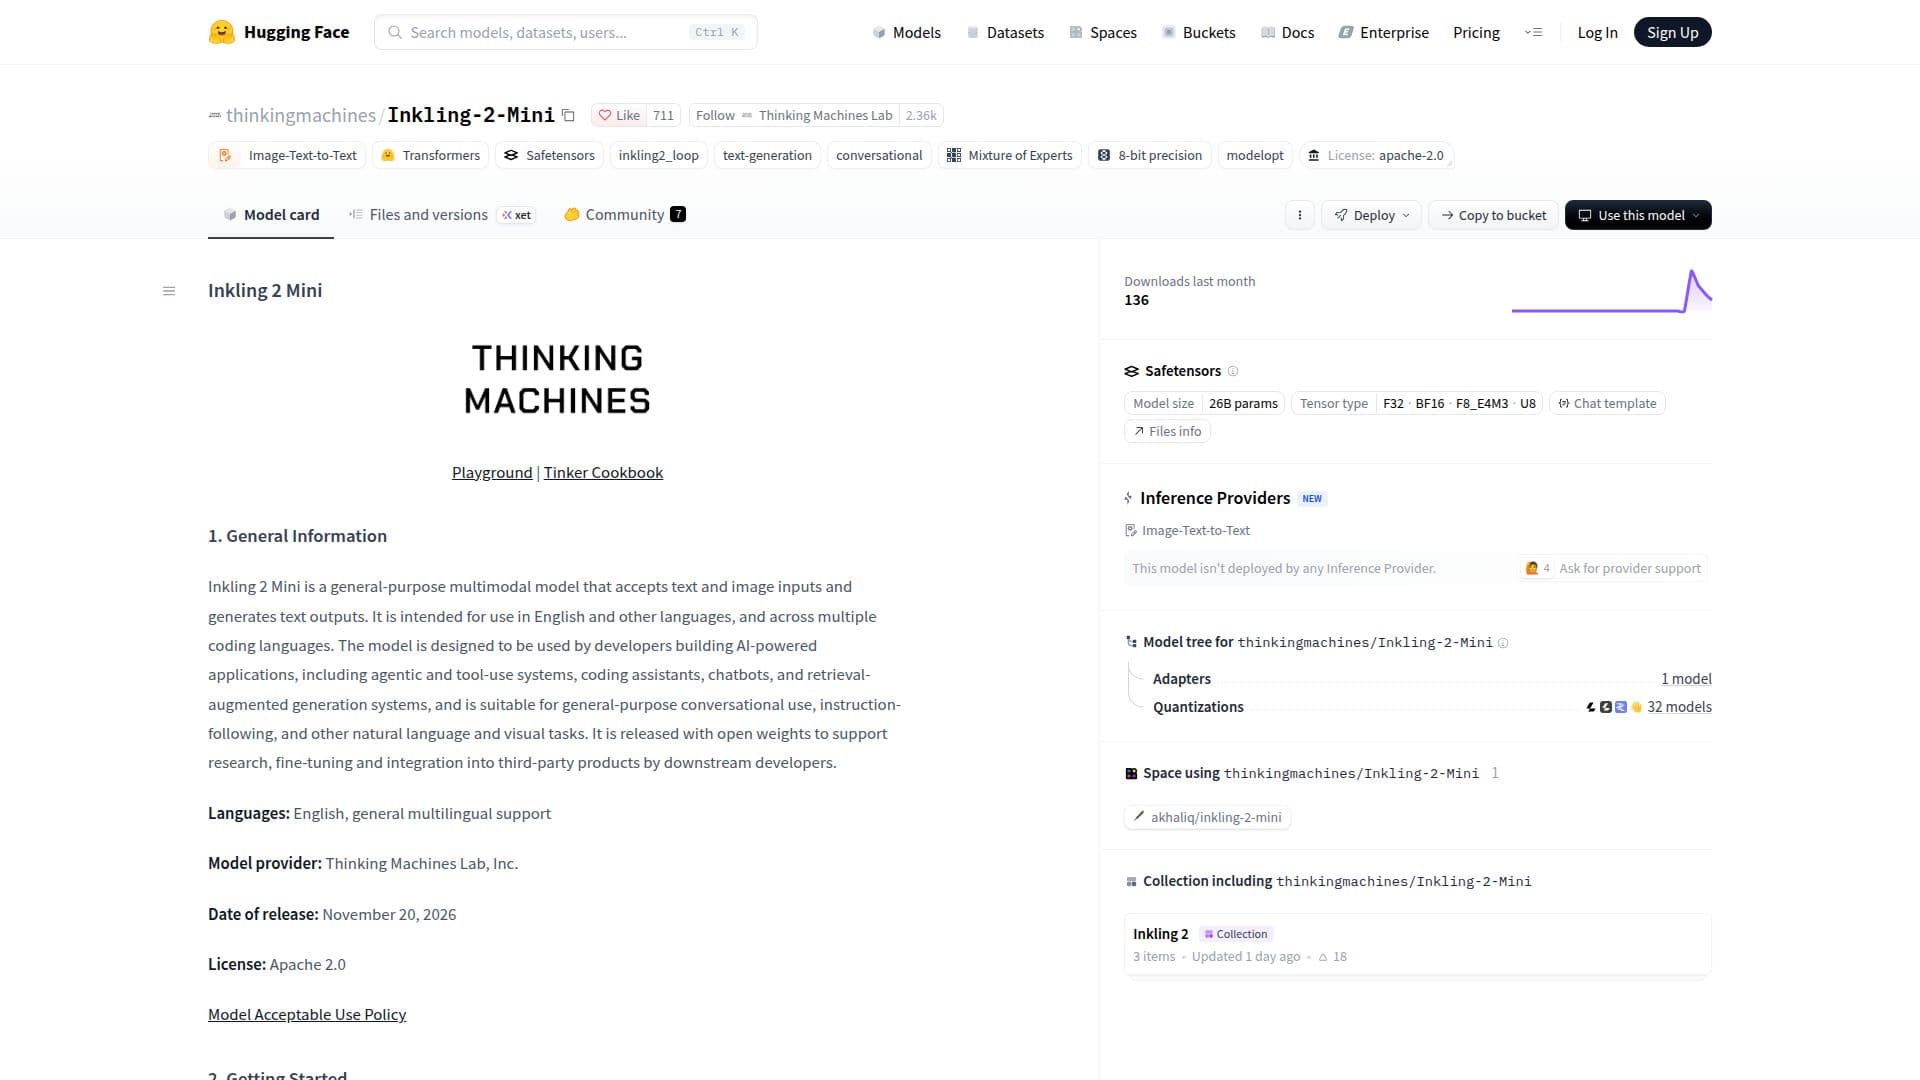
Inkling 2 Mini est un modèle multimodal polyvalent conçu pour traiter à la fois des entrées textuelles et d'image, générant ensuite des sorties textuelles. Développé par Thinking Machines Lab, Inc., ce modèle est conçu pour une large applicabilité, prenant en charge l'anglais et d'autres langues, ainsi que plusieurs langages de programmation. Il est particulièrement adapté aux développeurs engagés dans la création d'applications alimentées par l'IA, y compris des systèmes agentiques et d'utilisation d'outils, des assistants de codage, des chatbots et des systèmes de génération augmentée par récupération (RAG). De plus, il est capable d'une utilisation conversationnelle générale, de suivre des instructions et d'effectuer diverses tâches en langage naturel et visuel.
Lire la suite
Le modèle est publié avec des poids ouverts sous une licence Apache 2.0, encourageant la recherche, le fine-tuning et l'intégration dans des produits tiers par des développeurs en aval. Il est distribué sous la forme d'un seul point de contrôle d'environ 20 Go, utilisant des précisions mixtes NVFP4 et MXFP8. Cette taille compacte permet une inférence locale sur du matériel compatible, y compris 1x NVIDIA DGX Spark, des appareils Apple silicon avec 32 Go ou plus de mémoire (MacBooks, Mac minis, Studios) et d'autres GPU avec un VRAM recommandé de 32 Go ou plus.
Inkling 2 Mini prend en charge l'inférence locale via plusieurs frameworks, y compris Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth (y compris les versions GGUF quantifiées), llama.cpp (pour les versions GGUF quantifiées), Llama App, Ollama et Exo Labs (sur Apple silicon). Il peut également être post-entraîné avec Miles et SkyRL. Le modèle présente une architecture de transformateur à décodeur uniquement à 24 couches avec des couches d'alimentation Mixture-of-Experts (MoE) éparses. Ses 12 couches centrales fonctionnent trois fois avec des poids partagés, fournissant efficacement 48 applications de couches par jeton à partir de 24 couches de poids. Chaque couche achemine les jetons vers 8 des 128 experts, et l'attention est un hybride de couches locales et globales. Les images sont encodées via un transformateur de vision, les entrées d'image et de texte étant projetées dans un espace caché partagé pour un traitement conjoint par le décodeur. Le modèle possède 26,4 milliards de paramètres, avec 3,4 milliards de paramètres actifs, et prend en charge une fenêtre de contexte allant jusqu'à 1 million de jetons.
Les données d'entraînement pour Inkling 2 Mini englobent une large gamme de types de contenu, y compris du texte, des images et des vidéos, provenant de dépôts disponibles publiquement, d'acquisitions tierces, de génération interne et d'augmentation synthétique. La curation des données implique le nettoyage, le traitement et la modification des ensembles de données, y compris la dé-duplication et le filtrage pour la qualité et la sécurité. Des évaluations de sécurité ont été menées, couvrant l'interaction humaine-IA quotidienne et les tests de capacités dangereuses, avec des atténuations appliquées par le biais d'un entraînement d'alignement. Les limitations du modèle incluent des hallucinations potentielles, des échecs occasionnels dans le suivi des instructions, une performance dégradée lors de longues conversations et des biais provenant des données d'entraînement. Il est moins capable que des modèles plus grands en matière de rappel factuel et de questions lourdes en connaissances, et peut présenter un raisonnement répétitif ou une fiabilité agentique, en particulier dans les langues non anglaises. Les développeurs sont conseillés d'appliquer une supervision humaine, d'exécuter des charges de travail agentiques dans des environnements isolés et de réaliser des évaluations indépendantes avant le déploiement.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireOpen source
- DéploiementExécution locale
- PlateformesWeb
Points forts de Inkling 2 Mini
Entrée multimodale : Accepte à la fois des entrées textuelles et d'image pour le traitement.
Génération de sortie textuelle : Produit des sorties textuelles basées sur des entrées multimodales.
Modèle polyvalent : Conçu pour une large gamme d'applications et de tâches.
Support multilingue : Fonctionne en anglais et dans d'autres langues.
Support de plusieurs langages de programmation : Compatible avec divers environnements de codage.
Publication de poids ouverts : Disponible en téléchargement et utilisation avec des poids ouverts.
Licence Apache 2.0 : Offre de la flexibilité pour la recherche, le fine-tuning et l'intégration.
Orienté développeur : Destiné à la création d'applications alimentées par l'IA.
Support de systèmes agentiques : Adapté au développement de systèmes agentiques et d'utilisation d'outils.
Capacité d'assistant de codage : Peut être utilisé pour créer des assistants de codage.
Intégration de chatbots : Facilite le développement de chatbots.
Systèmes de génération augmentée par récupération (RAG) : Prend en charge la création de systèmes RAG.
Capacité d'inférence locale : Peut fonctionner sur un calcul AI local avec du matériel spécifié.
Support étendu des frameworks : Compatible avec Hugging Face, SGLang, vLLM, et plus.
Options de post-entraînement : Peut être post-entraîné avec Miles et SkyRL.
Grande fenêtre de contexte : Prend en charge jusqu'à 1 million de jetons.
Premiers pas avec Inkling 2 Mini
Télécharger les poids du modèle : Accédez et téléchargez les poids d'Inkling 2 Mini depuis Hugging Face.
Accéder via la plateforme Tinker : Utilisez la plateforme de fine-tuning Tinker pour l'accès API et l'interaction avec le modèle.
Installer les renderers Tinker : Installez le package tml-renderers pour l'intégration à la plateforme Tinker.
Configurer le matériel local : Assurez-vous que le matériel requis (par exemple, NVIDIA DGX Spark, Apple silicon avec 32 Go ou plus de mémoire) est disponible.
Installer les frameworks logiciels : Configurez les frameworks d'inférence locale pris en charge comme Hugging Face, SGLang ou llama.cpp.
Exécuter l'inférence : Exécutez le modèle localement en utilisant les frameworks choisis pour la génération de texte à partir d'entrées d'image et de texte.
Cas d'utilisation de Inkling 2 Mini
- Développement d'applications IA
- Création de systèmes agentiques
- Outils d'assistant de codage
- Mise en œuvre de chatbots
- Génération augmentée par récupération
- IA conversationnelle générale
- Traitement du langage naturel
- Traitement de tâches visuelles
- Fine-tuning du modèle
- Intégration de produits tiers