Aller au contenu principal
ToolPotion
Conseiller IA
Soumettre

SenseNova-Loop-9B-Preview

LLM#85Modèles d'IA et LLMOpen source · Web

SenseNova-Loop-9B-Preview est un modèle de langage multimodal conçu pour des scénarios à long contexte et des flux de travail agentiques. Il traite à la fois du texte et des images pour générer des sorties textuelles, soutenant des applications dans la compréhension de documents, le codage et l'interaction avec des outils externes. Le modèle présente une architecture de décodeur en boucle unique et des hyper-connections contraints par un manifold à deux flux pour des chemins d'exécution profonds et efficaces.

Visiter l'URL
Partager
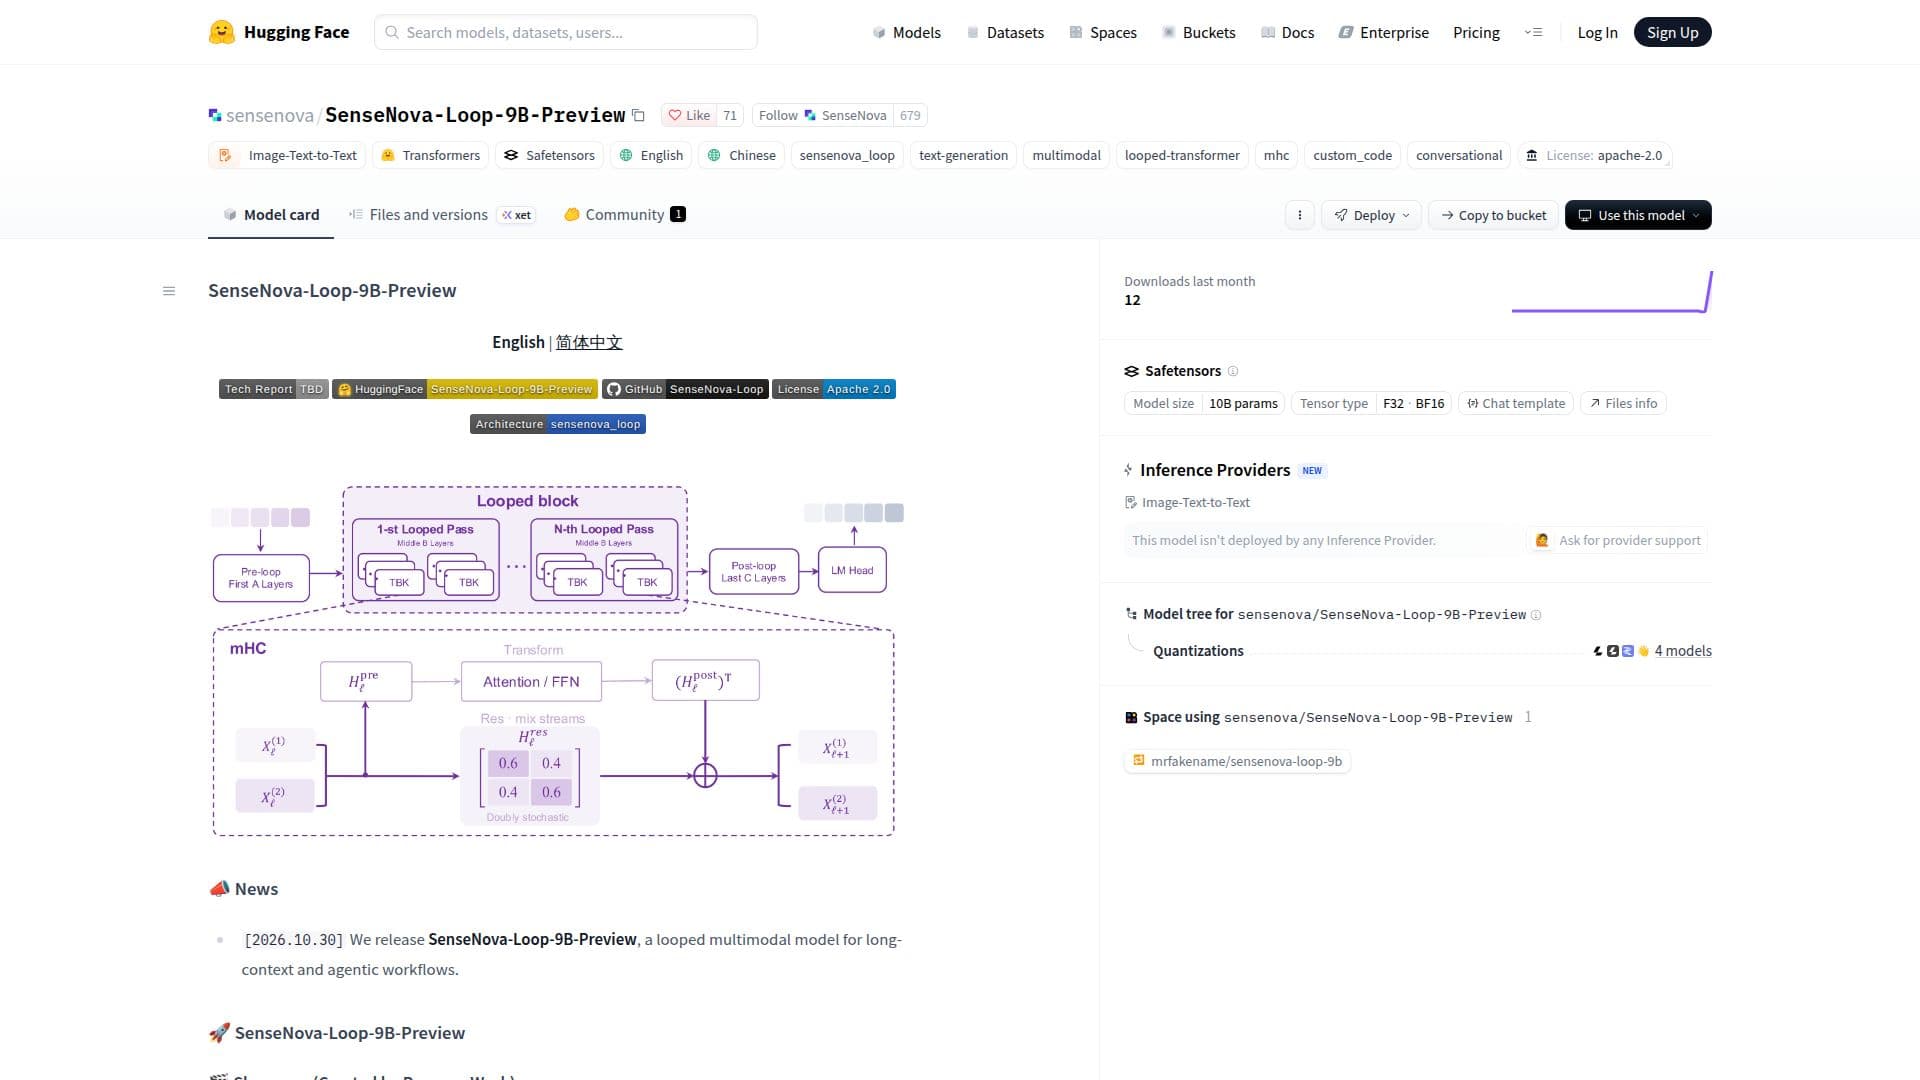
Capture d’écran de SenseNova-Loop-9B-Preview

SenseNova-Loop-9B-Preview est un modèle de langage multimodal avancé conçu pour gérer des scénarios complexes à long contexte et des flux de travail agentiques. Développé par SenseNova, ce modèle est capable d'accepter à la fois des entrées textuelles et des images, générant ensuite des sorties textuelles. Ses principales applications couvrent des domaines tels que la compréhension complète de documents, des tâches de codage sophistiquées et une interaction fluide avec divers outils externes.

Lire la suite

Le cœur de l'architecture de SenseNova-Loop-9B-Preview réside dans sa combinaison innovante d'un décodeur en boucle et d'hyper-connections contraints par un manifold à deux flux (mHC). Ce design permet à un bloc contigu de couches de décodeur d'être exécuté deux fois en utilisant des poids partagés, approfondissant ainsi le chemin d'exécution sans dupliquer les paramètres. Les mappings appris au sein du système mHC gèrent efficacement le flux d'informations entre deux flux résiduels dans la section en boucle, améliorant la capacité du modèle à traiter et synthétiser des informations.

Les recettes d'entraînement pour le modèle intègrent de longues séquences, des entrées multimodales diverses et des trajectoires de tâches supervisées, avec une longueur maximale de séquence d'entraînement atteignant 262 144 tokens. Cet entraînement extensif permet une performance robuste sur une large gamme de tâches complexes. Pour un fonctionnement optimal, il est conseillé aux utilisateurs d'utiliser l'environnement de déploiement documenté et les paramètres de configuration.

Les points forts architecturaux incluent un bloc en boucle partagé où 24 couches de décodeur sont appliquées deux fois, résultant en 56 exécutions de couches de décodeur à partir de seulement 32 couches distinctes. Le mHC à deux flux facilite le routage intelligent et la combinaison d'informations à travers les flux résiduels. De plus, le décodeur utilise un mécanisme d'attention hybride, entrelaçant des couches d'attention linéaire et complète dans un motif répétitif de quatre couches, qui est préservé à travers les passages en boucle. Le modèle prend également en charge MTP pour une inférence accélérée, avec Dspark et Dflash2 actuellement en développement pour améliorer encore la vitesse.

  • CatégorieModèles d'IA et LLM
  • Modèle tarifaireOpen source
  • DéploiementCloud
  • PlateformesWeb

  • Entrée multimodale : Accepte à la fois du texte et des images

  • Génération de texte : Produit des sorties textuelles

  • Architecture de décodeur en boucle : Exécute les couches de décodeur deux fois avec des poids partagés

  • Hyper-connections contraints par un manifold à deux flux (mHC) : Gère le flux d'informations entre les flux résiduels

  • Traitement à long contexte : Prend en charge des longueurs de séquence d'entraînement allant jusqu'à 262 144 tokens

  • Support des flux de travail agentiques : Conçu pour l'interaction avec des outils externes

  • Attention hybride : Entrelaçe des couches d'attention linéaire et complète

  • Efficacité des paramètres : Réalise 56 exécutions de couches de décodeur à partir de 32 couches distinctes

  • Compréhension de documents : Capable de traiter des documents complexes

  • Applications de codage : Prend en charge des tâches liées au code

  • Accélération de l'inférence MTP : Disponible pour un traitement plus rapide

  • Support de fine-tuning : Fournit des recettes d'entraînement documentées pour la personnalisation

  • Licence Apache 2.0 : Licence open-source pour utilisation et modification

  • Intégration Hugging Face : Disponible pour téléchargement et déploiement sur Hugging Face

  1. Accéder à la page du modèle : Naviguez vers la page SenseNova-Loop-9B-Preview sur Hugging Face.

  2. Installer les dépendances : Installez PyTorch compatible avec votre environnement CUDA, puis installez Transformers 5.18.0 et PyTorch 2.11.0.

  3. Charger le modèle : Utilisez la bibliothèque Transformers pour charger le modèle et sa mise en œuvre personnalisée depuis le dépôt Hugging Face ou un répertoire local.

  4. Configurer l'inférence : Définissez `model_id` sur l'ID du dépôt ou le chemin local et configurez des paramètres comme `enable_thinking` et `device`.

  5. Générer du texte : Exécutez l'exemple Python fourni pour effectuer la génération de texte, en spécifiant le nombre de nouveaux tokens.

  6. Fine-tuner le modèle : Utilisez les commandes d'entraînement documentées avec votre jeu de données SFT sur un seul nœud avec 8 GPU pour le fine-tuning.

  7. Déployer le modèle : Utilisez des options de déploiement comme LightLLM ou SGLang en remplaçant le chemin du modèle local dans les exemples fournis.

  • Compréhension de documents à long contexte
  • Automatisation des flux de travail agentiques
  • Génération de contenu multimodal
  • Assistance avancée au codage
  • Automatisation de la conception PPT
  • Génération de texte pour le design motion
  • Rapports d'analyse de données
  • Recherche et développement multimodal
Avis sur SenseNova-Loop-9B-Preview

Chargement...

Outils IA populaires comme SenseNova-Loop-9B-Preview

MiniMax M3 est un modèle d'IA avancé excelling dans les tâches de codage et agentiques. Il dispose d'une fenêtre de contexte de 1M et d'une compréhension multimodale native,…

Modèles d'IA et LLM

N°61 en LLM

Voir l'outil

Modèle d'IA avancé excelling dans les tâches de codage et agentiques. Il dispose d'une fenêtre de contexte de 1M et d'une compréhension multimodale native,…MiniMax M3 est un modèle d'IA avancé excelling dans les tâches de codage et agentiques. Il dispose d'une fenêtre de contexte de 1M et d'une compréhension multimodale native,…

Modèles d'IA et LLM
N°61 en LLM

LiquidAI LFM3-1.7B est un modèle de texte conçu pour des agents locaux et des applications spécialisées. Il dispose d'une architecture tri-hybride et prend en charge une fenêtre…

Modèles d'IA et LLM

N°91 en LLM

Voir l'outil

Modèle de texte conçu pour des agents locaux et des applications spécialisées. Il dispose d'une architecture tri-hybride et prend en charge une fenêtre…LiquidAI LFM3-1.7B est un modèle de texte conçu pour des agents locaux et des applications spécialisées. Il dispose d'une architecture tri-hybride et prend en charge une fenêtre…

Modèles d'IA et LLM
N°91 en LLM

DeepSeek-V4-Flash-Vision-Exp est un modèle multimodal expérimental de la famille DeepSeek-V4, améliorant les capacités de compréhension visuelle. Il s'appuie sur l'architecture…

Modèles d'IA et LLM

N°70 en LLM

Voir l'outil

Modèle multimodal expérimental de la famille DeepSeek-V4, améliorant les capacités de compréhension visuelle. Il s'appuie sur l'architecture…DeepSeek-V4-Flash-Vision-Exp est un modèle multimodal expérimental de la famille DeepSeek-V4, améliorant les capacités de compréhension visuelle. Il s'appuie sur l'architecture…

Modèles d'IA et LLM
N°70 en LLM

Inkling-Small est un modèle multimodal polyvalent qui traite des entrées textuelles, d'images et audio pour générer des sorties textuelles. Il aide les développeurs à créer des…

Modèles d'IA et LLM

N°27 en LLM

Voir l'outil

Modèle multimodal polyvalent qui traite des entrées textuelles, d'images et audio pour générer des sorties textuelles. Il aide les développeurs à créer des…Inkling-Small est un modèle multimodal polyvalent qui traite des entrées textuelles, d'images et audio pour générer des sorties textuelles. Il aide les développeurs à créer des…

Modèles d'IA et LLM
N°27 en LLM

pplx-embed-v2-context-9b-preview est un modèle d'incorporation contextuelle conçu pour des morceaux de documents dans des systèmes de génération augmentée par récupération (RAG).…

Modèles d'IA et LLM
Voir l'outil

Modèle d'incorporation contextuelle conçu pour des morceaux de documents dans des systèmes de génération augmentée par récupération (RAG).…pplx-embed-v2-context-9b-preview est un modèle d'incorporation contextuelle conçu pour des morceaux de documents dans des systèmes de génération augmentée par récupération (RAG).…

Modèles d'IA et LLM
Voir le Top 5 Modèles IA

DeepSeek V4 Flash est une collection de modèles d'IA conçue pour des tâches avancées de génération de texte. Elle s'appuie sur des principes de science ouverte et de source…

Modèles d'IA et LLM
Voir l'outil

Collection de modèles d'IA conçue pour des tâches avancées de génération de texte. Elle s'appuie sur des principes de science ouverte et de source…DeepSeek V4 Flash est une collection de modèles d'IA conçue pour des tâches avancées de génération de texte. Elle s'appuie sur des principes de science ouverte et de source…

Modèles d'IA et LLM
Voir le Top 5 Modèles IA

Muse Spark 1.3

Modèles IA

Muse Spark 1.3 est le modèle d'IA de Meta pour les flux de travail agentiques et de codage, conçu pour des tâches à long terme nécessitant un appel d'outils fiable et un…

Modèles d'IA et LLM
Voir l'outil

Modèles IA

Modèle d'IA de Meta pour les flux de travail agentiques et de codage, conçu pour des tâches à long terme nécessitant un appel d'outils fiable et un…Muse Spark 1.3 est le modèle d'IA de Meta pour les flux de travail agentiques et de codage, conçu pour des tâches à long terme nécessitant un appel d'outils fiable et un…

En vedetteModèles d'IA et LLM
Voir le Top 5 Modèles IA

LLaVA

Dépôts GitHub d'IA

LLaVA est un modèle d'ajustement d'instructions visuelles qui combine les capacités des grands modèles de langage et de vision. Il vise à atteindre des performances de niveau…

Modèles d'IA et LLM
Voir l'outil

Dépôts GitHub d'IA

Modèle d'ajustement d'instructions visuelles qui combine les capacités des grands modèles de langage et de vision. Il vise à atteindre des performances de niveau…LLaVA est un modèle d'ajustement d'instructions visuelles qui combine les capacités des grands modèles de langage et de vision. Il vise à atteindre des performances de niveau…

Modèles d'IA et LLM
Voir le Top 250 Dépôts GitHub d'IA
1 sur 8