

La plupart des procès sur le droit d'auteur et l'IA ne sont toujours pas tranchés en 2026, mais la carte est plus lisible qu'il y a un an. Anthropic a versé 1,5 milliard de dollars pour régler le litige avec des auteurs, les maisons de disques signent des accords de licence avec Suno et Udio, et la plus grosse affaire du secteur de la presse, celle du New York Times contre OpenAI et Microsoft, en est à la phase du jugement sommaire. Aucun tribunal américain n'a jugé que l'entraînement d'un modèle d'IA sur des œuvres protégées est toujours légal, et aucun n'a jugé qu'il est toujours illégal.
Un observateur indépendant recense 148 procès américains pour atteinte au droit d'auteur visant des entreprises d'IA (ChatGPT Is Eating the World). Pas besoin de tous les suivre. Ce guide couvre les affaires qui font bouger le droit, où chacune en est aujourd'hui, et ce que cela implique si vous utilisez ChatGPT, Claude ou Midjourney pour du travail sérieux. Tout ce qui est présenté ci-dessous comme une demande ou un grief reste une allégation. Les tribunaux n'ont tranché la plupart d'entre eux.
Ceci est un point d'étape, pas un conseil juridique. Il s'appuie sur la presse judiciaire, des outils de suivi et les conditions des éditeurs eux-mêmes, et une partie vieillira vite. Si de l'argent est en jeu, consultez un avocat.
En bref : qui gagne les procès sur le droit d'auteur et l'IA ?
Personne ne gagne nettement. Voici comment les pièces s'assemblent.
Les accords et les licences s'accumulent plus vite que les jugements, ce qui suggère que chaque camp préfère acheter de la certitude plutôt que risquer une décision. La seule cour d'appel à s'être prononcée jusqu'ici, dans l'affaire Ross, a donné tort à l'entreprise d'IA, mais sur un outil non génératif. Les tribunaux allemands lisent la même question plus strictement que ne le feraient les tribunaux américains. Et sur la question qui intéresse le plus les utilisateurs, la propriété de ce que produit l'IA, la réponse américaine est stable : un humain doit apporter l'expression.
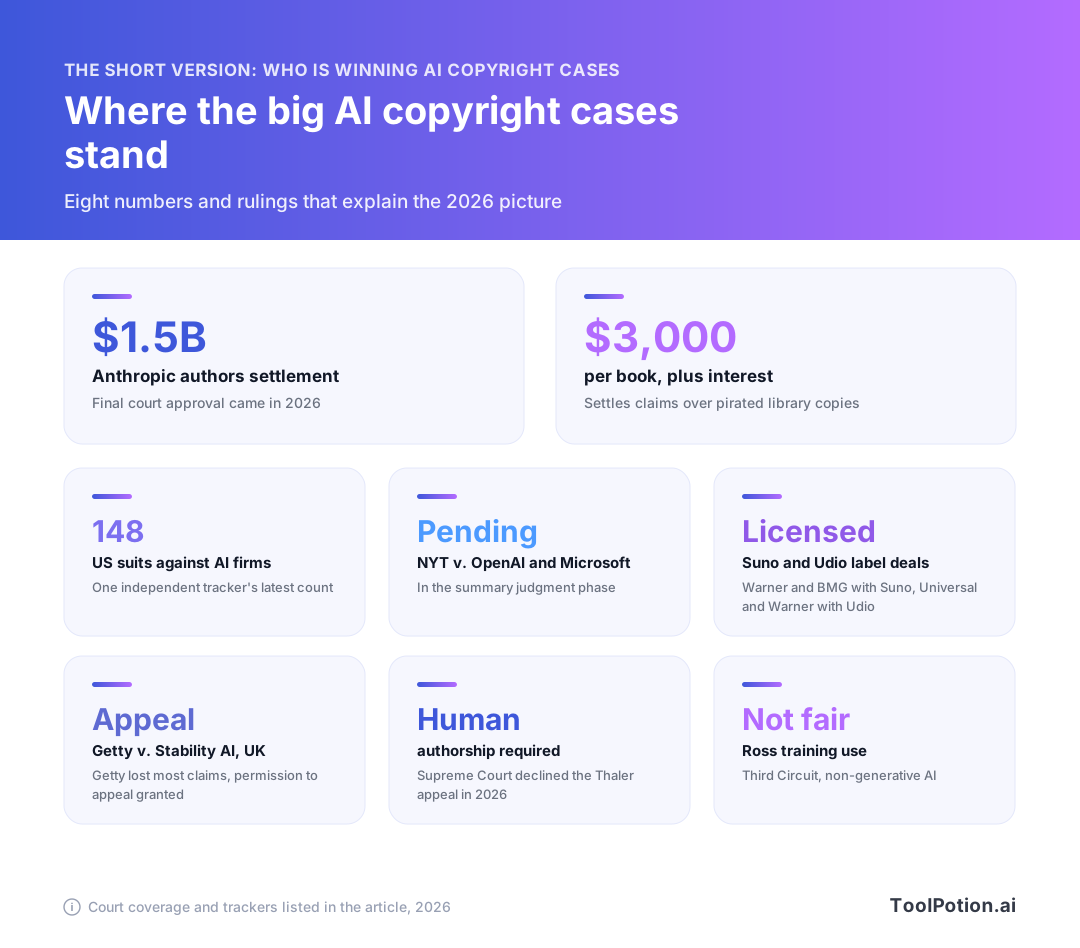
Le graphique ci-dessus résume tout l'article en huit vignettes. La suite explique ce qui se cache derrière chacune.
Comment on en est arrivé là, en quatre ans
La première vague date de 2023. Des artistes ont attaqué Stability AI, Midjourney et DeviantArt, Getty a poursuivi Stability AI au Royaume-Uni, et le New York Times a assigné OpenAI et Microsoft à la fin de l'année. Les maisons de disques ont suivi en 2024 avec des procès contre Suno et Udio. En 2025, les premières vraies décisions sont tombées, et les studios sont entrés dans la danse : Disney et Universal ont poursuivi Midjourney, puis Warner Bros. Discovery aussi.
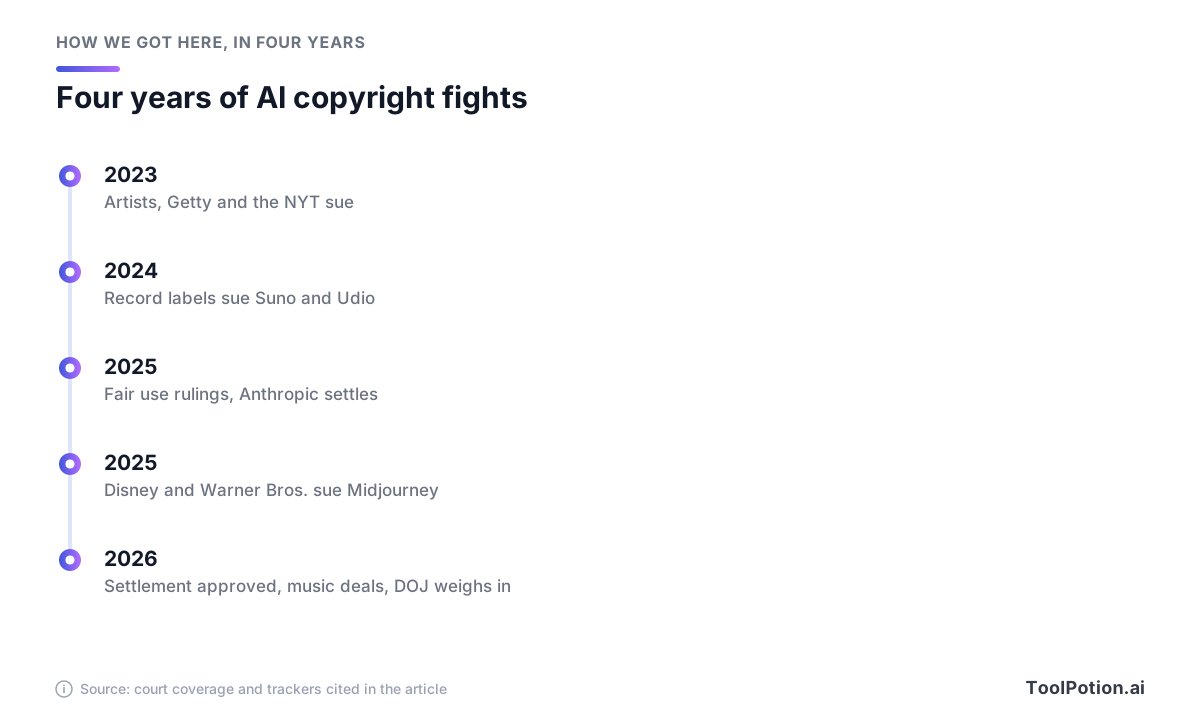
En 2026, les affaires en cours ont commencé à mûrir. Un gros accord a reçu son approbation définitive, les cours d'appel ont commencé à se prononcer, et le gouvernement américain a pris position pour un camp. Les sections suivantes les passent en revue par ordre d'importance.
The New York Times c. OpenAI et Microsoft
C'est l'affaire à laquelle pensent la plupart des gens quand ils parlent du « procès sur le droit d'auteur et l'IA ». Le Times a porté plainte fin 2023, en alléguant qu'OpenAI a entraîné ses modèles sur ses articles sans autorisation et que ChatGPT et Copilot de Microsoft peuvent les reproduire. OpenAI soutient que l'entraînement relève du fair use. Les affaires d'autres médias et d'auteurs ont été regroupées en une seule procédure à New York, que l'outil de suivi décrit comme « déjà en phase de jugement sommaire » (ChatGPT Is Eating the World).
Le dernier gros rebondissement est venu de Washington. L'administration Trump a déposé un mémoire devant le tribunal fédéral de Manhattan pour soutenir OpenAI, en affirmant que l'entraînement des IA relève en général du fair use des œuvres protégées. Selon Reuters, c'est apparemment la première fois que le gouvernement américain intervient dans la vague de procès sur l'entraînement des IA, et un tel mémoire a une valeur consultative plutôt que juridique. Le Times a répondu que l'administration se rangeait du côté des entreprises d'IA au détriment des créateurs dont elles ont utilisé les œuvres (Reuters).
N'y voyez pas un verdict. Un mémoire du gouvernement est un argument, pas une décision, et les jugements sommaires peuvent faire l'objet d'un appel. USA Today a depuis déposé sa propre plainte contre OpenAI, qui reprend les griefs du Times, selon l'outil de suivi : la pile continue donc de grossir pendant que l'affaire principale avance vers une décision.
Auteurs c. Anthropic : l'accord à 1,5 milliard de dollars
L'affaire Anthropic représente le plus gros versement à ce jour. Des auteurs accusaient Anthropic d'avoir téléchargé des livres piratés depuis les sites Library Genesis et Pirate Library Mirror pendant la conception de ses modèles Claude. Anthropic a accepté de payer 1,5 milliard de dollars, soit environ 3 000 $ par œuvre plus les intérêts, et la juge Araceli Martinez-Olguin a donné son approbation définitive en 2026, selon l'Authors Guild (Authors Guild). Anthropic n'a pas reconnu sa responsabilité.
La renonciation aux recours est étroite. Les auteurs abandonnent leurs griefs sur l'acquisition et la copie passées de leurs livres par Anthropic. Les griefs portant sur les sorties de l'IA et sur la conduite future ne sont pas couverts, pas plus que ceux concernant des œuvres absentes de la liste de l'accord (même source). Des éditeurs de musique ont aussi poursuivi Anthropic au sujet de paroles de chansons. Cela reste des allégations.
La leçon pour le reste du secteur : l'origine des données d'entraînement compte. Ici, l'argent a été versé pour des copies piratées de bibliothèques, pas pour l'acte d'entraînement en lui-même.
Thomson Reuters c. Ross et les décisions sur le fair use
Les deux premiers juges américains à s'être prononcés sur l'entraînement des IA et le fair use, en 2025, ont rendu des décisions divergentes, a relevé Reuters. Le repère le plus récent vient d'une cour d'appel. Ross Intelligence, une start-up aujourd'hui disparue, avait entraîné un outil de recherche juridique sur les headnotes de Westlaw. En 2026, la Cour d'appel du troisième circuit a confirmé que ces headnotes sont protégeables par le droit d'auteur et que l'usage de Ross ne relevait pas du fair use (Courthouse News).
Le collège de juges a qualifié l'usage de Ross de « transformatif au minimum, au mieux » et souligné que Ross voulait concurrencer directement Westlaw. C'est une grosse réserve pour tous les autres. Ross n'était pas un modèle génératif, donc des défendeurs comme OpenAI plaideront que la décision ne les concerne pas. Reste que c'est la première parole d'une cour d'appel sur l'entraînement et le fair use, et qu'elle a donné tort à l'entreprise d'IA.
Musique, images et vidéo : des licences avant les verdicts
Suno et Udio
La musique est le domaine où les accords avancent le plus vite. Udio affirme avoir des accords de licence avec Universal Music Group et Warner Music Group pour entraîner de nouveaux modèles sur leurs catalogues, et que l'accord avec Warner met aussi fin à leur litige sur le droit d'auteur (Udio). Suno a annoncé des partenariats avec Warner Music Group et BMG, et indique que ses modèles v6 ont été développés avec des partenaires du secteur dont Warner, BMG et Believe. Les annonces de Suno parlent de partenariats et non de règlements amiables, et nous ne les présentons donc pas comme tels ici. Nous n'avons pas pu confirmer auprès de sources primaires quels labels, le cas échéant, poursuivent encore Suno : vérifiez avant de supposer qu'un catalogue donné est sous licence.
Udio et Suno ressemblent désormais moins à de purs défendeurs qu'à des licenciés de certains labels. Pour vous, cela veut dire que la réponse à « ce morceau peut-il servir dans ma pub ? » dépend du catalogue dont s'inspire un résultat donné, ce que vous ne pouvez pas voir. Nous y revenons dans la partie pratique.
GEMA en Allemagne
Hors des États-Unis, un tribunal de Munich s'est montré moins clément envers les entreprises d'IA. La société allemande de gestion collective GEMA a obtenu gain de cause contre OpenAI au sujet de paroles de chansons en 2025. En 2026, le tribunal régional de Munich a donné raison à la GEMA contre Suno. Teosto, la société de gestion collective finlandaise, résume ainsi le jugement : le tribunal a estimé que le modèle mémorise les œuvres protégées et en conserve des copies, de sorte que l'entraînement sur celles-ci comme leur reproduction en sortie constituent des atteintes. Suno peut faire appel (Teosto).
Le fair use est une doctrine américaine, donc les tribunaux allemands raisonnent autrement, mais quiconque vend en Europe doit noter la tendance.
Midjourney, Getty et Stability AI
Disney et Universal ont poursuivi Midjourney en 2025, suivis par Warner Bros. Discovery. Midjourney a accepté, par stipulation, de remettre ses jeux de données d'entraînement vidéo aux plaignants (ChatGPT Is Eating the World). C'est de la phase de communication de pièces (discovery), pas une décision, mais cela signifie que les studios pourront regarder à l'intérieur des données d'entraînement.
L'affaire britannique de Getty contre Stability AI a pris l'autre direction. Le juge a rejeté les griefs de contrefaçon de Getty, puis lui a accordé l'autorisation de faire appel, ce que Chambers présente comme rare pour un juge de première instance (Chambers). Getty mène aussi une procédure distincte aux États-Unis contre Stability AI, que ce guide ne couvre pas. Si vous utilisez le Stable Diffusion Web UI à poids ouverts, l'appel britannique est celui à surveiller.
Voici l'état des principales affaires en un coup d'œil.
| Affaire | Ce qui est allégué | Où elle en est |
|---|---|---|
| NYT, auteurs c. OpenAI et Microsoft | Entraînement sur des articles et des livres sans autorisation | Phase de jugement sommaire à New York. Le mémoire du gouvernement américain soutient OpenAI |
| Auteurs c. Anthropic | Entraînement sur des livres piratés | Accord à 1,5 Md$, approbation définitive en 2026 |
| Thomson Reuters c. Ross | Entraînement sur les headnotes de Westlaw | Confirmé par le troisième circuit : pas de fair use |
| Labels c. Suno | Entraînement sur des enregistrements sonores | Partenariats annoncés avec Warner et BMG ; situation des autres labels non confirmée |
| Labels c. Udio | Entraînement sur des enregistrements sonores | Accords de licence avec Universal et Warner (selon Udio) |
| Disney, Universal, Warner Bros. c. Midjourney | Entraînement sur des personnages et reproduction de ceux-ci | En phase de discovery, avec partage des données vidéo d'entraînement |
| Getty c. Stability AI (Royaume-Uni) | Entraînement sur des photos, usage de filigranes | Griefs de droit d'auteur rejetés, autorisation d'appel accordée |
Où se situe le risque juridique quand vous utilisez des outils d'IA
La plupart des affaires ci-dessus opposent des ayants droit et des entreprises d'IA. Elles portent sur la façon dont les modèles ont été construits. En tant qu'utilisateur, vous êtes à l'autre bout de la chaîne, et votre exposition vient surtout de ce que vous publiez.
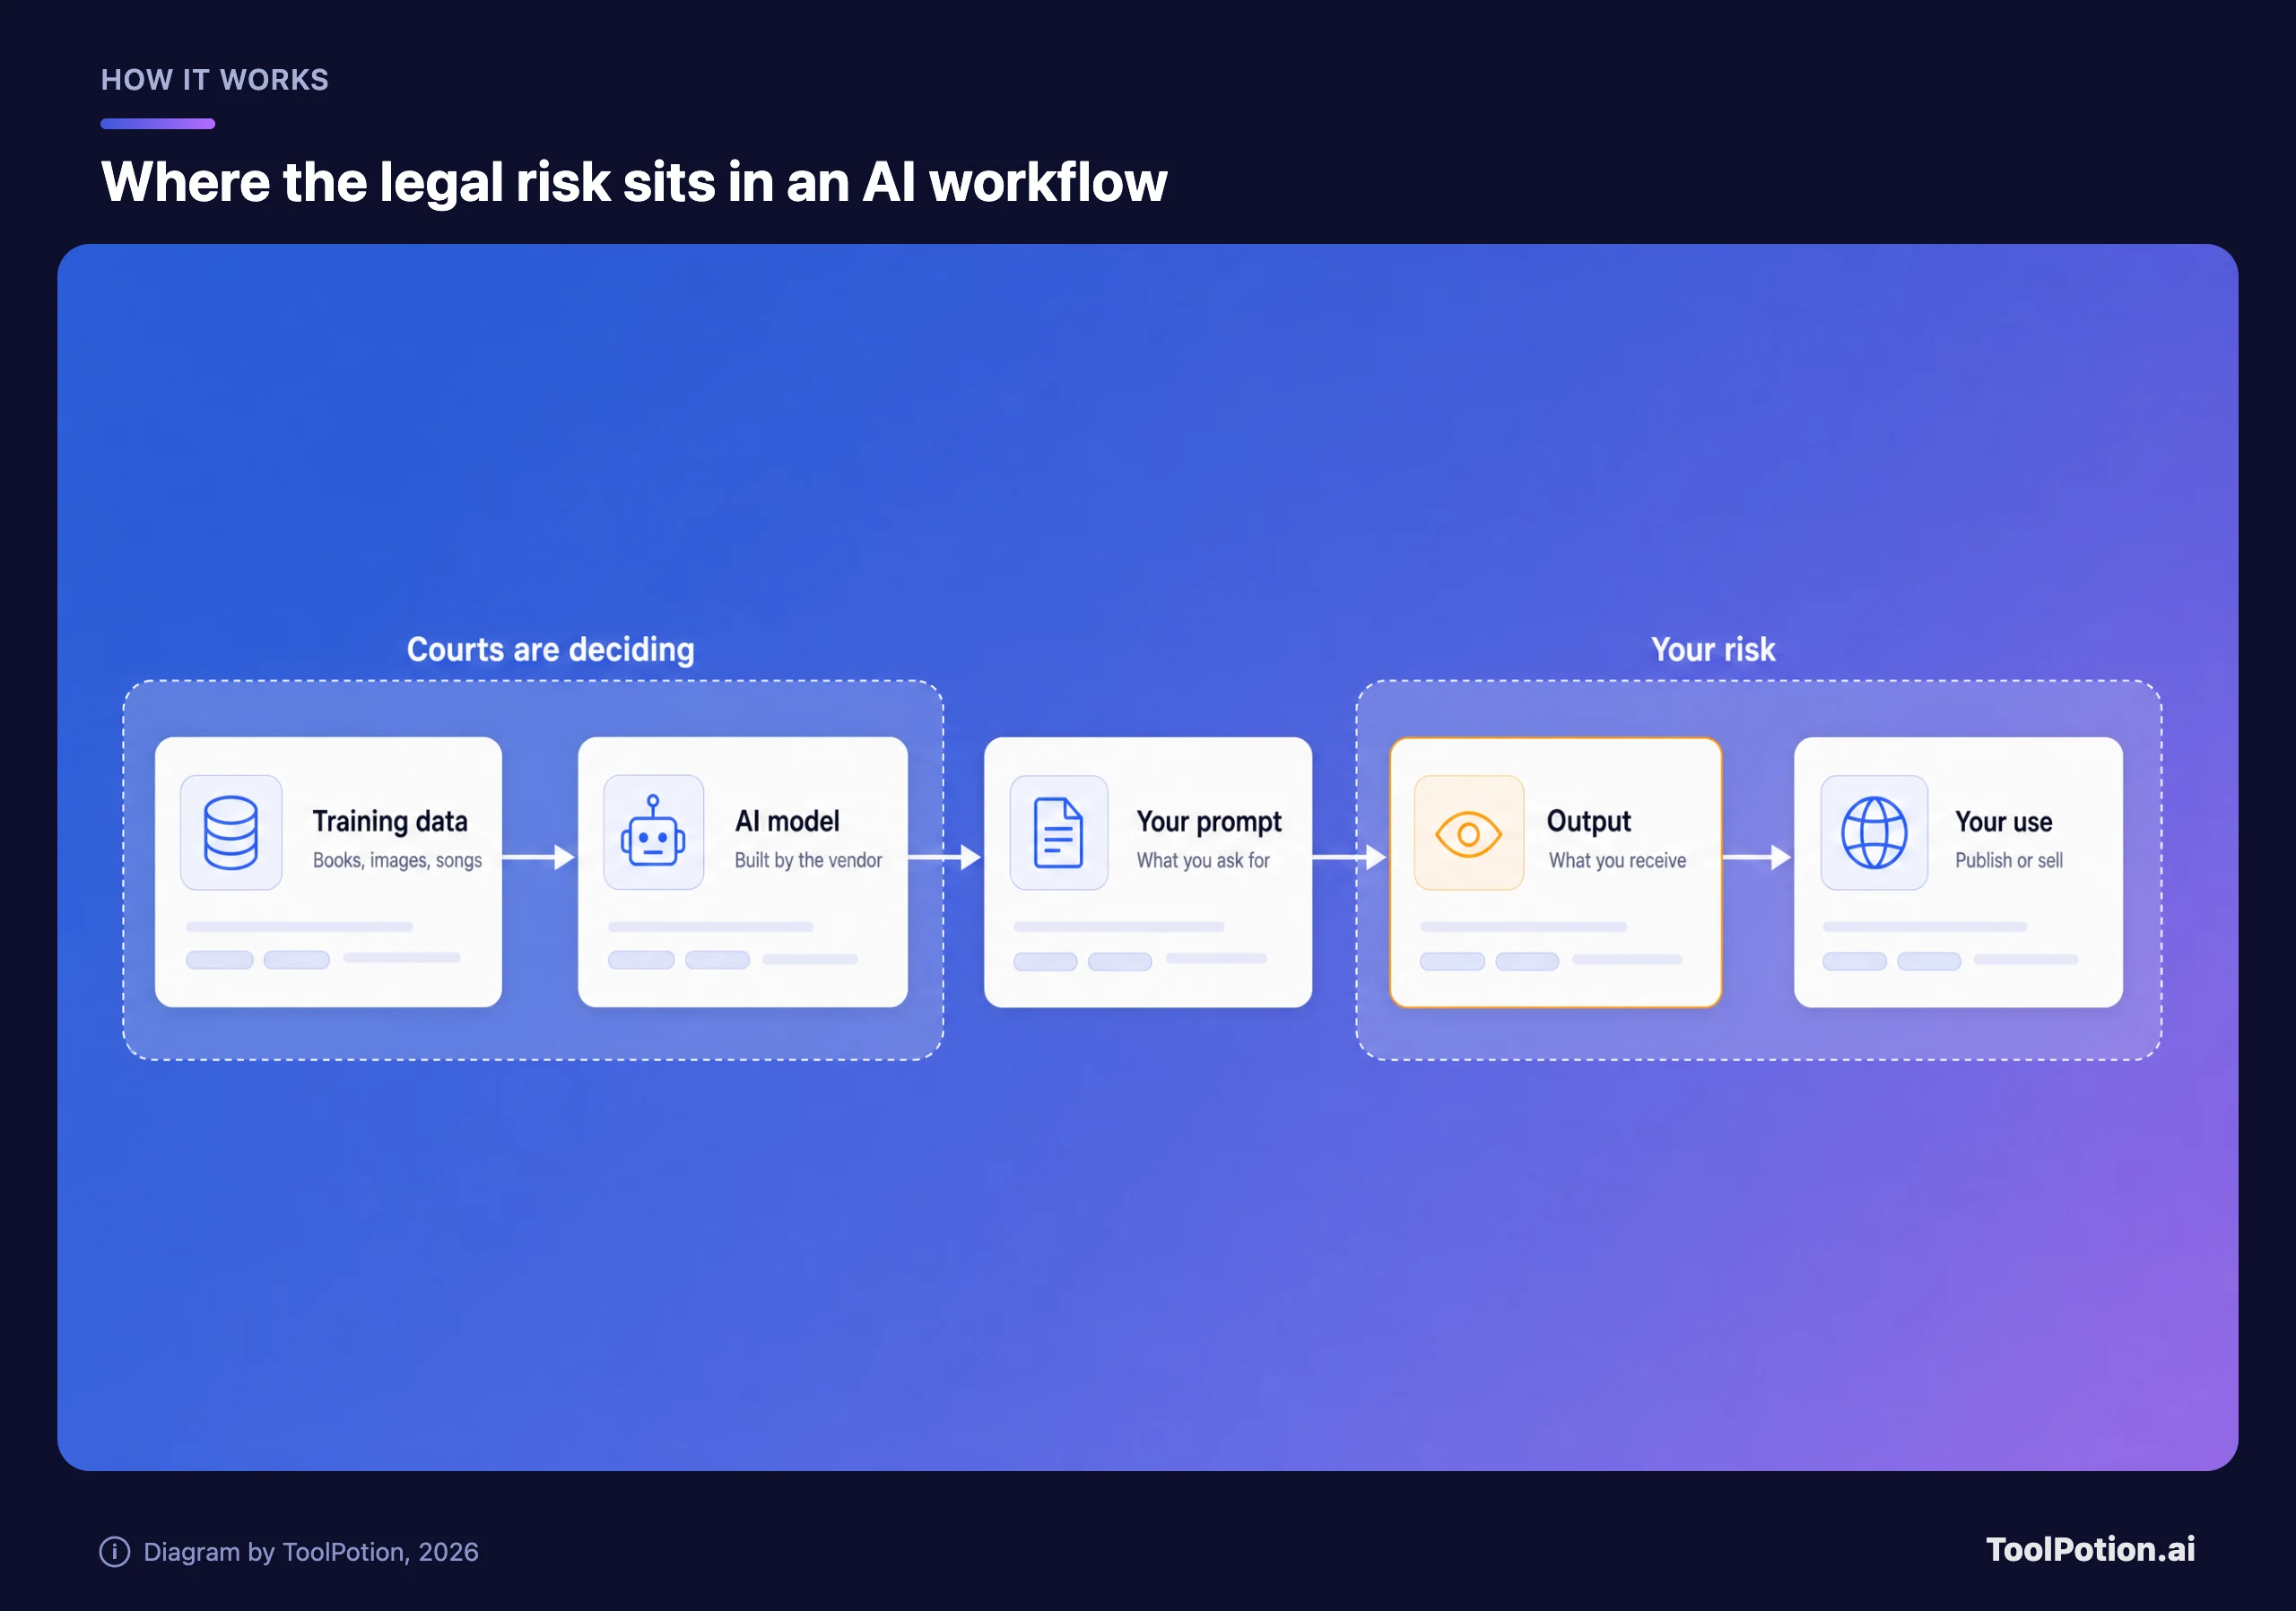
La zone de gauche est le problème des éditeurs, du moins tant qu'un tribunal ne dit pas le contraire. La zone de droite est la vôtre. Les procès visant des utilisateurs finaux sont rares, et ceux contre les entreprises d'IA reposent surtout sur des sorties qui reproduisent un personnage, une chanson ou un texte précis, soit la partie que vous maîtrisez avec vos prompts et votre relecture. Une image de paysage générique ou un premier jet d'article de blog n'ont rien à voir, côté risque, avec un morceau qui ressemble à celui d'un artiste sous contrat.
Ce que couvrent les garanties d'indemnisation des éditeurs, et ce qu'elles ne couvrent pas
Plusieurs éditeurs promettent de défendre leurs clients professionnels si quelqu'un porte plainte à cause d'un résultat généré. Ces promesses sont de vraies clauses contractuelles, et elles s'accompagnent toutes de conditions. Voici ce que disent les documents de chacun.
| Éditeur | Ce qu'il dit | Le piège |
|---|---|---|
| Anthropic | Défend les clients contre les réclamations de tiers en propriété intellectuelle liées à l'usage payant de ses services ou à leurs résultats (conditions) | Exclut les résultats modifiés, les combinaisons avec d'autres contenus, vos données d'entrée, le mauvais usage délibéré et l'usage d'un résultat comme marque dans le commerce |
| Microsoft | Customer Copyright Commitment : défend les clients contre certaines réclamations de propriété intellectuelle portant sur les résultats (Microsoft) | Les clients d'Azure OpenAI doivent maintenir les mesures d'atténuation requises, comme un metaprompt, des tests et des filtres de contenu protégé |
| Google Cloud | Annoncé en 2023 sous la forme de deux garanties distinctes, pour les données d'entraînement et pour les résultats générés. Google publie désormais une liste des services couverts (Google) | Ne couvre que les services d'IA générative listés (la page de Google a été modifiée pour la dernière fois en 2026), et les conditions s'appliquent. Vérifiez les conditions en vigueur |
| OpenAI | Conditions professionnelles : défend les clients contre les allégations de contrefaçon par les services (conditions) | Exclut les combinaisons, les modifications et le contenu du client ; renvoie aussi à une garantie distincte propre à chaque service |
Le schéma est le suivant : la couverture est en général réservée à l'usage payant, de niveau professionnel, de Claude, Microsoft Copilot, Google Gemini, des offres business de ChatGPT et de GitHub Copilot. La page de Microsoft indique que les offres GitHub n'exigent aucune mesure d'atténuation supplémentaire depuis le début de l'année, alors que Copilot Studio ne couvre pas les résultats de modèles externes, sauf s'ils tournent dans Azure OpenAI avec les paramètres requis. Un compte gratuit grand public n'est généralement couvert par rien de tout cela.
Les outils d'image communiquent différemment sur la sécurité. Adobe Firefly présente ses propres modèles comme « commercialement sûrs », et Generative AI by Getty Images est le produit d'un ayant droit lui-même. Ces arguments marketing portent sur les données d'entraînement. Savoir si un contrat vous protège aussi est une autre question : demandez le texte de la garantie d'indemnisation, pas la plaquette commerciale.
À qui appartient ce que produit l'IA
Le Copyright Office américain a réglé la question de principe en 2025. Son rapport sur la protégeabilité indique que les résultats d'une IA ne peuvent être protégés que lorsqu'un humain détermine les éléments expressifs. Utiliser l'IA comme un outil ne disqualifie pas une œuvre, mais des prompts seuls ne suffisent pas (US Copyright Office).
Les tribunaux sont du même avis. La cour d'appel du circuit de D.C. a jugé que le Copyright Office avait eu raison de refuser l'enregistrement d'une image créée de façon autonome par le système d'IA de Stephen Thaler, et la Cour suprême a refusé d'examiner son recours en 2026 (dossier de la Cour suprême, Chambers). Un refus d'examen n'est pas une décision sur le fond, mais il laisse en place la décision de la juridiction inférieure.
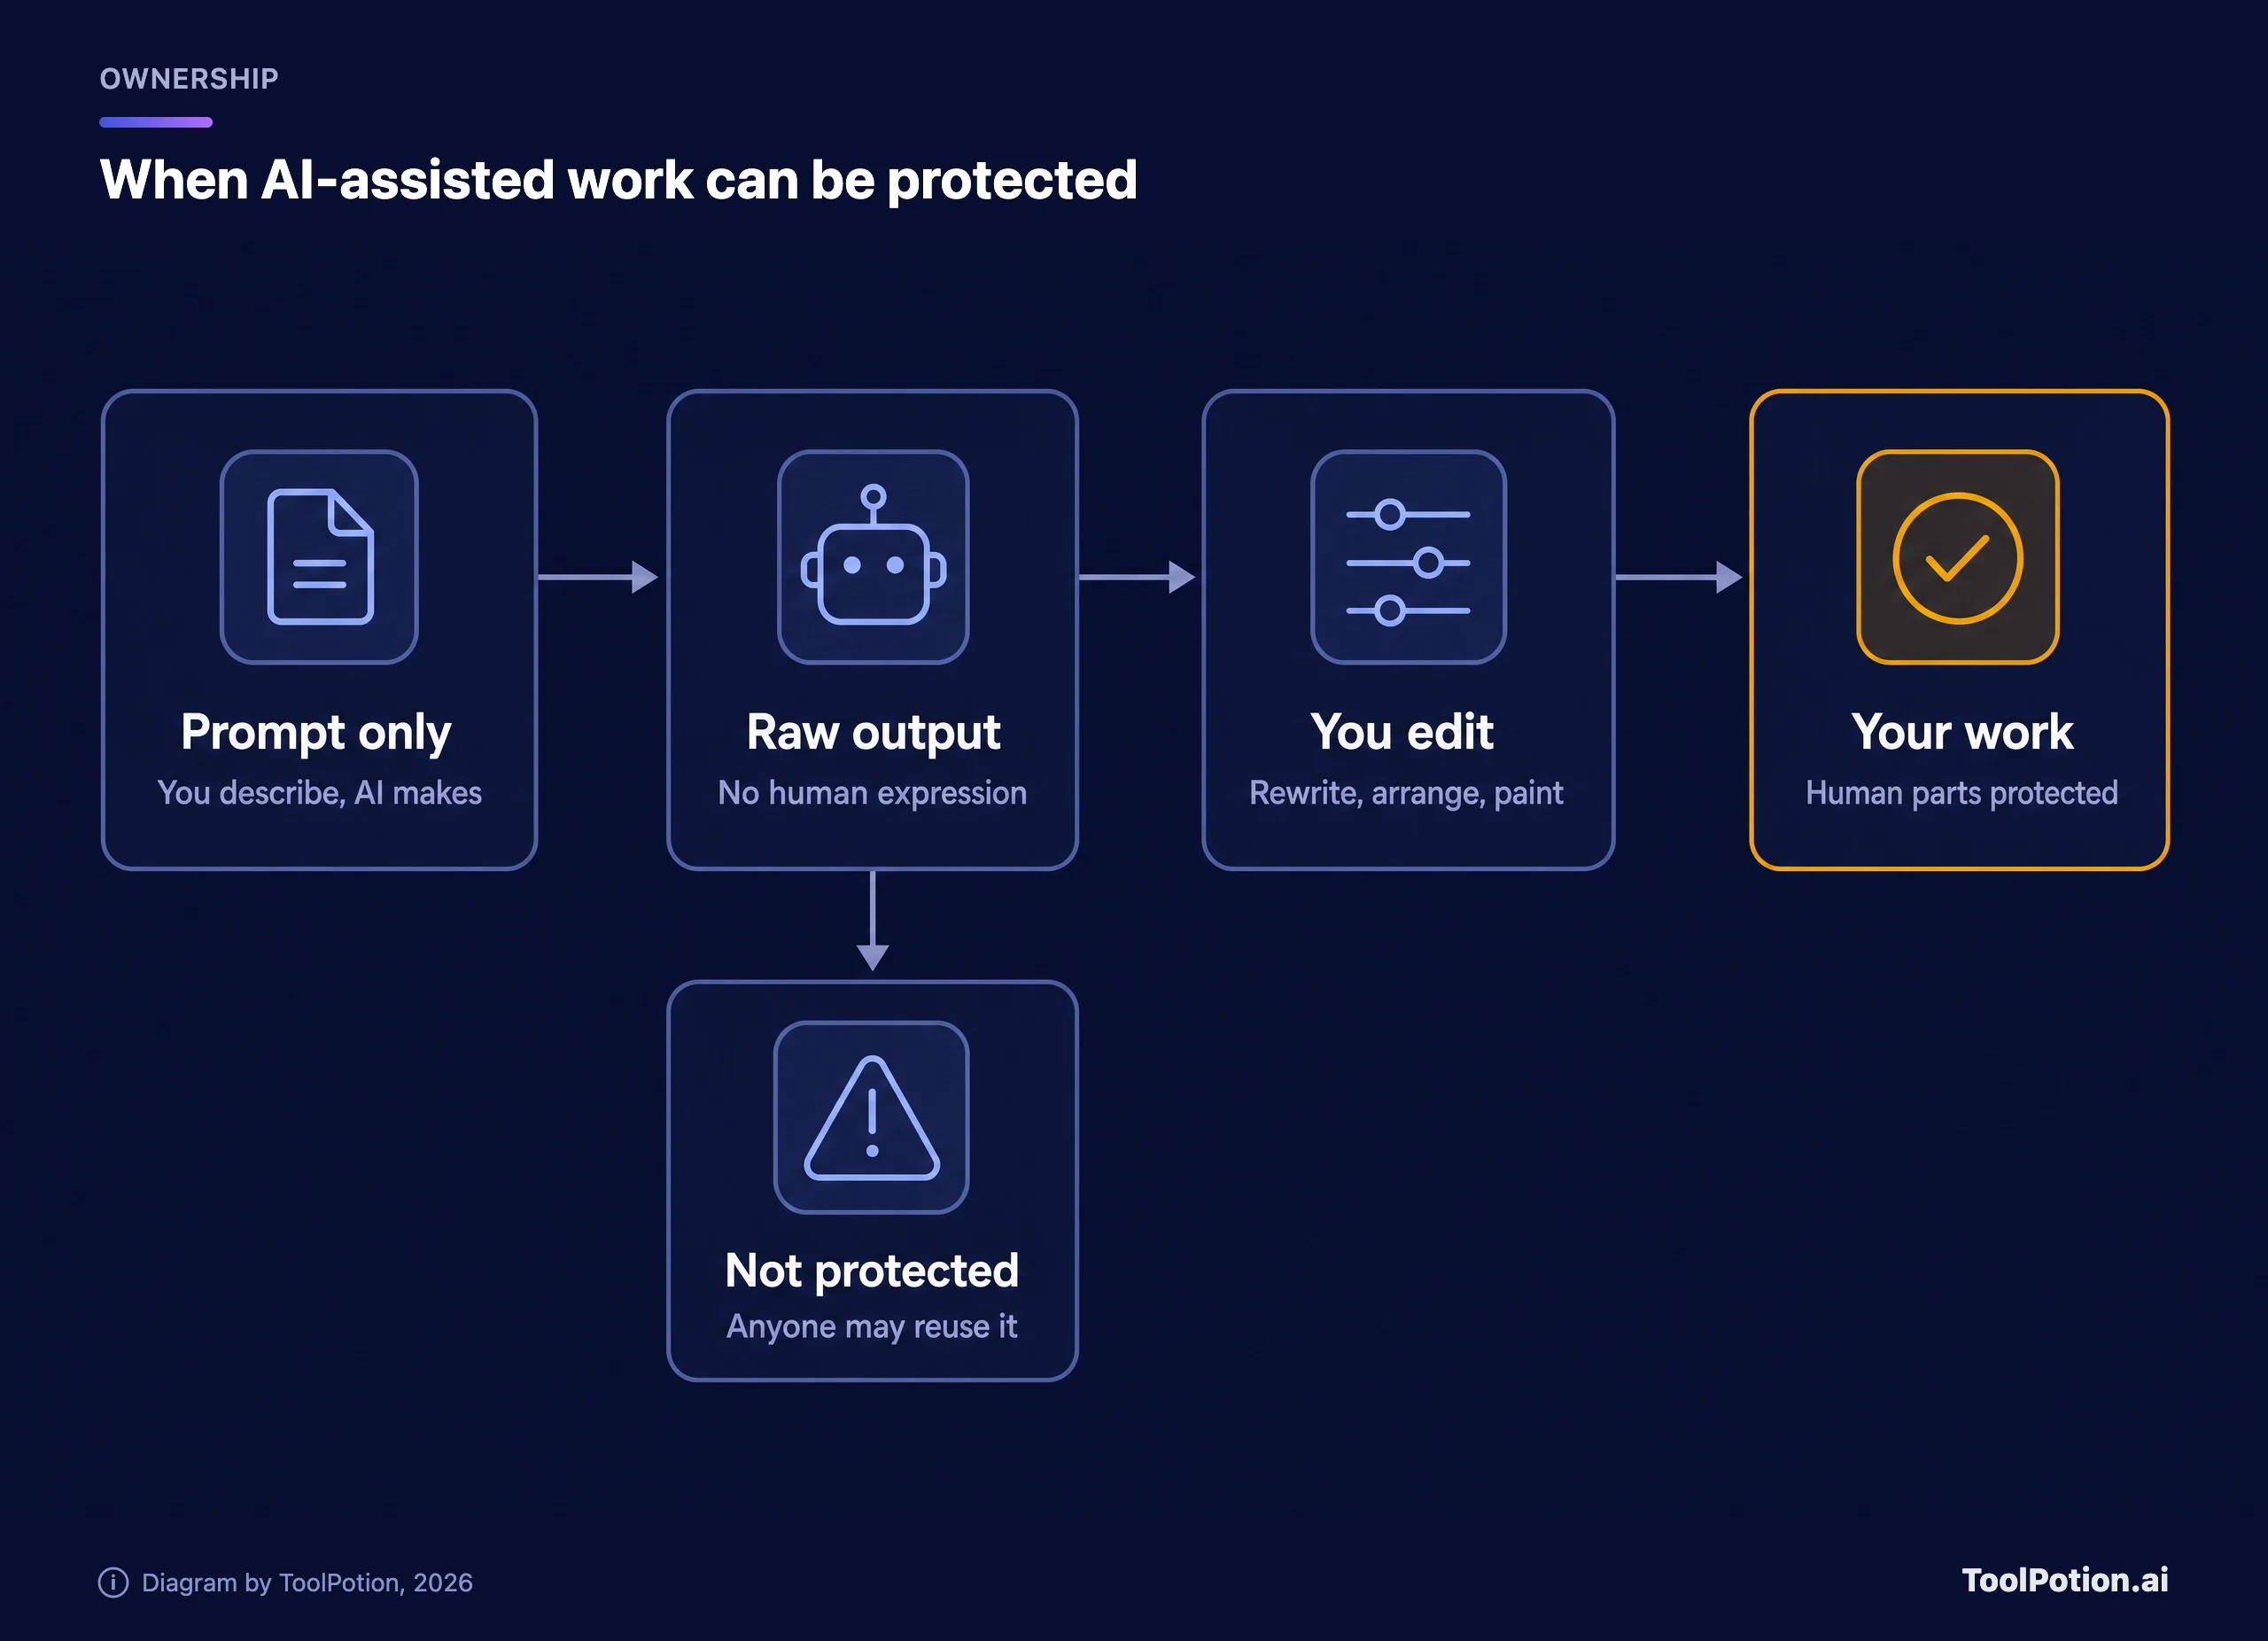
Concrètement, un résultat brut issu d'un seul prompt vous donne quelque chose que tout le monde peut copier. Si vous réécrivez le texte, retouchez l'image à la peinture ou sélectionnez et agencez plusieurs résultats pour en faire quelque chose de nouveau, vous pouvez revendiquer votre apport humain, pas celui de la machine. Gardez les brouillons et l'historique des modifications : ce sera votre preuve si on vous le demande.
Que faire dès aujourd'hui si vous utilisez des outils d'IA au travail
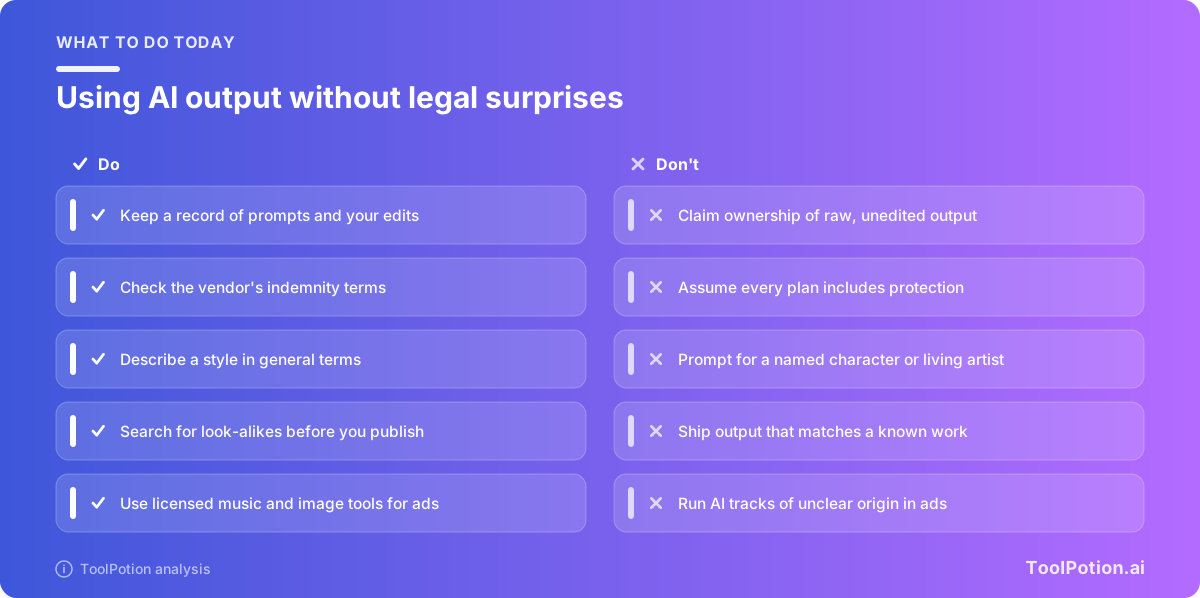
Rien de tout cela ne demande une équipe juridique. L'essentiel de la réduction des risques tient à des habitudes.
- Lisez les conditions d'indemnisation de votre éditeur et notez les exclusions, notamment pour les résultats modifiés et pour les outils que vous avez connectés vous-même.
- Ne mettez jamais un personnage nommé, une marque ou un artiste vivant dans un prompt destiné à un usage public. C'est là que se concentrent les procès des studios.
- Retouchez ce qui compte. Les modifications humaines renforcent votre droit de revendiquer la propriété du résultat et réduisent le risque de publier quelque chose qui copie.
- Avant une large diffusion, faites une vérification de ressemblance : recherche d'image inversée pour les images, recherche rapide des phrases distinctives pour le texte, et écoute attentive pour la musique.
- Pour les campagnes payantes, privilégiez les outils dont les données d'entraînement sont sous licence ou dont les conditions commerciales sont claires, et conservez la page de conditions sur laquelle vous vous êtes appuyé.
- Gardez les prompts et les brouillons des travaux importants.
Utilisez l'arbre ci-dessous pour situer un résultat précis sur l'échelle des risques.
Ensuite, évaluez les habitudes de votre équipe. La checklist n'offre aucune garantie juridique, mais elle montre quelle lacune corriger en premier.
Ce qui reste en suspens
Beaucoup de choses. Aucune cour d'appel n'a décidé si l'entraînement d'un modèle génératif sur des livres ou des articles protégés relève du fair use. L'affaire du Times pourrait produire la première grande décision, suivie d'un appel qui prendra des années. Le rapport du Copyright Office sur l'entraînement existe en version préliminaire, la version finale restant à venir. Les tribunaux britanniques, allemands et américains raisonnent différemment : un outil peut donc être sans problème sur un marché et exposé sur un autre.
Les accords cachent aussi des informations. Celui d'Anthropic a rapporté de l'argent aux auteurs mais n'a produit aucune décision sur la licéité de l'entraînement lui-même. Et les accords musicaux signifient que certains catalogues sont sous licence et d'autres non, sans mention sur le résultat qui vous dise lesquels.
Si vous construisez des produits sur des modèles d'IA ou vendez du contenu créé avec eux, la position raisonnable est de partir du principe que les règles vont continuer à bouger. Pour comparer les outils sur la qualité plutôt que sur leur situation juridique, les classements ToolPotion audio, voix et musique et éditeurs audio IA sont un bon point de départ, et le guide des alternatives à ChatGPT couvre le côté assistants.
Foire aux questions
Les entreprises d'IA ont-elles le droit d'entraîner leurs modèles sur des œuvres protégées ?
Pas encore tranché. Le troisième circuit a jugé que l'entraînement de Ross sur les headnotes de Westlaw ne relevait pas du fair use, mais Ross n'était pas un modèle génératif. Anthropic a versé 1,5 milliard de dollars pour des livres piratés sans qu'aucune décision ne porte sur l'entraînement lui-même. Les tribunaux hors des États-Unis, comme celui de Munich dans l'affaire Suno, appliquent d'autres règles.
Peut-on me poursuivre pour avoir utilisé des images ou des textes générés par IA ?
C'est possible, mais les poursuites contre de simples utilisateurs sont rares. Le risque augmente si le résultat copie une œuvre, un personnage ou une voix reconnaissable, ou si vous l'utilisez dans de la publicité. Les clients professionnels de certains éditeurs bénéficient d'une garantie d'indemnisation, vérifiez donc de quelle offre vous relevez.
À qui appartient le contenu généré par IA aux États-Unis ?
Vous pouvez détenir les parties créées par un humain, comme vos retouches, votre sélection et votre agencement. Le contenu purement généré par la machine n'est pas protégé, et la Cour suprême a refusé de revenir sur ce point en 2026. Les conditions des éditeurs vous cèdent généralement les droits qui existent, mais elles ne peuvent pas créer des droits que la loi n'accorde pas.
Suno est-il sûr pour de la musique commerciale ?
Lisez les conditions actuelles de Suno et les détails de votre offre avant d'utiliser un résultat dans un travail rémunéré. Suno dit avoir des partenariats avec Warner Music Group et BMG, et un tribunal de Munich a donné tort à Suno dans l'affaire GEMA en 2026 (Suno peut faire appel). Un résultat issu d'un catalogue sous licence n'est pas signalé comme tel.
Quand l'affaire du New York Times sera-t-elle jugée ?
Impossible à dire pour l'instant. L'affaire en est au jugement sommaire, et la partie qui perd peut faire appel, ce qui prend généralement beaucoup de temps. Considérez toute décision comme une étape plutôt que comme la fin.