Description
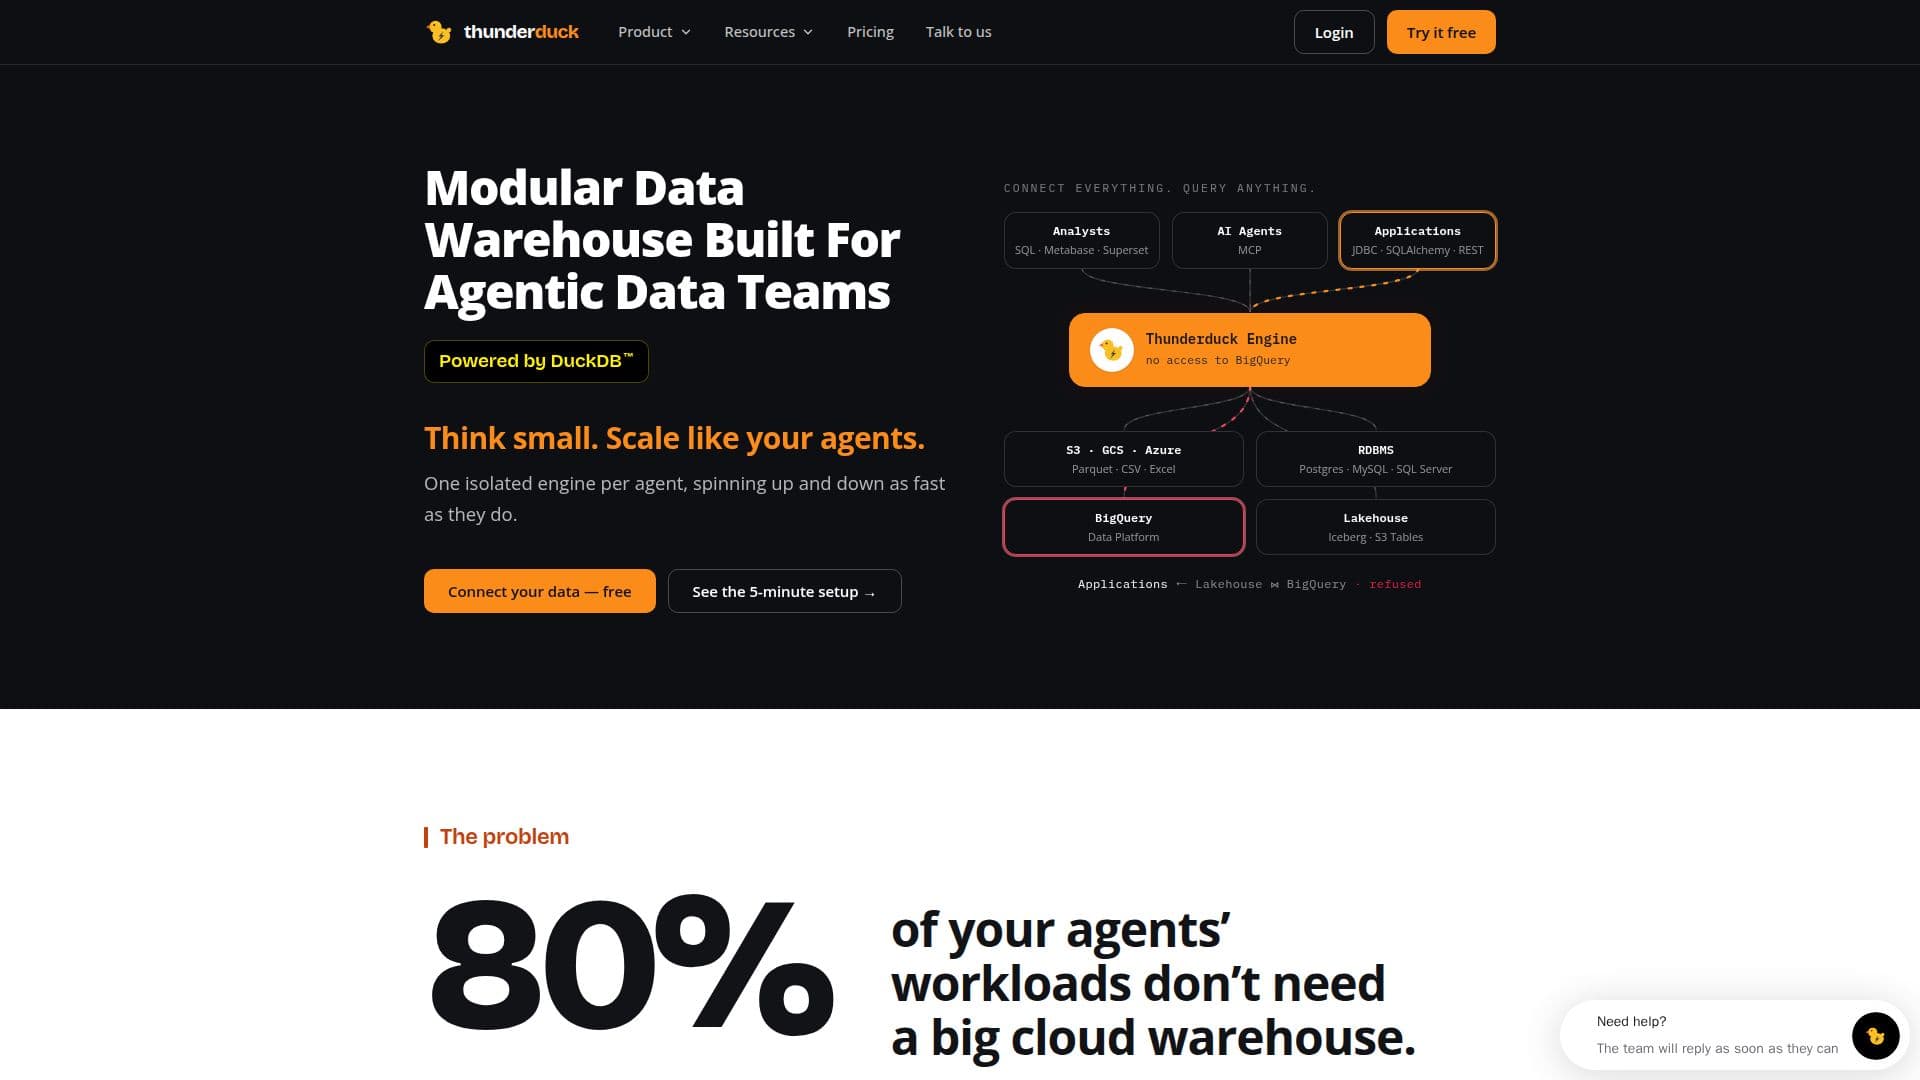
Thunderduck propose une solution d'entrepôt de données modulaire spécifiquement conçue pour les équipes de données agentiques, tirant parti de la puissance de DuckDB. Il répond au problème courant où 80 % des charges de travail des agents ne nécessitent pas un grand entrepôt cloud, mais où les équipes encourent des coûts significatifs liés aux systèmes distribués et aux primes de services gérés. En fournissant un moteur isolé par agent, Thunderduck permet aux moteurs de se lancer et de s'arrêter rapidement, s'adaptant à la nature dynamique des charges de travail agentiques.
Lire la suite
La plateforme est conçue pour fournir des requêtes en moins d'une seconde sur des téraoctets de données, quel que soit le nombre d'agents en cours d'exécution. Elle simplifie la construction de pipelines de données et automatise les tâches DevOps, tout en maintenant une gouvernance de niveau entreprise. Les utilisateurs ont la flexibilité de déployer Thunderduck n'importe où, que ce soit sur site avec une flexibilité semblable au cloud ou au sein de leur infrastructure cloud existante.
Au cœur de Thunderduck se trouve DuckDB, une base de données analytique open-source, en processus, avec un moteur vectorisé. Cette architecture signifie qu'elle fonctionne là où votre code fonctionne, éliminant ainsi le besoin de gestion de serveur. Elle prend en charge la multi-location et offre une sécurité de niveau entreprise, garantissant la souveraineté des données en maintenant les données dans le cloud ou le centre de données de l'utilisateur selon ses règles d'accès.
Thunderduck facilite l'intégration transparente avec des agents d'IA tels que Claude, ChatGPT ou Cursor via MCP. Les agents peuvent interpréter les significations des tables et des colonnes, pas seulement les noms, pour trouver les bonnes tables, lire les partitions et les index, et écrire des requêtes efficaces. Ces requêtes s'exécutent sous des rôles et des limites de coûts prédéfinis. La plateforme peut également automatiser la construction de modèles dbt, suivant les couches de médaillon, testant sur des branches et ouvrant des demandes de tirage pour maintenir des marts de données propres et gérables.
Elle prend en charge la fédération de requêtes sans ETL, permettant aux utilisateurs de joindre des données provenant de diverses sources telles que Postgres, BigQuery, des tables Iceberg et des fichiers dans une seule requête, avec des filtres appliqués à chaque source. Cela élimine le besoin de copies de données, de travaux de chargement ou de surveillance de synchronisation pour des données petites et ad hoc. Lorsque les ensembles de données augmentent ou nécessitent une modélisation, les utilisateurs peuvent construire des pipelines dbt dans Iceberg et continuer à les interroger de manière cohérente. Thunderduck fournit également une estimation des coûts pour chaque requête avant son exécution, permettant un contrôle budgétaire et évitant des dépenses inattendues.
- CatégorieOutils SQL et bases de données IA
- Modèle tarifaireFreemium
- DéploiementCloud, Sur site
- PlateformesWeb
Fonctionnalités principales de Thunderduck
Architecture d'entrepôt de données modulaire
Un moteur DuckDB isolé par agent
Requêtes en moins d'une seconde sur des téraoctets de données
Options de déploiement sur site ou dans le cloud
Tâches DevOps automatisées
Gouvernance de niveau entreprise
Support multi-locataire
Latence réduite sans surcharge distribuée
Souveraineté des données et règles d'accès
Intégration avec des agents d'IA (Claude, ChatGPT, Cursor) via MCP
Génération de requêtes assistée par IA et construction de modèles dbt
Fédération de requêtes à travers diverses sources (PostgreSQL, BigQuery, Iceberg, S3)
Découverte automatique de schémas, tables, colonnes et types
Estimation des coûts et du temps d'exécution pour chaque requête avant l'exécution
Diagnostic des requêtes échouées alimenté par IA et suggestions de corrections
Contrôle d'accès basé sur les rôles pour les catalogues
Mise en cache des requêtes pour des requêtes répétées instantanées et gratuites
Comment utiliser Thunderduck ?
Connecter un Catalogue : Fournissez des identifiants pour vos sources de données telles que bases de données, entrepôts, lakehouses ou stockage d'objets.
Découvrir des Données : Thunderduck lit automatiquement les schémas, tables, colonnes et infère les significations des colonnes, les maintenant à jour.
Interroger et Joindre : Adressez toute table sous le format catalog.schema.table et joignez des sources multiples dans une seule instruction SQL.
Intégrer des Agents IA : Connectez Claude, ChatGPT ou d'autres clients MCP pour permettre aux agents IA de parcourir les catalogues et d'exécuter des SQL.
Automatiser les Flux de Travail : Planifiez des instructions SQL selon un calendrier cron ou connectez des dépôts dbt pour exécuter des constructions, tests et instantanés.
Surveiller et Gouverner : Utilisez des estimations de coûts pré-requête, des journaux d'audit et un contrôle d'accès basé sur les rôles pour gérer l'utilisation et la sécurité.
Cas d'utilisation de Thunderduck
- Charges de Travail de Données Agentiques
- Optimisation des Coûts pour les Équipes de Données
- Analyse de Données en Temps Réel
- Automatisation des Pipelines de Données
- Souveraineté et Sécurité des Données
- Interrogation Assistée par IA
- Jointure de Données Multi-Sources
- Gestion Proactive des Coûts
- Gouvernance et Audit des Données
- Construction de Lakehouses