Description
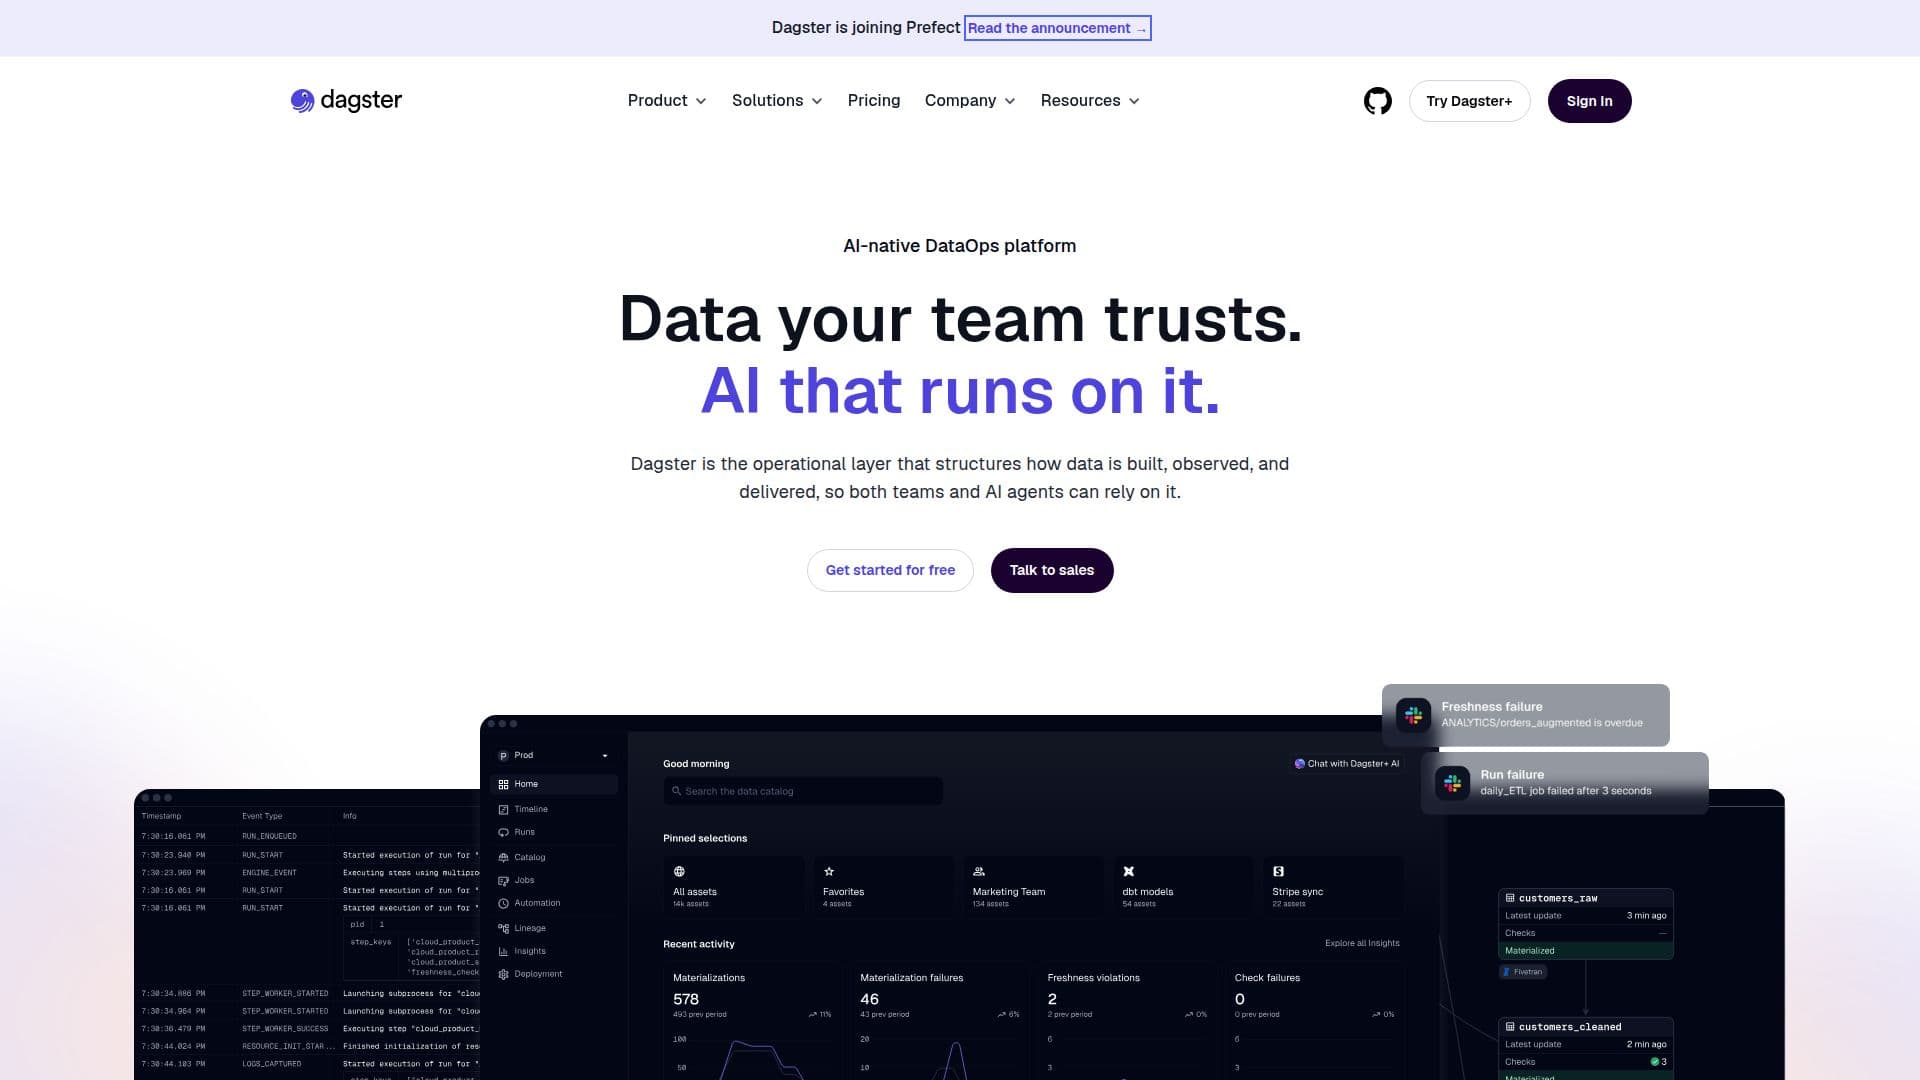
Dagster est une plateforme d'orchestration de données qui aide les ingénieurs à développer, produire et observer des actifs de données avec fiabilité et évolutivité. Elle agit comme la couche opérationnelle qui structure la manière dont les données sont construites, observées et livrées, permettant ainsi aux équipes et aux agents d'IA de s'y fier.
Lire la suite
La plateforme est basée sur des actifs : les ingénieurs construisent et exécutent des pipelines à travers n'importe quel outil de leur pile, et Dagster attache la traçabilité, les dépendances, les signaux de qualité et la santé des données à chaque actif. Cela donne aux équipes une visibilité de bout en bout afin qu'elles puissent détecter les problèmes tôt, comprendre leur impact instantanément et diagnostiquer les problèmes plus rapidement. Dagster rapporte des résultats clients tels que des données critiques pour l'entreprise plus fraîches, un onboarding des développeurs plus rapide et des temps d'exécution de pipelines réduits.
Dagster se positionne comme une plateforme DataOps native de l'IA, fonctionnant sur le contexte opérationnel qu'elle possède déjà, y compris les actifs, les exécutions, la traçabilité, la fraîcheur, les échecs et l'historique d'automatisation. Avec Compass, les équipes peuvent construire et expédier des agents de données gouvernés sur des flux de travail de données fiables, et des fonctionnalités comme les déploiements de branches permettent aux équipes de valider les modifications de pipelines dans un environnement similaire à la production avant de toucher aux données réelles.
- CatégorieMLOps et déploiement de modèles
- Modèle tarifaireFreemium
- DéploiementCloud
- PlateformesWeb
Fonctionnalités principales de Dagster
Orchestration de données basée sur des actifs à travers votre pile
Construire, planifier et surveiller des pipelines de données fiables
Traçabilité de bout en bout, dépendances et santé des données par actif
Observabilité pour détecter les problèmes tôt et évaluer l'impact
DataOps natif de l'IA avec contexte opérationnel pour les agents
Compass pour construire des agents de données gouvernés sur des flux de travail fiables
Déploiements de branches pour valider les changements avant la production
Composants réutilisables, normes partagées et garde-fous intégrés
Comment utiliser Dagster ?
Définir des actifs : Modélisez vos données en tant qu'actifs que Dagster orchestre.
Construire des pipelines : Connectez des outils à travers votre pile en pipelines basés sur des actifs.
Planifier et exécuter : Planifiez des pipelines et exécutez-les avec une visibilité complète.
Observer : Suivez la traçabilité, les dépendances, la fraîcheur et la santé des données pour chaque actif.
Itérer en toute sécurité : Utilisez des déploiements de branches pour valider les changements dans un environnement similaire à la production.
Cas d'utilisation de Dagster
- Orchestration de pipelines de données
- Observabilité des données
- Agents de données gouvernés
- Modifications de pipelines sécurisées