Description
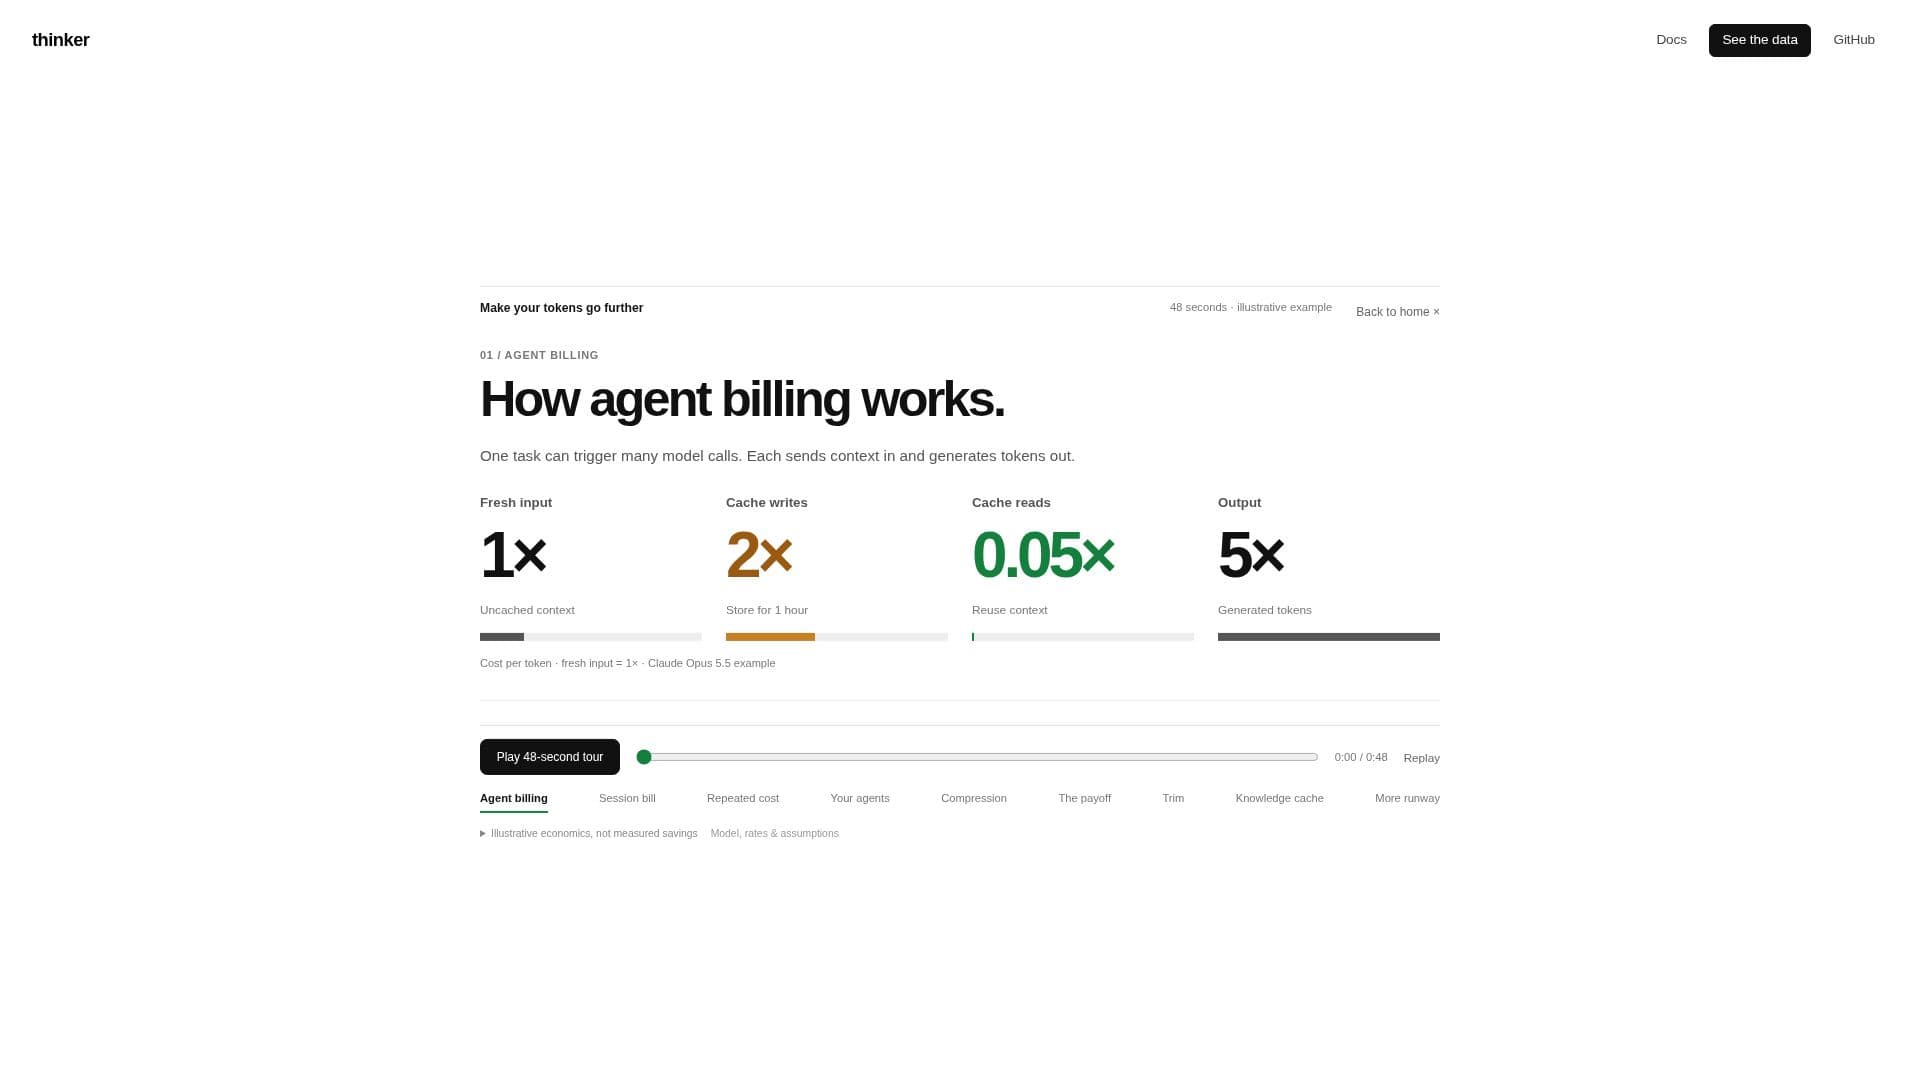
Thinker est un outil spécialisé conçu pour optimiser la performance et l'efficacité des coûts des agents IA en gérant intelligemment leur utilisation de tokens. Il aborde le défi commun des agents traitant à plusieurs reprises le même contexte, ce qui peut entraîner des coûts accrus et des opérations plus lentes. Thinker y parvient grâce à trois mécanismes principaux : la compression de contexte, la réduction d'instructions et un cache de connaissances.
Lire la suite
La compression de contexte identifie et supprime automatiquement les informations redondantes ou moins pertinentes du contexte d'un agent, garantissant que seules les données essentielles sont conservées pour les appels suivants. Cela réduit considérablement le nombre de tokens traités par appel, rendant les interactions des agents plus efficaces. Par exemple, il peut réduire les grandes sorties d'outils, ne conservant que les sections les plus pertinentes pour référence future.
La réduction d'instructions analyse les fichiers d'instructions et les paramètres des outils pour identifier et éliminer les instructions inutiles ou de faible utilité que les agents pourraient traiter à plusieurs reprises. En se concentrant sur les instructions qui méritent vraiment leur place, Thinker aide les agents à fonctionner avec un ensemble de directives plus léger et plus efficace, conservant ainsi davantage de tokens et améliorant la vitesse de traitement. Les utilisateurs peuvent examiner et appliquer les coupes suggérées, qui sont ensuite intégrées à la configuration de leur agent.
Le cache de connaissances permet aux agents d'apprendre et de réutiliser des informations, évitant ainsi la nécessité de retraiter les mêmes connaissances à plusieurs reprises. Lorsqu'un agent apprend une nouvelle information, elle peut être stockée sous forme de « note » (par exemple, règles, cartes, guides, comportements) et récupérée lorsque cela est pertinent. Ce cache est dynamique, apprenant de chaque session et sachant quand une note devient obsolète, garantissant que les agents ont toujours accès à des connaissances actuelles et pertinentes sans encourir de coûts de tokens répétés pour l'exploration.
Thinker prend en charge une gamme d'agents IA populaires, y compris Claude Code, Codex CLI, Gemini CLI, Cursor, Devin CLI, Pi, Windsurf Cascade, GitHub Copilot CLI et OpenCode. Il s'intègre en s'installant localement et en se connectant aux paramètres des agents, permettant un fonctionnement sans faille. La plateforme fournit des vues telles que « Trouver des économies » pour surveiller le coût et l'utilisation du contexte, « Voir le rapport » pour suivre les coûts de tokens au fil du temps, et « Activité récente » pour gérer les changements appliqués. Les économies illustratives de Thinker suggèrent des économies significatives en réduisant les nouvelles entrées, les nouvelles écritures et les tokens de sortie, prolongeant finalement la durée d'utilisation efficace des tâches des agents dans les limites de tokens existantes.
- CatégorieOutils d'ingénierie de prompts
- Modèle tarifairePayant
- DéploiementLocal
- PlateformesWeb
Fonctionnalités principales de Thinker
Compression de Contexte Automatique : Réduit le contexte répété dans les sessions des agents.
Réduction d'Instructions : Analyse et supprime les tokens d'instructions inutiles.
Cache de Connaissances : Stocke et réutilise les informations apprises pour éviter le retraitement.
Optimisation des Coûts de Tokens : Aide les agents à fonctionner plus efficacement dans les limites de tokens.
Intégration d'Agents : Se connecte à divers agents IA comme Claude Code, Codex, Gemini, Cursor, Devin, Pi, Copilot CLI, OpenCode.
Réduction de Sortie : Fonctionnalité optionnelle pour réduire les résultats des outils avant qu'ils n'entrent dans le contexte.
Rapport d'Utilisation : Fournit des informations sur le coût du contexte et l'utilisation des tokens au fil du temps.
Gestion des Changements : Suit et permet la gestion des coupes et des changements de contexte appliqués.
Stockage de Données Locales : Stocke les notes et la configuration localement sous ~/.thinker.
Intégration GitHub : Gère les changements d'instructions via des demandes de tirage pour révision.
Support Multi-Langue : Utilise le parseur tree-sitter pour Python, JavaScript, TypeScript, Go, Rust.
Apprentissage Configurable : Permet de contrôler la distillation et la vérification des sessions.
Contrôle de Télémétrie : Option pour désactiver l'envoi de métriques pour la confidentialité.
Types de Cache Multiples : Prend en charge différents types de cache pour les outils, les instructions, le contexte RAG et l'historique des conversations.
Gestion de l'Invalidation du Cache : Détaille quels changements invalident différents segments de cache.
Comment utiliser Thinker ?
Installer Thinker : Installez Thinker localement, ce qui configure sous ~/.thinker et se connecte aux paramètres de vos agents.
Analyser l'Utilisation : Thinker génère un rapport initial en lisant les sessions récentes de vos dépôts actifs.
Identifier les Économies : Utilisez la vue « Trouver des économies » pour voir le coût et l'utilisation du contexte, et identifier les domaines à réduire.
Appliquer la Compression de Contexte : Activez la compression de contexte automatique là où elle est prise en charge par votre agent.
Réduire les Instructions : Examinez les coupes d'instructions suggérées et appliquez-les pour réduire les tokens gaspillés.
Utiliser le Cache de Connaissances : Permettez à Thinker d'apprendre des sessions et de réutiliser les connaissances via des notes.
Surveiller la Performance : Utilisez « Voir le rapport » pour suivre les coûts de tokens et les économies de cache au fil du temps.
Gérer les Changements : Examinez et gérez tous les changements appliqués et leur statut sous « Activité récente ».
Cas d'utilisation de Thinker
- Optimisation de l'Utilisation des Tokens des Agents
- Réduction des Coûts pour les Agents IA
- Amélioration de l'Efficacité des Agents
- Gestion des Flux de Travail des Développeurs
- Gestion des Connaissances pour les Agents
- Débogage du Contexte des Agents
- Personnalisation des Instructions des Agents
- Extension des Limites d'Utilisation des Agents