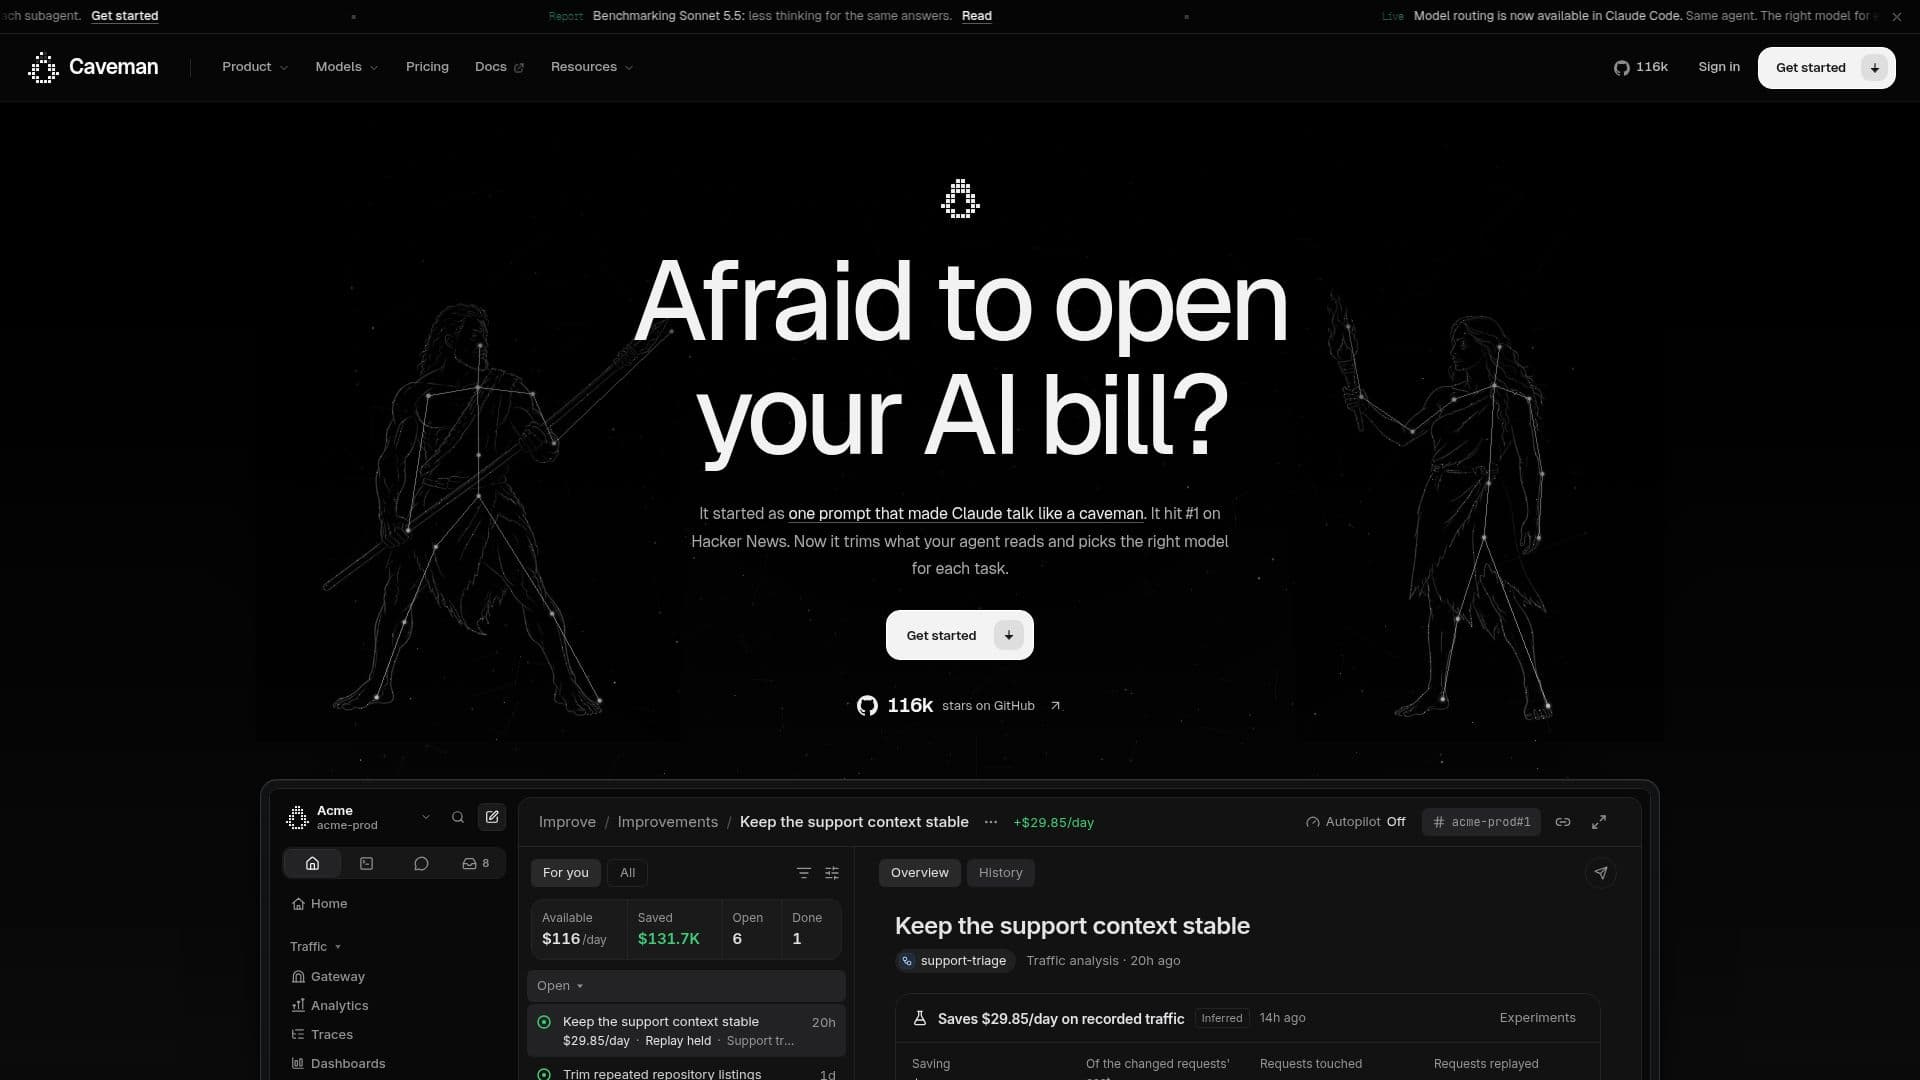
Description
Caveman fournit une solution complète pour les développeurs et les équipes cherchant à optimiser leurs interactions avec les agents IA et à réduire considérablement les coûts opérationnels. La plateforme propose une compression de contexte local, qui réduit les entrées éligibles telles que les journaux, les sorties de test, le JSON et les différences avant qu'elles n'atteignent le modèle, tout en gardant les données originales disponibles pour récupération. Ce processus peut entraîner des réductions substantielles des tokens d'entrée, avec des économies rapportées allant jusqu'à 33,2 % sur des sessions entières.
Lire la suite
Au-delà de l'optimisation des entrées, Caveman se concentre également sur l'efficacité des sorties en demandant des réponses plus courtes des agents. Cette fonctionnalité « Dit moins » aide à éliminer les mots de remplissage des réponses des agents, fournissant du code, des commandes et des erreurs byte pour byte. Cela peut entraîner jusqu'à 65 % de sortie moins lisible, ce qui se traduit par environ 10 % d'économies totales en tokens sur des tâches de codage à long terme.
Une capacité clé de Caveman est sa sélection de modèles adaptative, qui dirige intelligemment chaque tour d'agent vers le modèle le moins cher capable de réaliser la tâche correctement. Cela garantit que le travail difficile est toujours attribué à des modèles de pointe, tandis que les tâches plus simples exploitent des options plus rentables, réduisant potentiellement le coût par tâche de 0,46x. La plateforme s'intègre avec des agents de codage populaires tels que Claude Code, Codex et Gemini CLI, et propose des SDK pour les agents construits avec TypeScript et Python, y compris un middleware pour Vercel AI SDK, OpenAI, Anthropic et LangChain.
Caveman Cloud étend ces capacités avec des analyses avancées, fournissant une visibilité sur les coûts des agents, les traces de chaque demande et les dépenses de l'équipe. Il identifie le gaspillage, suggère des corrections et peut même mettre en œuvre des améliorations en mode Autopilot, les testant sur des données historiques avant déploiement. La plateforme comprend également des fonctionnalités de gouvernance telles que des plafonds de dépenses souples et stricts, des limites de taux et des garde-fous pour masquer ou bloquer des données sensibles, le tout enregistré dans un journal d'audit. Les outils de base (agent et SDK) sont gratuits et open-source, avec un niveau gratuit pour les services Cloud pour les développeurs individuels, et des plans payants pour les équipes et les entreprises offrant des fonctionnalités supplémentaires telles que le caching sémantique, le contrôle d'accès aux projets et le déploiement VPC.
- CatégorieOutils DevOps et cloud IA
- Modèle tarifaireFreemium
- DéploiementLocal, Cloud, VPC
- PlateformesTypeScript, Python
Fonctionnalités principales de Caveman
Compression de Contexte Local Récupérable
Réponses Plus Courtes des Agents IA
Sélection de Modèles Adaptative
Mesure de l'Utilisation des Tokens
Analytique des Coûts des Agents IA
Identification et Optimisation du Gaspillage
Autopilot pour Améliorations de Performance
Traçage des Demandes en Temps Réel
Visibilité des Dépenses d'Équipe
Gestion de Budget et Plafonds de Dépenses
Garde-fous pour Masquage/Bloquage de Données
Journal d'Audit pour Changements
Outils Locaux Open-Source
Middleware TypeScript et Python
Cache Sémantique
Comment utiliser Caveman ?
Installer les Outils Locaux : Utilisez le CLI ou le SDK pour intégrer Caveman avec votre agent de codage ou application existante.
Configurer la Compression : Implémentez la compression de contexte pour les journaux, JSON, différences et autres entrées afin de réduire l'utilisation des tokens.
Activer des Réponses Plus Courtes : Configurez les agents pour générer des réponses plus concises, réduisant ainsi les tokens de sortie.
Activer le Routage de Modèles : Configurez la sélection de modèles adaptative pour choisir automatiquement le modèle le plus rentable pour chaque tâche.
Surveiller les Coûts : Utilisez Caveman Cloud pour suivre les dépenses des agents, identifier les inefficacités et analyser la performance.
Mettre en Œuvre des Améliorations : Appliquez les corrections suggérées pour le gaspillage et exploitez Autopilot pour une optimisation automatisée.
Établir la Gouvernance : Fixez des limites de dépenses, des limites de taux et des garde-fous pour vos opérations d'agents IA.
Évaluer la Performance : Utilisez les outils d'évaluation intégrés pour tester les changements et mesurer le coût par tâche réussie.
Cas d'utilisation de Caveman
- Réduire les Coûts de l'API IA
- Optimiser la Performance des Agents de Codage
- Surveiller les Dépenses des Agents IA
- Automatiser les Économies de Coûts
- Améliorer la Gouvernance des Données
- Développer des Agents IA Efficaces
- Évaluer les Optimisations des Agents
- Gérer l'Utilisation des Agents IA par l'Équipe