Description
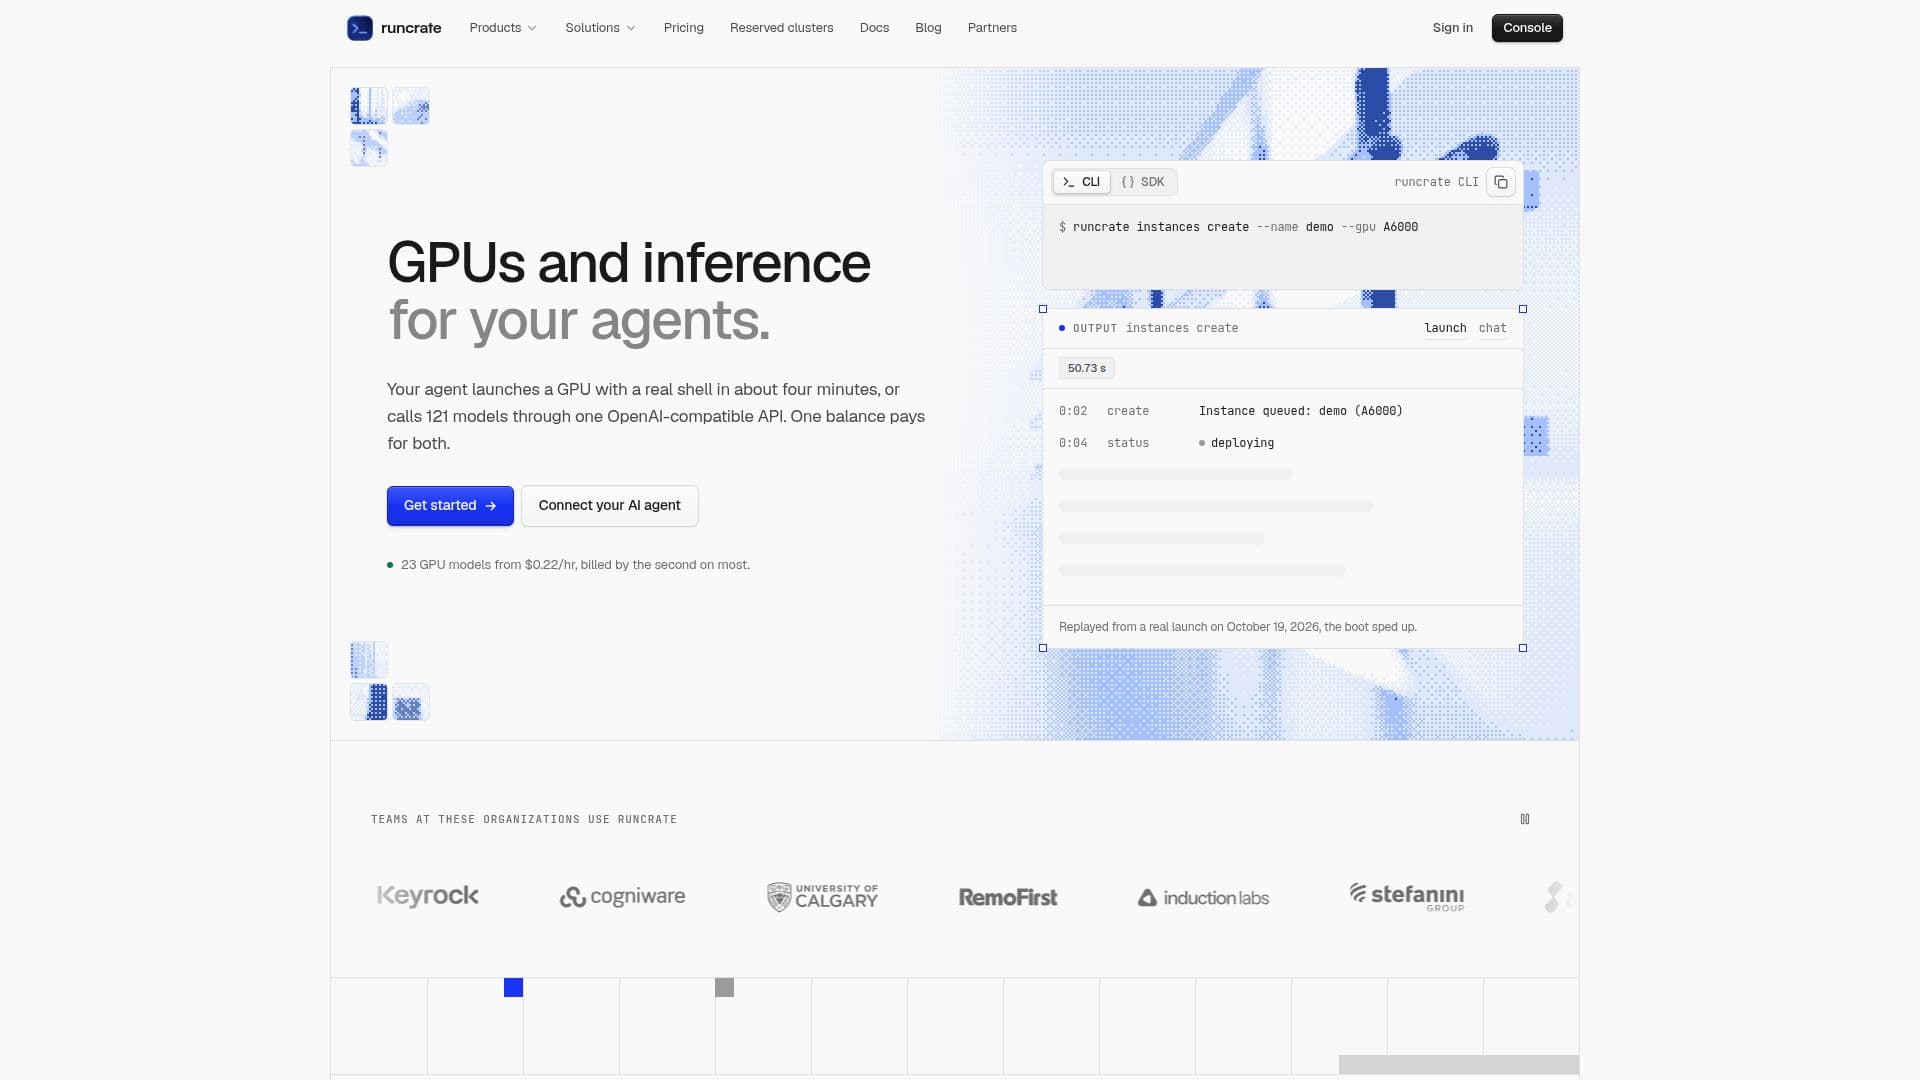
Runcrate, développé par Aeonmind, offre une infrastructure cloud IA complète conçue pour les équipes d'IA et d'apprentissage automatique. Il fournit un accès à la demande à des GPU puissants, y compris H100, H200, A100, L40S et RTX 4090, qui sont facturés à la seconde pour la plupart des modèles. Les instances de GPU peuvent être lancées et devenir opérationnelles en quelques minutes, éliminant ainsi les files d'attente d'approbation et les demandes de quota.
Lire la suite
La plateforme dispose également d'une API d'inférence compatible avec OpenAI, permettant aux utilisateurs d'appeler 121 modèles différents pour diverses tâches telles que la génération de texte, la vision, le traitement d'images, la vidéo, la parole, la transcription et les embeddings. Cette API unifiée simplifie l'intégration et l'utilisation des modèles, avec un seul solde couvrant à la fois l'utilisation des GPU et l'inférence des modèles.
Runcrate prend en charge un large éventail d'activités de développement IA. Les utilisateurs peuvent affiner des modèles ouverts comme Llama, Mistral ou Qwen avec leurs propres données en utilisant LoRA, servir des LLM open-source sur des GPU dédiés avec vLLM, et transcrire des fichiers audio et vidéo à grande échelle en utilisant l'API Whisper. La plateforme facilite également l'exécution de ComfyUI sur des instances RTX 4090 et le développement de pipelines RAG en intégrant des documents et en utilisant des modèles de chat pour les réponses.
Pour la persistance des données, Runcrate propose des volumes de stockage qui conservent le code, les données et les points de contrôle entre les instances, garantissant que le travail n'est pas perdu lorsque les GPU sont arrêtés. La facturation est précise, commençant uniquement lorsque l'instance est en cours d'exécution et généralement facturée à la seconde, sans frais pour le temps de démarrage. La plateforme s'intègre à des outils comme Claude Code, Codex et Cursor, permettant aux agents de lancer et de gérer des instances de GPU directement.
Le modèle de tarification de Runcrate comprend une facturation à la seconde pour les instances de GPU, une tarification par jeton pour les appels à l'API d'inférence, et des tarifs mensuels pour les volumes de stockage. Des options prépayées sont disponibles pour les GPU et l'inférence, et les utilisateurs peuvent réserver des clusters multi-nœuds pour des projets à long terme. La vision de l'entreprise est de rendre le développement IA moins coûteux et plus accessible en éliminant les goulets d'étranglement d'infrastructure et en promouvant des modèles ouverts.
- CatégoriePlateformes de machine learning
- Modèle tarifaireÀ l'usage
- DéploiementCloud
- PlateformesWeb
Fonctionnalités principales de Runcrate
Instances de GPU à la demande (H100, H200, A100, L40S, RTX 4090)
Facturation à la seconde pour la plupart des GPU
API d'inférence compatible avec OpenAI avec 121 modèles
Déploiement rapide d'instances de GPU (généralement en quelques minutes)
Support pour l'affinage des LLM (Llama, Mistral, Qwen) avec LoRA/QLoRA
Servir des LLM open-source sur des GPU dédiés avec vLLM
API Whisper pour la transcription audio et vidéo
Volumes de stockage pour des données persistantes entre les instances
Compte et solde unifiés pour tous les produits (GPU, inférence, stockage)
Intégration avec des agents IA et des outils de développement (Claude Code, Codex, Cursor)
Options prépayées et clusters réservés disponibles
Pas de facturation pendant le temps de démarrage du GPU
Accès à Jupyter et VS Code dans le navigateur
Images prêtes pour l'affinage et le service
Recharge automatique pour la gestion du seuil de crédit
Comment utiliser Runcrate ?
Connecter : Ajoutez Runcrate à votre outil préféré (Claude Code, Codex, Cursor ou terminal) avec une commande.
Se connecter : Approuvez l'accès via votre navigateur, sans avoir besoin de coller une clé.
Lancer GPU : Demandez à votre agent de lancer un GPU spécifique avec un crate souhaité, par exemple, « Lancer un H100 avec le crate Finetune. »
Configurer les ressources : Sélectionnez votre modèle de GPU et configurez les ressources nécessaires.
Déployer : Lancez l'instance ; la facturation commence lorsque l'instance de GPU est en cours d'exécution.
Gérer : Déployez, gérez et terminez les instances de GPU directement depuis le terminal ou les outils intégrés.
Utiliser : Utilisez le GPU pour l'entraînement, le service de modèles ou appelez des modèles via l'API compatible avec OpenAI.
Stocker des données : Conservez votre travail entre les instances en utilisant des volumes de stockage persistants.
Cas d'utilisation de Runcrate
- Entraînement de Modèles
- Inférence IA
- Affinage des LLM
- Pipelines RAG
- Opérations d'Agents IA
- Génération d'Images et de Vidéos
- Traitement de la Parole et de l'Audio
- Tâches de Vision par Ordinateur
- Traitement de Données
- Recherche et Expérimentations