Description
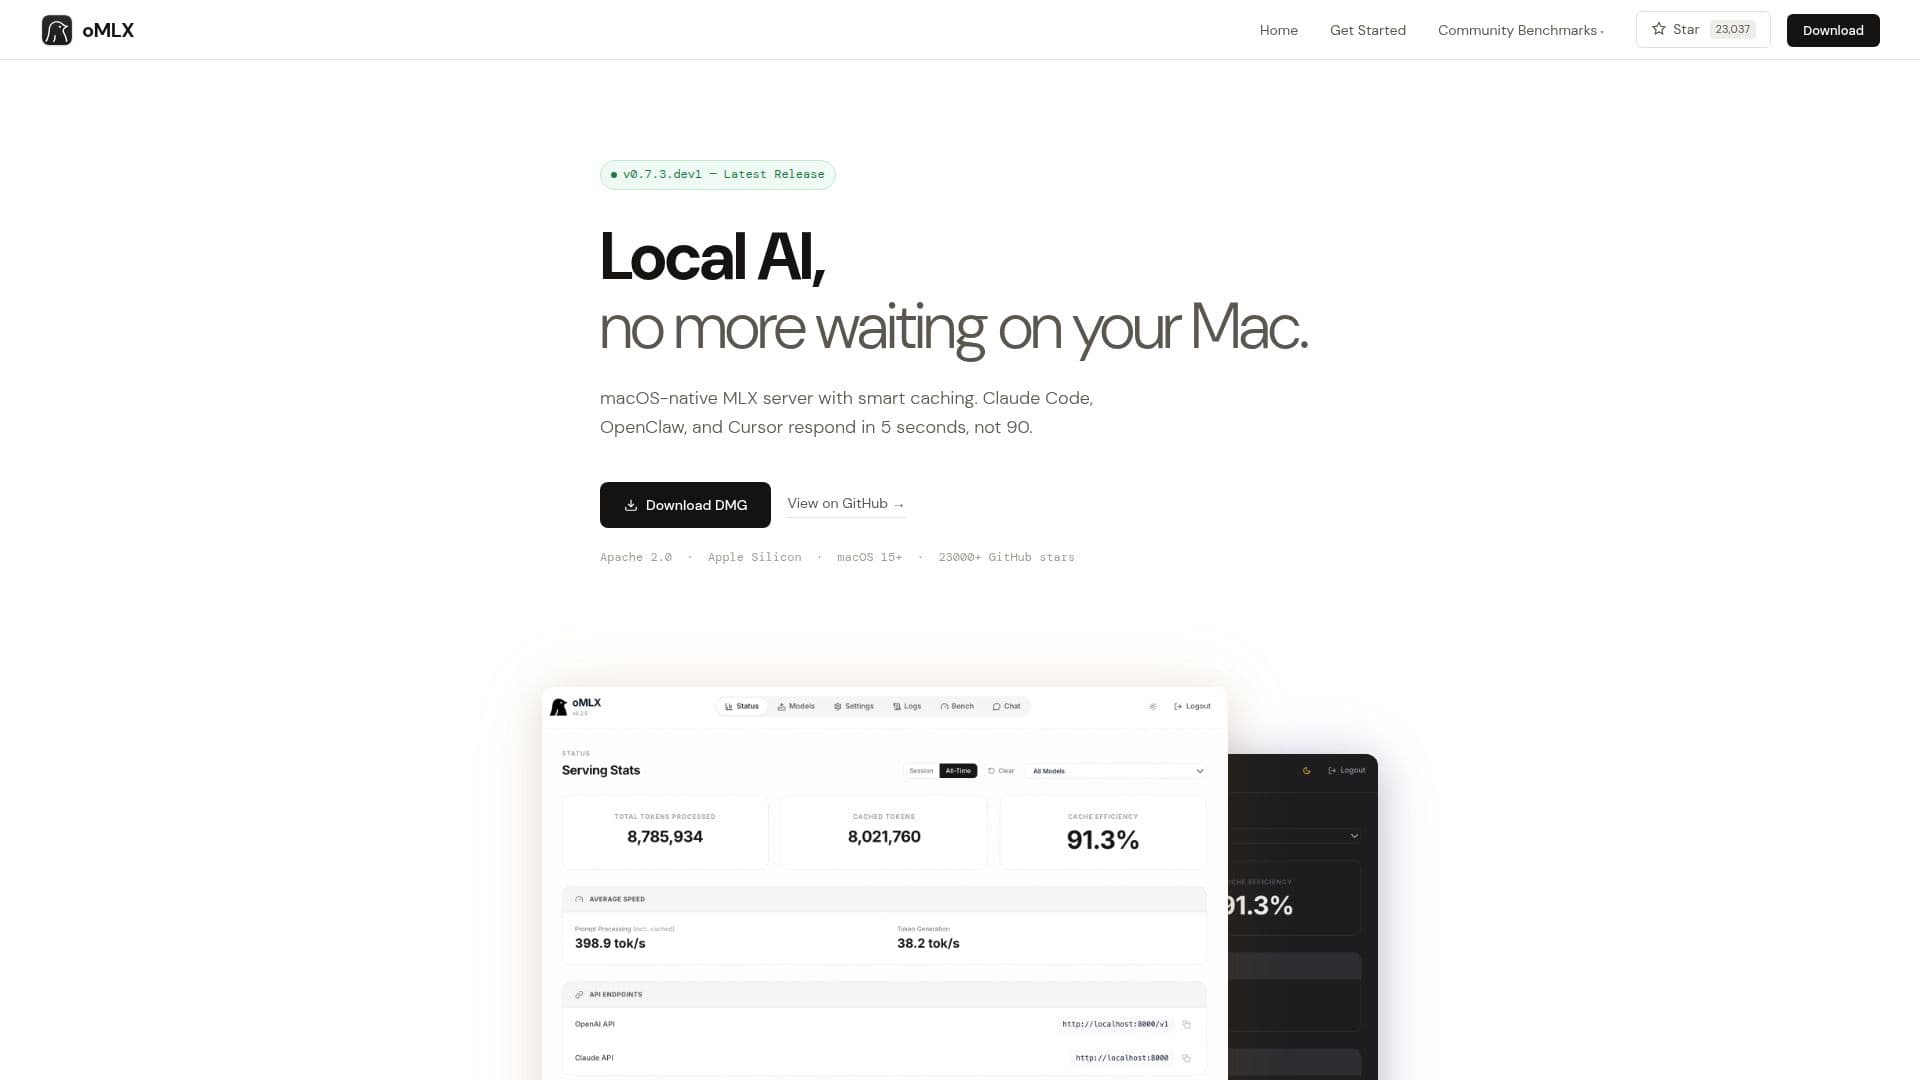
oMLX est un serveur d'inférence à la pointe de la technologie, conçu spécifiquement pour macOS, tirant parti de la puissance d'Apple Silicon. Basé sur le cadre MLX, il offre une solution native pour exécuter des modèles de langage de grande taille (LLMs) localement sur les ordinateurs Mac. L'une de ses caractéristiques remarquables est la mise en cache KV SSD paginée, qui réduit drastiquement le temps jusqu'au premier jeton (TTFT) d'un typique 30-90 secondes à moins de 5 secondes. Cette amélioration est particulièrement bénéfique pour les agents de codage qui invalident fréquemment le cache, car oMLX garantit que chaque bloc de cache est persistant sur SSD, permettant une restauration rapide depuis le disque.
Lire la suite
Le serveur est compatible avec des API populaires telles qu'OpenAI et Anthropic, ce qui en fait un outil polyvalent pour les développeurs travaillant avec ces plateformes. Il prend en charge le traitement par lots continu et fournit une API de remplacement pour des modèles comme Claude Code, OpenClaw et Cursor, garantissant que les réponses sont livrées en quelques secondes. Les benchmarks de performance réalisés sur un M3 Ultra avec 512 Go de RAM démontrent un débit impressionnant et une efficacité mémoire dans divers contextes et tailles de lot.
oMLX est conçu pour les développeurs et les passionnés d'IA qui nécessitent une solution d'IA locale fiable et rapide sur leurs Macs. Il élimine le besoin d'inférence basée sur le cloud, réduisant la latence et la dépendance à des serveurs externes. L'outil est open-source sous la licence Apache 2.0, avec une forte présence communautaire, comme en témoigne ses plus de 23 000 étoiles sur GitHub. Les utilisateurs peuvent facilement commencer en téléchargeant le DMG ou en installant depuis la source, avec une compatibilité pour les caches standard de Hugging Face et les dossiers LM Studio.
Dans l'ensemble, oMLX offre une solution robuste et efficace pour exécuter des modèles d'IA localement sur macOS, fournissant des améliorations de vitesse significatives et une intégration transparente avec les flux de travail d'IA existants.
- CatégorieMLOps et déploiement de modèles
- Modèle tarifaireOpen source
- DéploiementLocal
- PlateformesmacOS 15+
Fonctionnalités principales de oMLX
Serveur d'inférence natif macOS
Mise en cache KV SSD paginée
Compatibilité avec les API OpenAI et Anthropic
Support du traitement par lots continu
API de remplacement pour Claude Code, OpenClaw et Cursor
Restauration rapide du cache depuis le SSD
Open-source sous Apache 2.0
Plus de 23 000 étoiles sur GitHub
Comment utiliser oMLX ?
Télécharger : Obtenez le DMG ou la source
Installer : Suivez les instructions d'installation
Configurer : Configurez avec le cache Hugging Face
Utiliser : Exécutez des modèles avec un TTFT réduit
Optimiser : Profitez du traitement par lots continu
Cas d'utilisation de oMLX
- Développement IA local
- Intégration API
- Agents de codage
- Traitement par lots
- Contribution open-source