Description
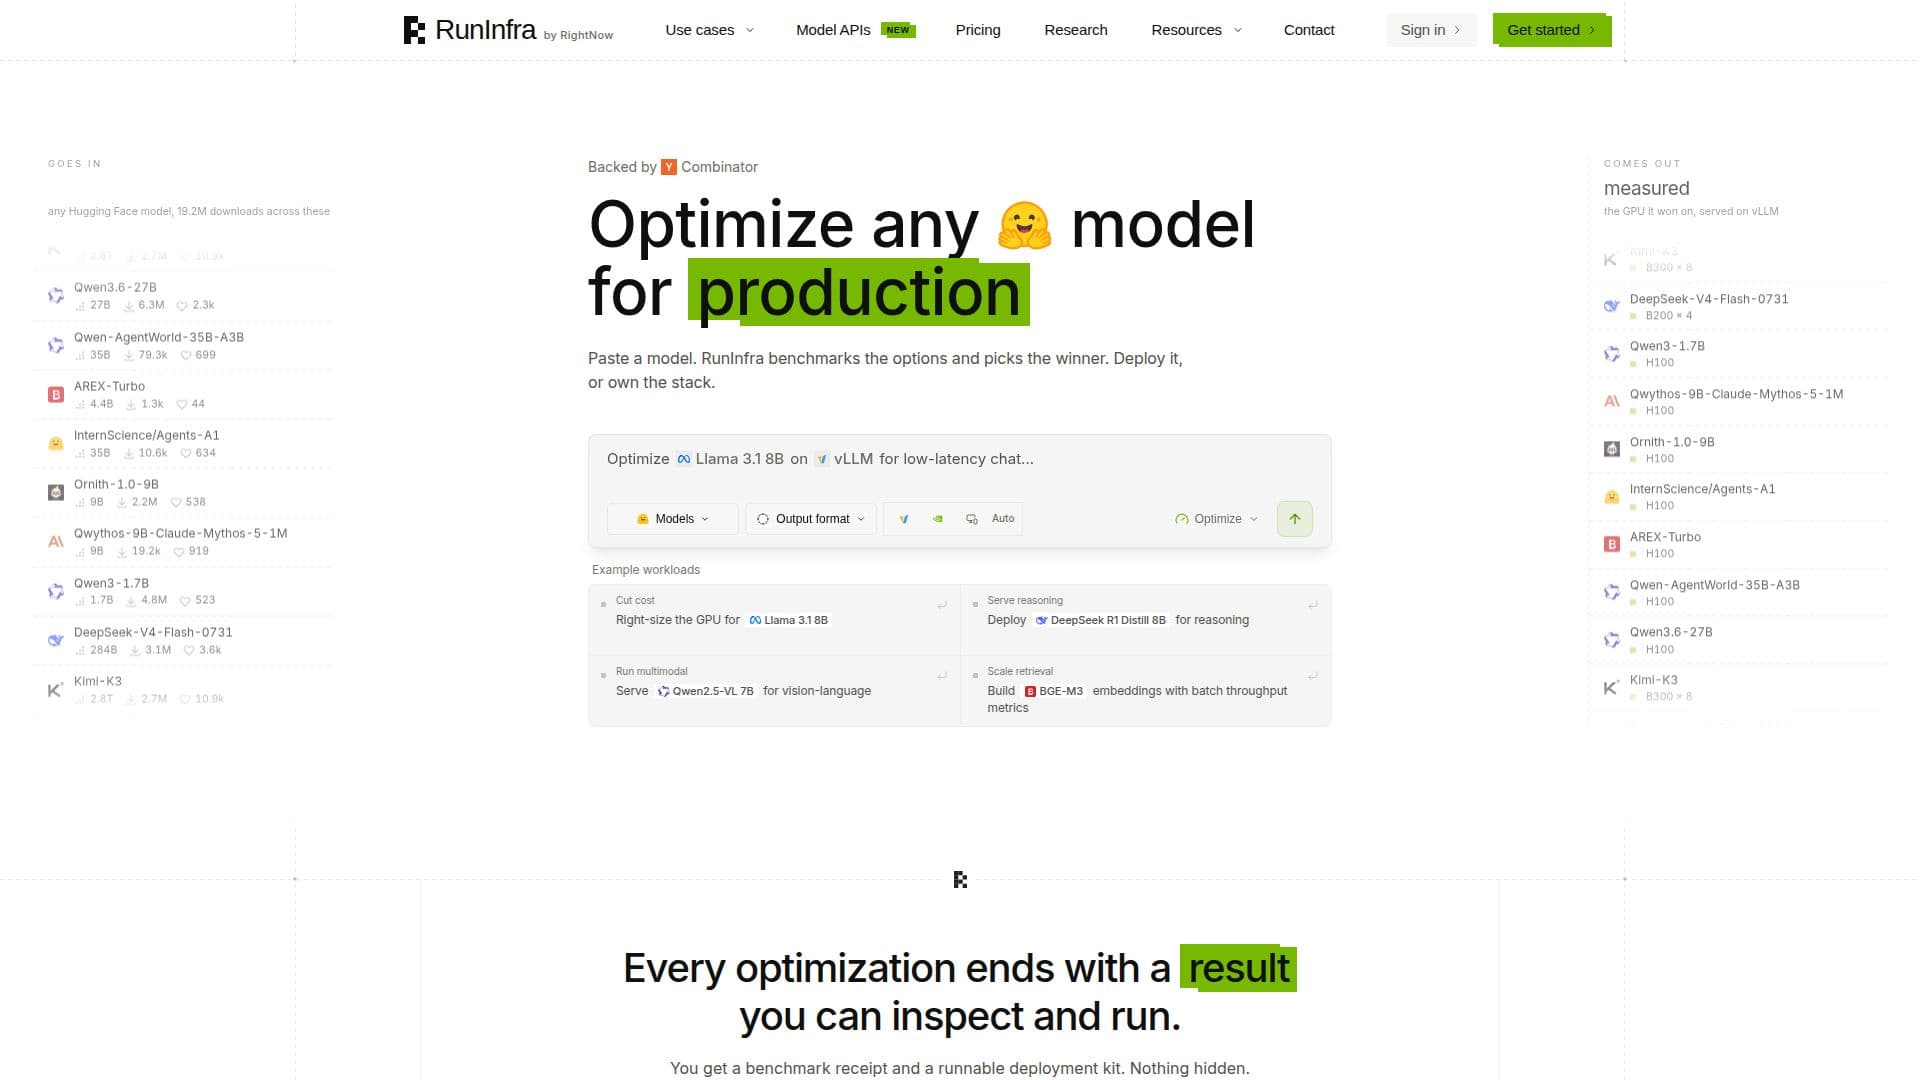
RunInfra permet aux développeurs d'appeler des modèles d'IA open-source via une API unique, compatible avec OpenAI et Anthropic, au lieu d'héberger et d'optimiser eux-mêmes l'infrastructure des modèles.
Lire la suite
RunInfra héberge une petite bibliothèque de modèles ouverts, y compris Nemotron 3.5 Lightning 30B, Qwen3.8 27B et Ornith 1.5 35B au moment de la rédaction, derrière une seule passerelle, accessible avec les SDK Python et Node d'OpenAI ou d'Anthropic en pointant l'URL de base vers l'API de RunInfra. Les requêtes sont facturées par jeton d'entrée et de sortie, avec un prix séparé et inférieur pour les jetons d'entrée mis en cache. Pour améliorer les taux de cache, RunInfra utilise un routage conscient des sessions : il maintient une session d'agent donnée fixée à la même réplique backend lors des appels répétés, de sorte que le contexte déjà chargé reste actif, plutôt que d'atterrir sur une réplique aléatoire à chaque fois. Les taux de réussite du cache sont mesurés et publiés par modèle, dépassant 95 % pour certains modèles dans une fenêtre récente de 24 heures, et les réussites sont facturées au tarif de cache, bien que la société décrive les réussites de cache comme un effort maximal.
Les capacités clés incluent une API de complétion de chat compatible avec OpenAI et Anthropic ; une tarification par modèle avec des benchmarks publiés sur les taux de réussite du cache et la vitesse de sortie ; l'appel d'outils, le mode JSON, le streaming et l'entrée d'image selon le modèle ; une interface en ligne de commande (CLI) qui connecte les modèles hébergés par RunInfra à des agents de codage tels que Claude Code, Codex, OpenCode, Cline, Droid et Grok Build ; et une option de demande de modèle pour les modèles encore non hébergés.
L'utilisation des modèles est facturée par jeton, par exemple 0,05 $ par 1M de jetons d'entrée et 0,15 $ par 1M de jetons de sortie pour un modèle hébergé, avec les entrées mises en cache facturées séparément à un tarif inférieur, aussi bas que 0,01 $ par 1M de jetons mis en cache. Les plans pour agents de codage commencent à 10 $ par mois.
En matière de sécurité, RunInfra déclare que ses API de modèles hébergés ne stockent pas les invites par défaut (zéro conservation des données), chiffre les données avec TLS en transit et AES-256 au repos, offre des espaces de travail avec des rôles et une sécurité au niveau des lignes, ne s'entraîne pas sur les invites ou les complétions des clients, et détient une attestation SOC 2 Type II.
RunInfra est conçu pour les développeurs et les équipes construisant des agents d'IA ou des flux de travail d'agents de codage qui souhaitent une inférence de modèles ouverts sans gérer leur propre infrastructure GPU ; la société, faisant partie de RightNow, est soutenue par Y Combinator. Sa bibliothèque de modèles hébergés est petite, trois modèles au moment de la recherche, bien qu'une option de demande de modèle existe pour les équipes qui ont besoin de quelque chose d'autre.
- CatégorieMLOps et déploiement de modèles
- Modèle tarifaireÀ l'usage
- DéploiementGéré et auto-hébergé
- PlateformesCloud
Fonctionnalités principales de RunInfra
Une clé API compatible avec les SDK OpenAI et Anthropic
Héberge des modèles ouverts, y compris Nemotron, Qwen et Ornith
Routage conscient des sessions qui maintient les appels répétés des agents sur la même réplique active
Tarification par modèle publiée, taux de réussite du cache et benchmarks de vitesse de sortie
Appel d'outils, mode JSON, streaming et support d'entrée d'image selon le modèle
Intégration CLI avec des agents de codage tels que Claude Code, Codex, OpenCode, Cline, Droid et Grok Build
Aucune conservation des invites par défaut, avec attestation SOC 2 Type II
Espaces de travail avec des rôles et une sécurité au niveau des lignes
Comment utiliser RunInfra ?
Obtenez une clé API : inscrivez-vous sur RunInfra et générez une clé API de passerelle
Pointez votre SDK vers RunInfra : définissez l'URL de base sur le point de terminaison de RunInfra dans le SDK OpenAI ou Anthropic
Choisissez un modèle : sélectionnez dans la bibliothèque de modèles hébergés en fonction des capacités et du prix
Appelez le modèle : envoyez des requêtes de complétion de chat en utilisant votre code SDK existant
Connectez des agents de codage : installez la CLI de RunInfra pour acheminer des agents comme Claude Code ou Cline vers des modèles hébergés par RunInfra
Surveillez les coûts et les réussites de cache : vérifiez les prix publiés et le taux de réussite du cache par modèle pour gérer les dépenses
Cas d'utilisation de RunInfra
- Accès API de modèles ouverts
- Inférence d'agent IA
- Backend d'agent de codage