Description
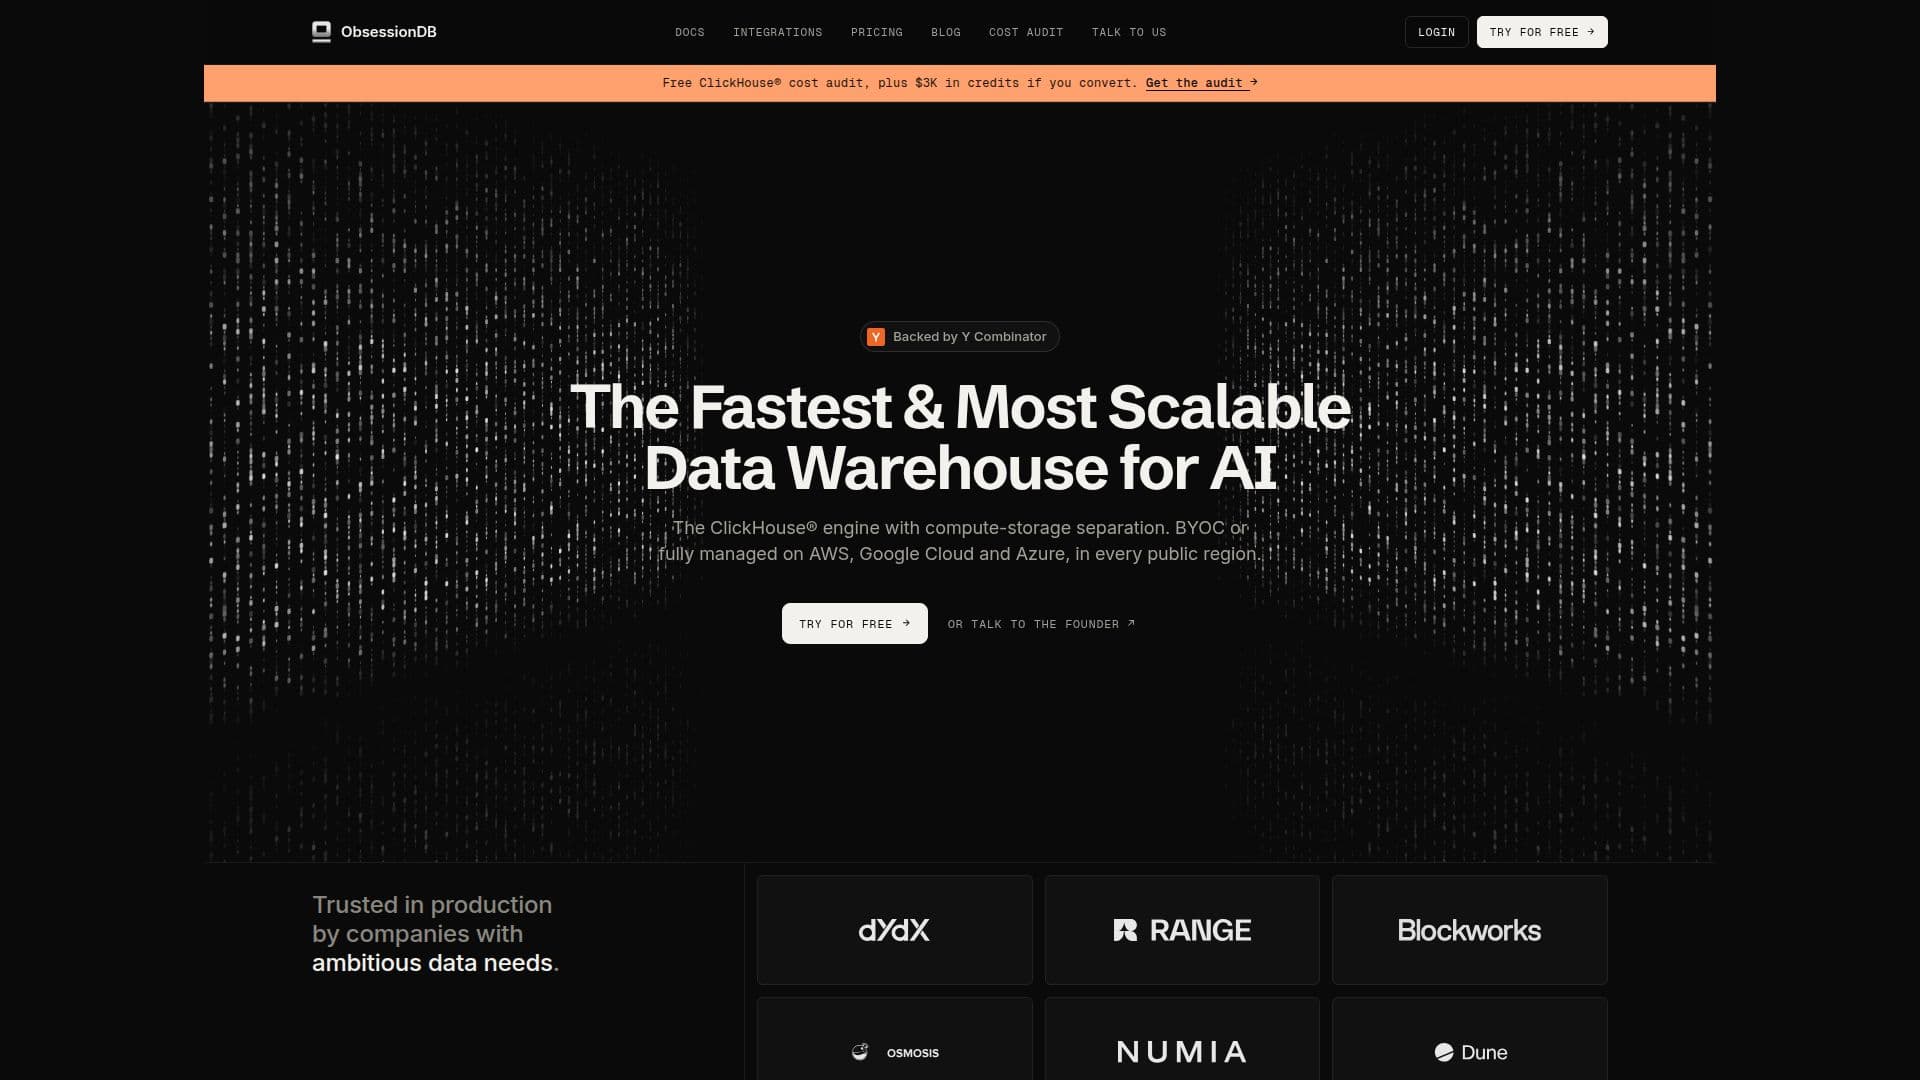
ObsessionDB propose un hébergement entièrement géré pour le logiciel ClickHouse, fournissant une solution d'entrepôt de données hautes performances et évolutive optimisée pour les charges de travail d'IA. Il fonctionne comme un remplacement direct pour les déploiements ClickHouse existants, garantissant la compatibilité avec les requêtes, intégrations et outils actuels sans modification. La plateforme est conçue pour offrir des performances supérieures et une efficacité économique, en particulier à mesure que les volumes de données augmentent, surpassant de nombreux fournisseurs à 100 To par rapport à leurs capacités de 1 To.
Lire la suite
Les utilisateurs ont la flexibilité de déployer ObsessionDB dans leur propre compte AWS ou Google Cloud (BYOC) ou sur leur propre matériel, l'équipe d'ObsessionDB gérant les opérations dans tous les scénarios. Ce modèle BYOC garantit que les données restent dans l'environnement cloud de l'utilisateur, leur permettant de conserver les remises d'infrastructure existantes tandis qu'ObsessionDB facture des frais annuels pour la licence, les opérations et le support. Alternativement, ObsessionDB peut fournir un hébergement entièrement géré sur AWS, Google Cloud et Azure dans chaque région publique.
Au cœur d'ObsessionDB se trouve le moteur ClickHouse officiel, mais la couche de stockage est reconstruite pour séparer le calcul et le stockage. Cette architecture propriétaire, avec le moteur SharedMergeTree, un anneau de cache NVMe distribué (Bunsen) et un routage de fusion et de lecture conscient de la localité (Affinity), permet aux données de résider sur un stockage d'objets tout en atteignant des vitesses de disque local. Ce design garantit que les nœuds de calcul sont sans état et interchangeables, permettant d'évoluer les lectures en ajoutant du calcul sans re-sharding ni rééquilibrage des données.
La plateforme est particulièrement bien adaptée aux charges de travail agentiques, qui impliquent une exploration parallèle incessante des données. ObsessionDB fournit un calcul isolé et en lecture seule pour les agents, les empêchant d'impacter le trafic de production. Elle garantit des vitesses de requête constantes même après des centaines de sondages, chaque action d'agent étant enregistrée pour la responsabilité. Le modèle de tarification pour les agents est basé sur les heures de calcul, et non par requête, encourageant une exploration extensive. De plus, CHKit offre aux agents des commandes structurées pour opérer la base de données, y compris le déploiement de schémas et de pipelines en tant que code, et permet des expérimentations en bac à sable avec des branches de données de production.
ObsessionDB est prêt pour l'entreprise, offrant des équipes de migration dédiées, des SLA d'entreprise avec des engagements de disponibilité, et des mécanismes de récupération robustes en cas de défaillance. La durabilité des données est assurée par le stockage des données de ligne dans S3, avec des capacités de récupération à un instant donné. Les fonctionnalités de sécurité incluent l'authentification unique (SSO), un contrôle d'accès granulaire jusqu'aux niveaux de table et de colonne, un réseau privé, un calcul dédié, et un chiffrement en transit et au repos. Une équipe d'assistance disponible 24/7 fournit un support expert pour les problèmes critiques.
- CatégorieOutils SQL et bases de données IA
- Modèle tarifaireBasé sur l'utilisation
- DéploiementCloud, BYOC, On-Premise
- PlateformesWeb
Fonctionnalités principales de ObsessionDB
Hébergement ClickHouse entièrement géré
Déploiement BYOC (Bring Your Own Cloud) sur AWS, Google Cloud, Azure ou matériel propre
Séparation calcul-stockage avec le moteur ClickHouse
Optimisé pour les charges de travail d'IA agentique
Anneau de cache NVMe distribué (Bunsen)
Routage de fusion et de lecture conscient de la localité (Affinity)
Calcul isolé et en lecture seule pour les agents d'IA
Pas de frais par requête pour les charges de travail des agents
CHKit pour les opérations de base de données des agents et le déploiement de schémas
Environnements de bac à sable par agent pour l'expérimentation
Équipe d'ingénierie de migration dédiée
SLA d'entreprise et engagements de disponibilité
Récupération à un instant donné
Authentification unique (SSO) et contrôle d'accès granulaire
Réseautage privé et calcul dédié
Support disponible 24/7
Comment utiliser ObsessionDB ?
Explorer les fonctionnalités : Consultez le site Web d'ObsessionDB pour comprendre ses capacités, son architecture et comment il diffère des déploiements ClickHouse standard.
Calculer les coûts : Utilisez le calculateur de prix en ligne pour estimer les coûts mensuels en fonction de vos besoins en stockage, mémoire et nœuds, en le comparant à d'autres solutions ClickHouse gérées.
Commencer avec le niveau gratuit : Lancez une instance développeur gratuite pour tester vos charges de travail et essayer un cluster de taille petite à moyenne.
Contacter les ventes : Pour les déploiements BYOC, les devis personnalisés ou les charges de travail plus lourdes, contactez l'équipe commerciale pour discuter d'une preuve de concept.
Migrer des données : Engagez l'équipe de migration dédiée pour planifier et exécuter la migration de vos charges de travail ClickHouse existantes vers ObsessionDB.
Connecter des outils : Intégrez ObsessionDB avec vos pilotes de langage existants, outils BI, plateformes d'ingestion en streaming et agents d'IA en utilisant les guides fournis et les protocoles ClickHouse standard.
Surveiller les performances : Utilisez le tableau de bord de surveillance intégré pour suivre les performances des requêtes, les erreurs, le stockage et les ressources, ou interrogez directement la surface d'observabilité brute.
Évoluer les ressources : Redimensionnez votre cluster à tout moment en ajoutant ou en supprimant des nœuds, en changeant la taille du calcul ou en ajustant le stockage pour répondre aux demandes évolutives des charges de travail.
Cas d'utilisation de ObsessionDB
- Entrepôt de données haute performance
- Charges de travail des agents d'IA
- Analytique en temps réel
- Déploiement ClickHouse optimisé en coût
- Gestion des données BYOC
- Ingestion de données et ETL
- Tableaux de bord d'intelligence d'affaires
- Analyse des journaux et des métriques
- Déploiement de schémas et de pipelines
- Environnements de données sécurisés