Descripción
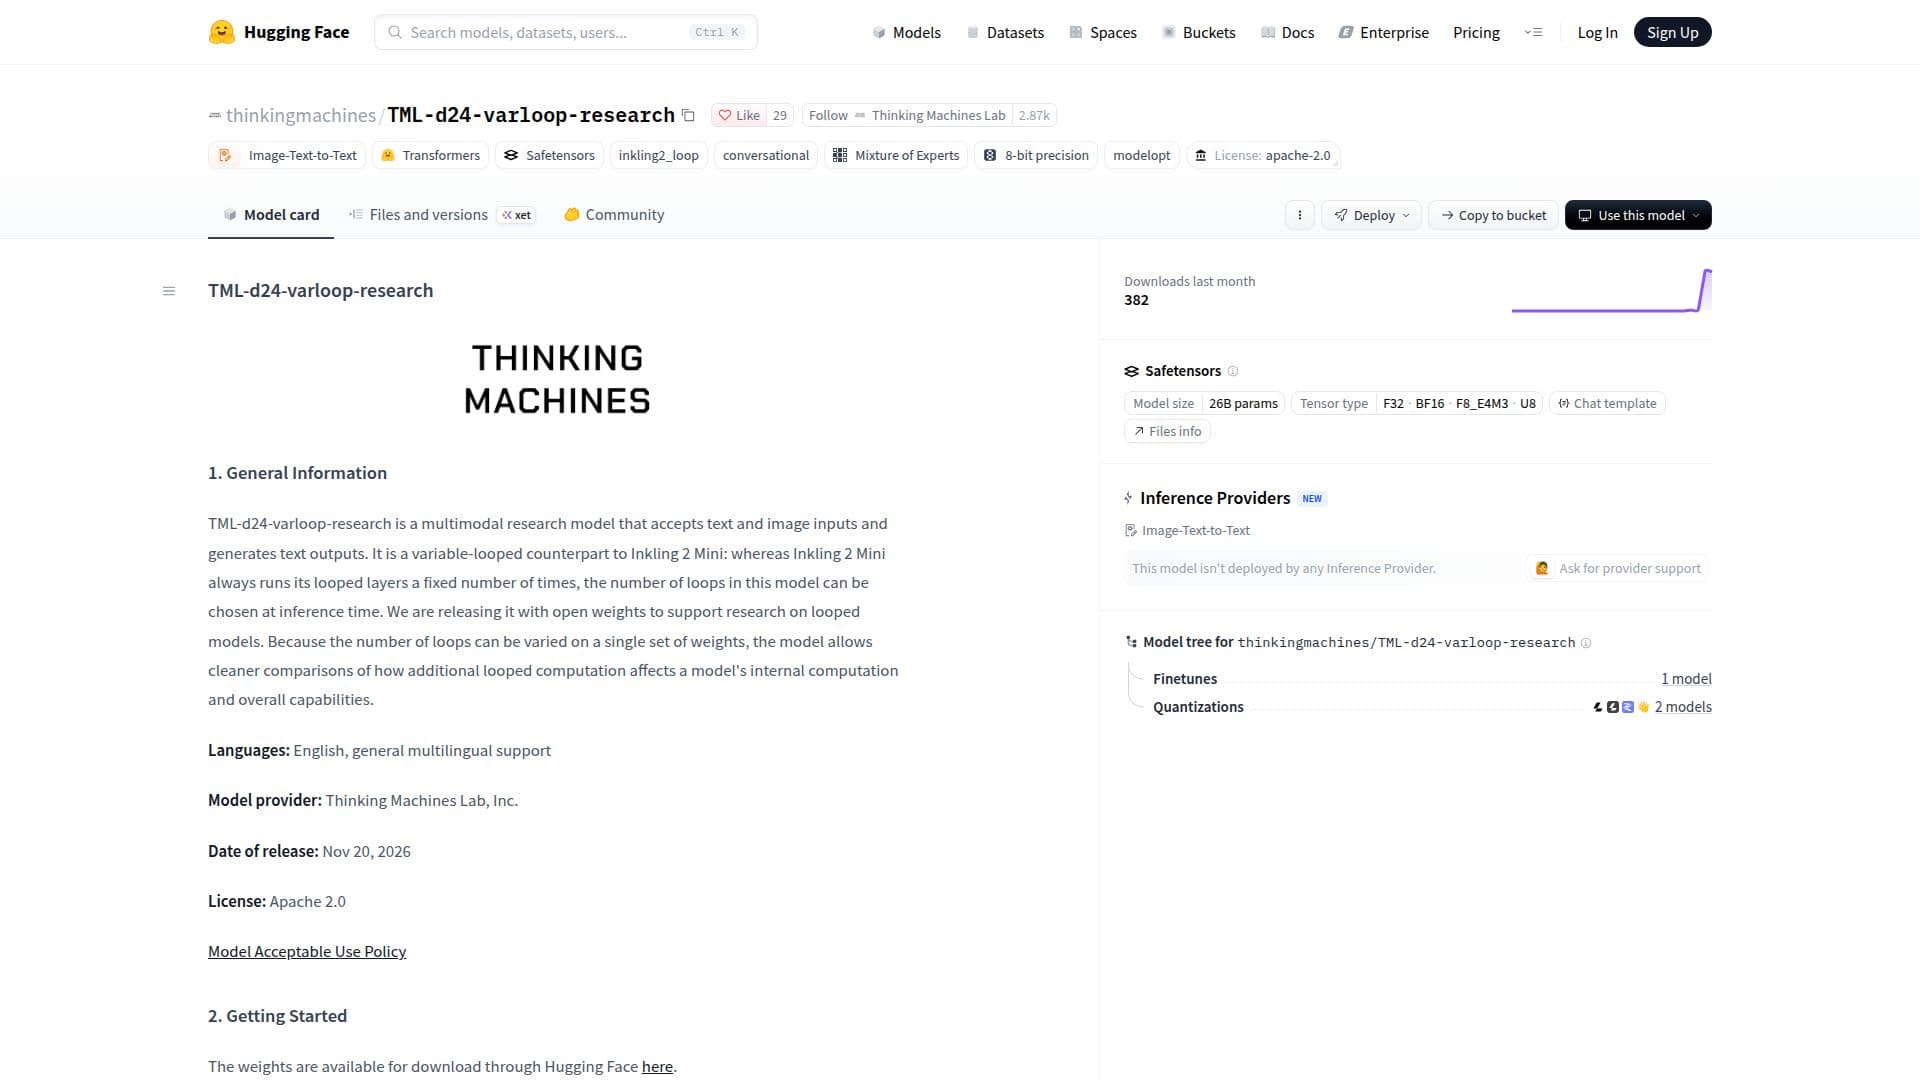
TML-d24-varloop-research es un modelo de investigación multimodal desarrollado por Thinking Machines Lab, Inc., diseñado para procesar tanto entradas de texto como de imagen y producir salidas de texto. Lanzado el 20 de noviembre de 2026, bajo una licencia Apache 2.0, este modelo es una contribución significativa al campo de los modelos en bucle, ofreciendo una arquitectura de bucle variable a diferencia de su contraparte de bucle fijo, Inkling 2 Mini. Los investigadores pueden ajustar dinámicamente el número de bucles durante la inferencia, lo que permite comparaciones más limpias de cómo la computación adicional impacta los procesos internos de un modelo y sus capacidades generales.
Leer más
El modelo se distribuye como pesos abiertos a través de Hugging Face, con un tamaño de punto de control único de aproximadamente 20GB. Requiere una máquina con al menos 32GB de memoria GPU o unificada, compatible con configuraciones como NVIDIA DGX Spark, GPUs de NVIDIA (por ejemplo, GeForce RTX 5090 o RTX PRO 6000 Blackwell), o Macs con silicio de Apple. TML-d24-varloop-research admite inferencia local utilizando varios marcos, incluidos Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth, llama.cpp, Llama App, Ollama y Exo Labs. También admite post-entrenamiento con Miles y SkyRL.
Arquitectónicamente, TML-d24-varloop-research es un transformador de solo decodificador de 24 capas con capas de alimentación hacia adelante de Mixture-of-Experts (MoE) dispersas. Las 12 capas intermedias pueden ejecutarse un número variable de veces, compartiendo pesos, y fueron entrenadas con 1 a 5 pasadas. Cada capa enruta tokens a 8 de 128 expertos, y la atención es un híbrido de capas locales y globales. El modelo es nativamente multimodal, codificando imágenes a través de un transformador de visión y procesándolas conjuntamente con texto en un espacio oculto compartido. Cuenta con 26.4 mil millones de parámetros (3.4 mil millones activos en 1 pasada) y admite numeración NVFP4 y MXFP8. Maneja texto codificado en UTF-8 y entradas de imagen basadas en píxeles (de 40px a 4096px por dimensión) con una ventana de contexto de hasta 1 millón de tokens.
Los datos de entrenamiento para TML-d24-varloop-research incluyen una amplia variedad de tipos de contenido de fuentes disponibles públicamente, adquisiciones de terceros y datos generados internamente/sintéticamente. La curación de datos involucró limpieza, deduplicación y filtrado para garantizar calidad y seguridad. El modelo comparte su preentrenamiento y la primera etapa de entrenamiento intermedio con Inkling 2 Mini, pero diverge en etapas posteriores, particularmente en su entrenamiento de bucle variable, donde se muestrearon de 1 a 5 pasadas. Si bien las evaluaciones muestran un rendimiento variable en comparación con Inkling 2 Mini en puntos de referencia como Codificación Agente, Interpretación Visual y Razonamiento, está destinado principalmente como un artefacto de investigación y no se recomienda para uso en producción debido a un comportamiento potencialmente impredecible en diferentes conteos de pasadas y limitaciones generales comunes a los modelos base, como la alucinación y sesgos de los datos de entrenamiento.
- CategoríaModelos de IA y LLM
- Modelo de preciosCódigo abierto
- ImplementaciónSe ejecuta en local
- PlataformasWeb
Aspectos destacados de TML-d24-varloop-research
Entrada Multimodal: Acepta tanto entradas de texto como de imagen
Salida de Texto: Genera texto basado en las entradas
Bucle Variable: Se puede elegir el número de capas en bucle en el momento de la inferencia
Pesos Abiertos: Disponibles para descarga para apoyar la investigación
26.4 Mil Millones de Parámetros: Modelo a gran escala con 3.4B de parámetros activos en 1 pasada
Soporte Multilingüe: Soporte general para múltiples idiomas
Licencia Apache 2.0: Licenciamiento de código abierto para uso y modificación
Soporte de Inferencia Local: Compatible con Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth, llama.cpp, Llama App, Ollama, Exo Labs
Soporte de Post-entrenamiento: Puede ser post-entrenado con Miles y SkyRL
Mixture-of-Experts (MoE) Disperso: Utiliza capas de alimentación hacia adelante MoE
Atención Híbrida: Combina capas de atención locales y globales
Multimodalidad Nativa: Imágenes codificadas a través de un transformador de visión y procesadas conjuntamente con texto
Ventana de Contexto Alta: Soporta hasta 1 millón de tokens
Numeración de Precisión Mixta: Soporta NVFP4 y MXFP8
Primeros pasos con TML-d24-varloop-research
Descargar Pesos: Accede a los pesos del modelo a través de Hugging Face.
Preparar Hardware: Asegúrate de que haya una máquina única con al menos 32GB de memoria GPU o unificada disponible.
Instalar Software: Configura los marcos de inferencia requeridos como Hugging Face, SGLang o vLLM junto con sus dependencias.
Configurar Modelo: Carga el punto de control de 20GB en tu marco elegido.
Establecer Pasadas de Bucle: Elige el número deseado de capas en bucle para la inferencia.
Proporcionar Entradas: Alimenta texto codificado en UTF-8 e imágenes basadas en píxeles (dimensiones de 40px-4096px) al modelo.
Generar Salida: Recibe salidas de texto del modelo basadas en las entradas proporcionadas.
Casos de uso de TML-d24-varloop-research
- Investigación Multimodal
- Estudios de Modelos en Bucle
- Generación de Texto a partir de Imágenes
- Procesamiento de Texto Multilingüe
- Desarrollo de Modelos de Pesos Abiertos
- Implementación de Inferencia Local
- Ajuste Fino del Modelo