Saltar al contenido principal
ToolPotion
Asesor de IA
Enviar

SenseNova-Loop-9B-Preview

LLM#85Modelos de IA y LLMCódigo abierto · Web

SenseNova-Loop-9B-Preview es un modelo de lenguaje multimodal diseñado para flujos de trabajo de largo contexto y agentes. Procesa tanto texto como imágenes para generar salidas de texto, apoyando aplicaciones en comprensión de documentos, codificación e interacción con herramientas externas. El modelo presenta una arquitectura de decodificador en bucle única y conexiones hipercorridas restringidas por manifold de dos flujos para rutas de ejecución profundas y eficientes.

Visitar URL
Compartir
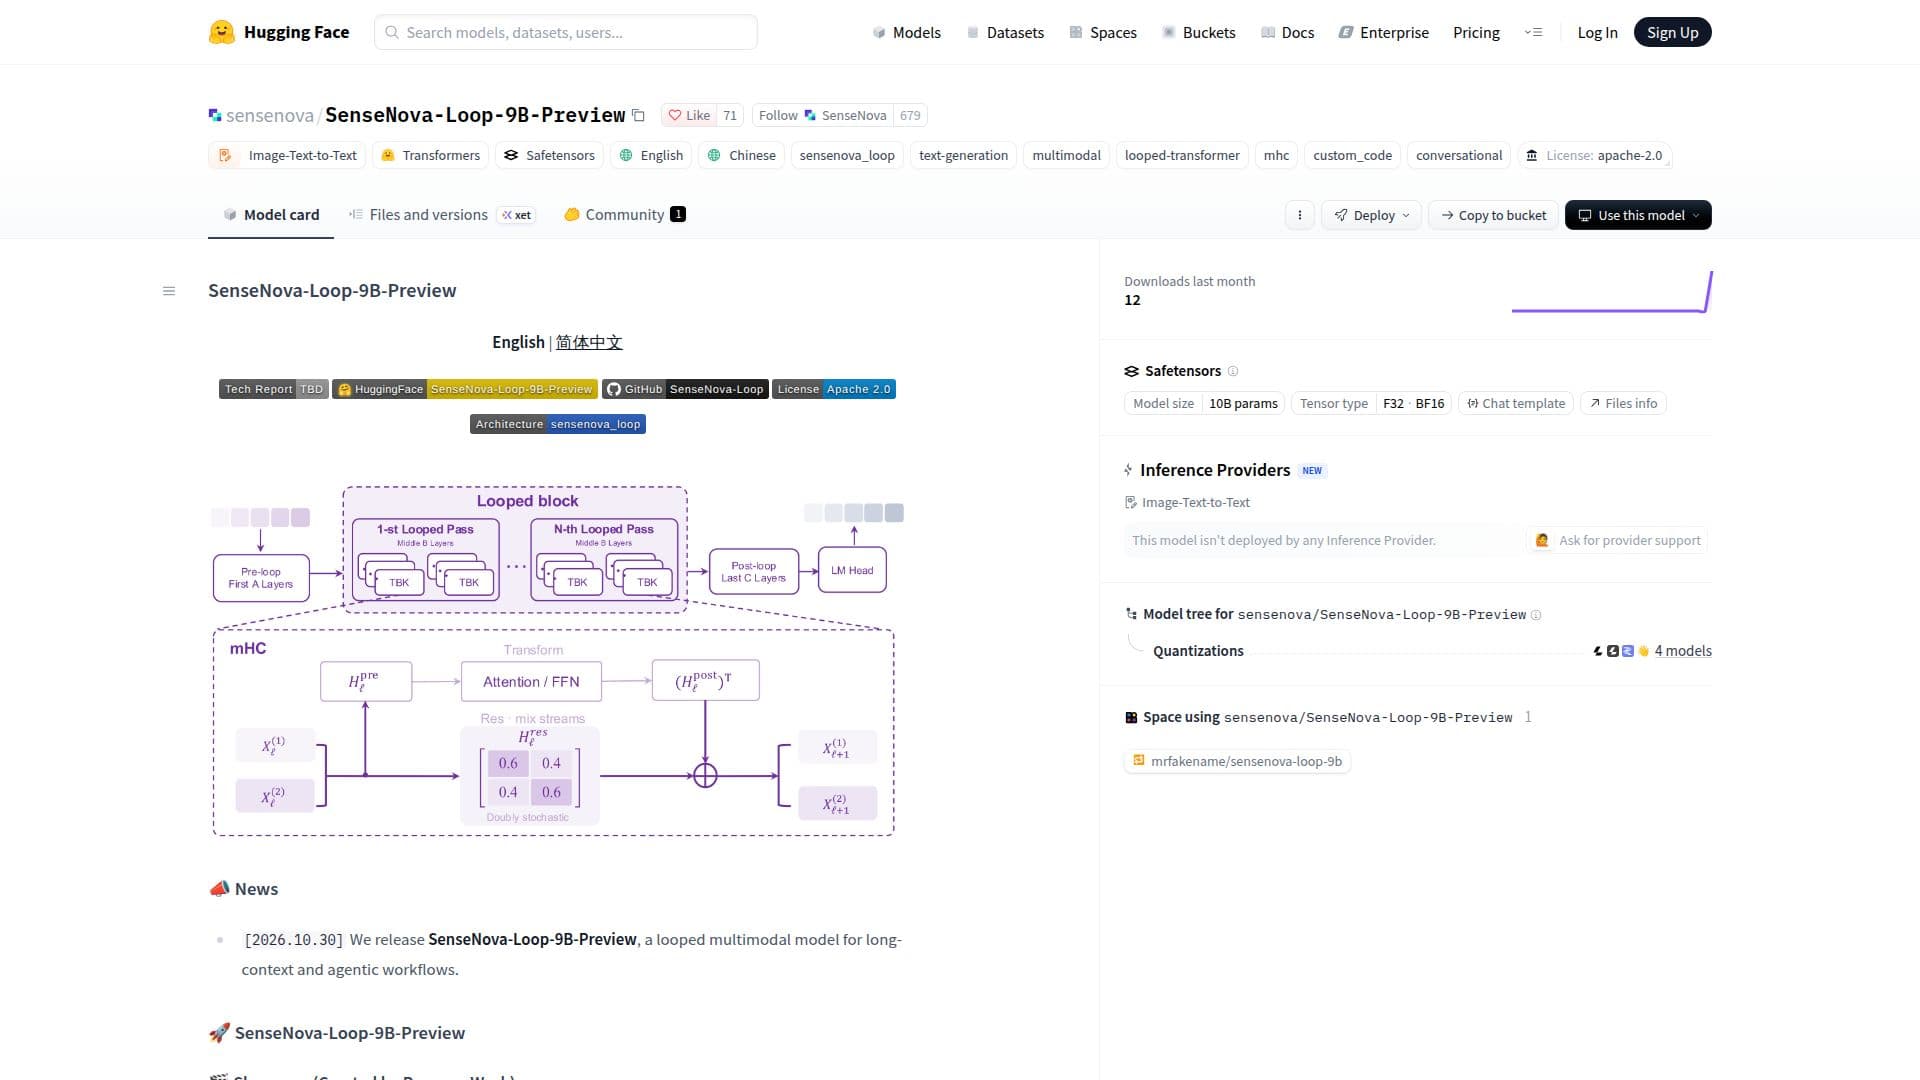
Captura de pantalla de SenseNova-Loop-9B-Preview

SenseNova-Loop-9B-Preview es un modelo de lenguaje multimodal avanzado diseñado para manejar escenarios complejos de largo contexto y flujos de trabajo agentes. Desarrollado por SenseNova, este modelo es capaz de aceptar tanto entradas de texto como de imagen, generando posteriormente salidas de texto. Sus aplicaciones principales abarcan áreas como la comprensión integral de documentos, tareas de codificación sofisticadas y la interacción fluida con diversas herramientas externas.

Leer más

El núcleo de la arquitectura de SenseNova-Loop-9B-Preview radica en su innovadora combinación de un decodificador en bucle y conexiones hipercorridas restringidas por manifold de dos flujos (mHC). Este diseño permite que un bloque contiguo de capas de decodificador se ejecute dos veces utilizando pesos compartidos, profundizando significativamente la ruta de ejecución sin duplicar parámetros. Los mapeos aprendidos dentro del sistema mHC gestionan de manera eficiente el flujo de información entre dos flujos residuales en la sección en bucle, mejorando la capacidad del modelo para procesar y sintetizar información.

Las recetas de entrenamiento para el modelo incorporan secuencias largas, diversas entradas multimodales y trayectorias de tareas supervisadas, con una longitud máxima de secuencia de entrenamiento que alcanza 262,144 tokens. Este extenso entrenamiento permite un rendimiento robusto en una amplia gama de tareas complejas. Para un funcionamiento óptimo, se aconseja a los usuarios utilizar el entorno de implementación documentado y los parámetros de configuración.

Los aspectos arquitectónicos clave incluyen un bloque en bucle compartido donde 24 capas de decodificador se aplican dos veces, resultando en 56 ejecuciones de capas de decodificador a partir de solo 32 capas distintas. El mHC de dos flujos facilita el enrutamiento inteligente y la combinación de información a través de los flujos residuales. Además, el decodificador emplea un mecanismo de atención híbrido, intercalando capas de atención lineales y completas en un patrón repetido de cuatro capas, que se conserva a través de los pases del bucle. El modelo también admite MTP para una inferencia acelerada, con Dspark y Dflash2 actualmente en desarrollo para mejorar aún más la velocidad.

  • CategoríaModelos de IA y LLM
  • Modelo de preciosCódigo abierto
  • ImplementaciónNube
  • PlataformasWeb

  • Entrada Multimodal: Acepta tanto texto como imágenes

  • Generación de Texto: Produce salidas de texto

  • Arquitectura de Decodificador en Bucle: Ejecuta capas de decodificador dos veces con pesos compartidos

  • Conexiones Hipercorridas Restringidas por Manifold de Dos Flujos (mHC): Gestiona el flujo de información entre flujos residuales

  • Procesamiento de Largo Contexto: Soporta longitudes de secuencia de entrenamiento de hasta 262,144 tokens

  • Soporte para Flujos de Trabajo Agentes: Diseñado para la interacción con herramientas externas

  • Atención Híbrida: Intercala capas de atención lineales y completas

  • Eficiencia de Parámetros: Logra 56 ejecuciones de capas de decodificador a partir de 32 capas distintas

  • Comprensión de Documentos: Capaz de procesar documentos complejos

  • Aplicaciones de Codificación: Soporta tareas relacionadas con el código

  • Aceleración de Inferencia MTP: Disponible para un procesamiento más rápido

  • Soporte para Fine-tuning: Proporciona recetas de entrenamiento documentadas para personalización

  • Licencia Apache 2.0: Licenciamiento de código abierto para uso y modificación

  • Integración con Hugging Face: Disponible para descarga e implementación en Hugging Face

  1. Acceder a la Página del Modelo: Navegar a la página de SenseNova-Loop-9B-Preview en Hugging Face.

  2. Instalar Dependencias: Instalar PyTorch compatible con su entorno CUDA, luego instalar Transformers 5.18.0 y PyTorch 2.11.0.

  3. Cargar el Modelo: Usar la biblioteca Transformers para cargar el modelo y su implementación personalizada desde el repositorio de Hugging Face o un directorio local.

  4. Configurar Inferencia: Establecer `model_id` al ID del repositorio o ruta local y configurar parámetros como `enable_thinking` y `device`.

  5. Generar Texto: Ejecutar el ejemplo de Python proporcionado para realizar la generación de texto, especificando el número de nuevos tokens.

  6. Ajustar el Modelo: Usar los comandos de entrenamiento documentados con su conjunto de datos SFT en un solo nodo con 8 GPUs para el ajuste fino.

  7. Desplegar el Modelo: Utilizar opciones de despliegue como LightLLM o SGLang reemplazando la ruta del modelo local en los ejemplos proporcionados.

  • Comprensión de Documentos de Largo Contexto
  • Automatización de Flujos de Trabajo Agentes
  • Generación de Contenido Multimodal
  • Asistencia Avanzada en Codificación
  • Automatización del Diseño de PPT
  • Generación de Texto para Diseño de Movimiento
  • Informes de Análisis de Datos
  • Investigación y Desarrollo Multimodal
Reseñas de SenseNova-Loop-9B-Preview

Cargando...

Herramientas de IA populares como SenseNova-Loop-9B-Preview

Modelo de IA avanzado que sobresale en tareas de codificación y agente. Cuenta con una ventana de contexto de 1M y comprensión multimodal nativa, impulsada por la…MiniMax M3 es un modelo de IA avanzado que sobresale en tareas de codificación y agente. Cuenta con una ventana de contexto de 1M y comprensión multimodal nativa, impulsada por la…

Modelos de IA y LLM
N.º 61 en LLM

LiquidAI LFM3-1.7B es un modelo de texto diseñado para agentes locales y aplicaciones especializadas. Presenta una arquitectura tri-híbrida y soporta una ventana de contexto de…

Modelos de IA y LLM

N.º 91 en LLM

Ver herramienta

Modelo de texto diseñado para agentes locales y aplicaciones especializadas. Presenta una arquitectura tri-híbrida y soporta una ventana de contexto de…LiquidAI LFM3-1.7B es un modelo de texto diseñado para agentes locales y aplicaciones especializadas. Presenta una arquitectura tri-híbrida y soporta una ventana de contexto de…

Modelos de IA y LLM
N.º 91 en LLM

DeepSeek-V4-Flash-Vision-Exp es un modelo multimodal experimental de la familia DeepSeek-V4, que mejora las capacidades de comprensión visual. Se basa en la arquitectura…

Modelos de IA y LLM

N.º 70 en LLM

Ver herramienta

Modelo multimodal experimental de la familia DeepSeek-V4, que mejora las capacidades de comprensión visual. Se basa en la arquitectura…DeepSeek-V4-Flash-Vision-Exp es un modelo multimodal experimental de la familia DeepSeek-V4, que mejora las capacidades de comprensión visual. Se basa en la arquitectura…

Modelos de IA y LLM
N.º 70 en LLM

Inkling-Small es un modelo multimodal versátil que procesa entradas de texto, imagen y audio para generar salidas de texto. Apoya a los desarrolladores en la creación de…

Modelos de IA y LLM

N.º 27 en LLM

Ver herramienta

Modelo multimodal versátil que procesa entradas de texto, imagen y audio para generar salidas de texto. Apoya a los desarrolladores en la creación de…Inkling-Small es un modelo multimodal versátil que procesa entradas de texto, imagen y audio para generar salidas de texto. Apoya a los desarrolladores en la creación de…

Modelos de IA y LLM
N.º 27 en LLM

pplx-embed-v2-context-9b-preview es un modelo de incrustación contextual diseñado para fragmentos de documentos en sistemas RAG. Codifica fragmentos de documentos juntos,…

Modelos de IA y LLM
Ver herramienta

Modelo de incrustación contextual diseñado para fragmentos de documentos en sistemas RAG. Codifica fragmentos de documentos juntos,…pplx-embed-v2-context-9b-preview es un modelo de incrustación contextual diseñado para fragmentos de documentos en sistemas RAG. Codifica fragmentos de documentos juntos,…

Modelos de IA y LLM
Ver el Top 5 de Modelos de IA

DeepSeek V4 Flash

Modelos de IA

DeepSeek V4 Flash es una colección de modelos de IA diseñada para tareas avanzadas de generación de texto. Aprovecha los principios de código abierto y ciencia abierta para…

Modelos de IA y LLM
Ver herramienta

Modelos de IA

Colección de modelos de IA diseñada para tareas avanzadas de generación de texto. Aprovecha los principios de código abierto y ciencia abierta para…DeepSeek V4 Flash es una colección de modelos de IA diseñada para tareas avanzadas de generación de texto. Aprovecha los principios de código abierto y ciencia abierta para…

Modelos de IA y LLM
Ver el Top 5 de Modelos de IA

Muse Spark 1.3

Modelos de IA

Muse Spark 1.3 es el modelo de IA de Meta para flujos de trabajo agenticos y de codificación, diseñado para tareas a largo plazo que requieren llamadas a herramientas confiables y…

Modelos de IA y LLM
Ver herramienta

Modelos de IA

Modelo de IA de Meta para flujos de trabajo agenticos y de codificación, diseñado para tareas a largo plazo que requieren llamadas a herramientas confiables y…Muse Spark 1.3 es el modelo de IA de Meta para flujos de trabajo agenticos y de codificación, diseñado para tareas a largo plazo que requieren llamadas a herramientas confiables y…

DestacadaModelos de IA y LLM
Ver el Top 5 de Modelos de IA

LLaVA

Repositorios de IA en GitHub

LLaVA es un modelo de ajuste de instrucciones visuales que combina capacidades de lenguaje y visión a gran escala. Su objetivo es alcanzar un rendimiento a nivel de GPT-4V,…

Modelos de IA y LLM
Ver herramienta

Repositorios de IA en GitHub

Modelo de ajuste de instrucciones visuales que combina capacidades de lenguaje y visión a gran escala. Su objetivo es alcanzar un rendimiento a nivel de GPT-4V,…LLaVA es un modelo de ajuste de instrucciones visuales que combina capacidades de lenguaje y visión a gran escala. Su objetivo es alcanzar un rendimiento a nivel de GPT-4V,…

Modelos de IA y LLM
Ver el Top 250 de Repositorios de IA en GitHub
1 de 8