Descripción
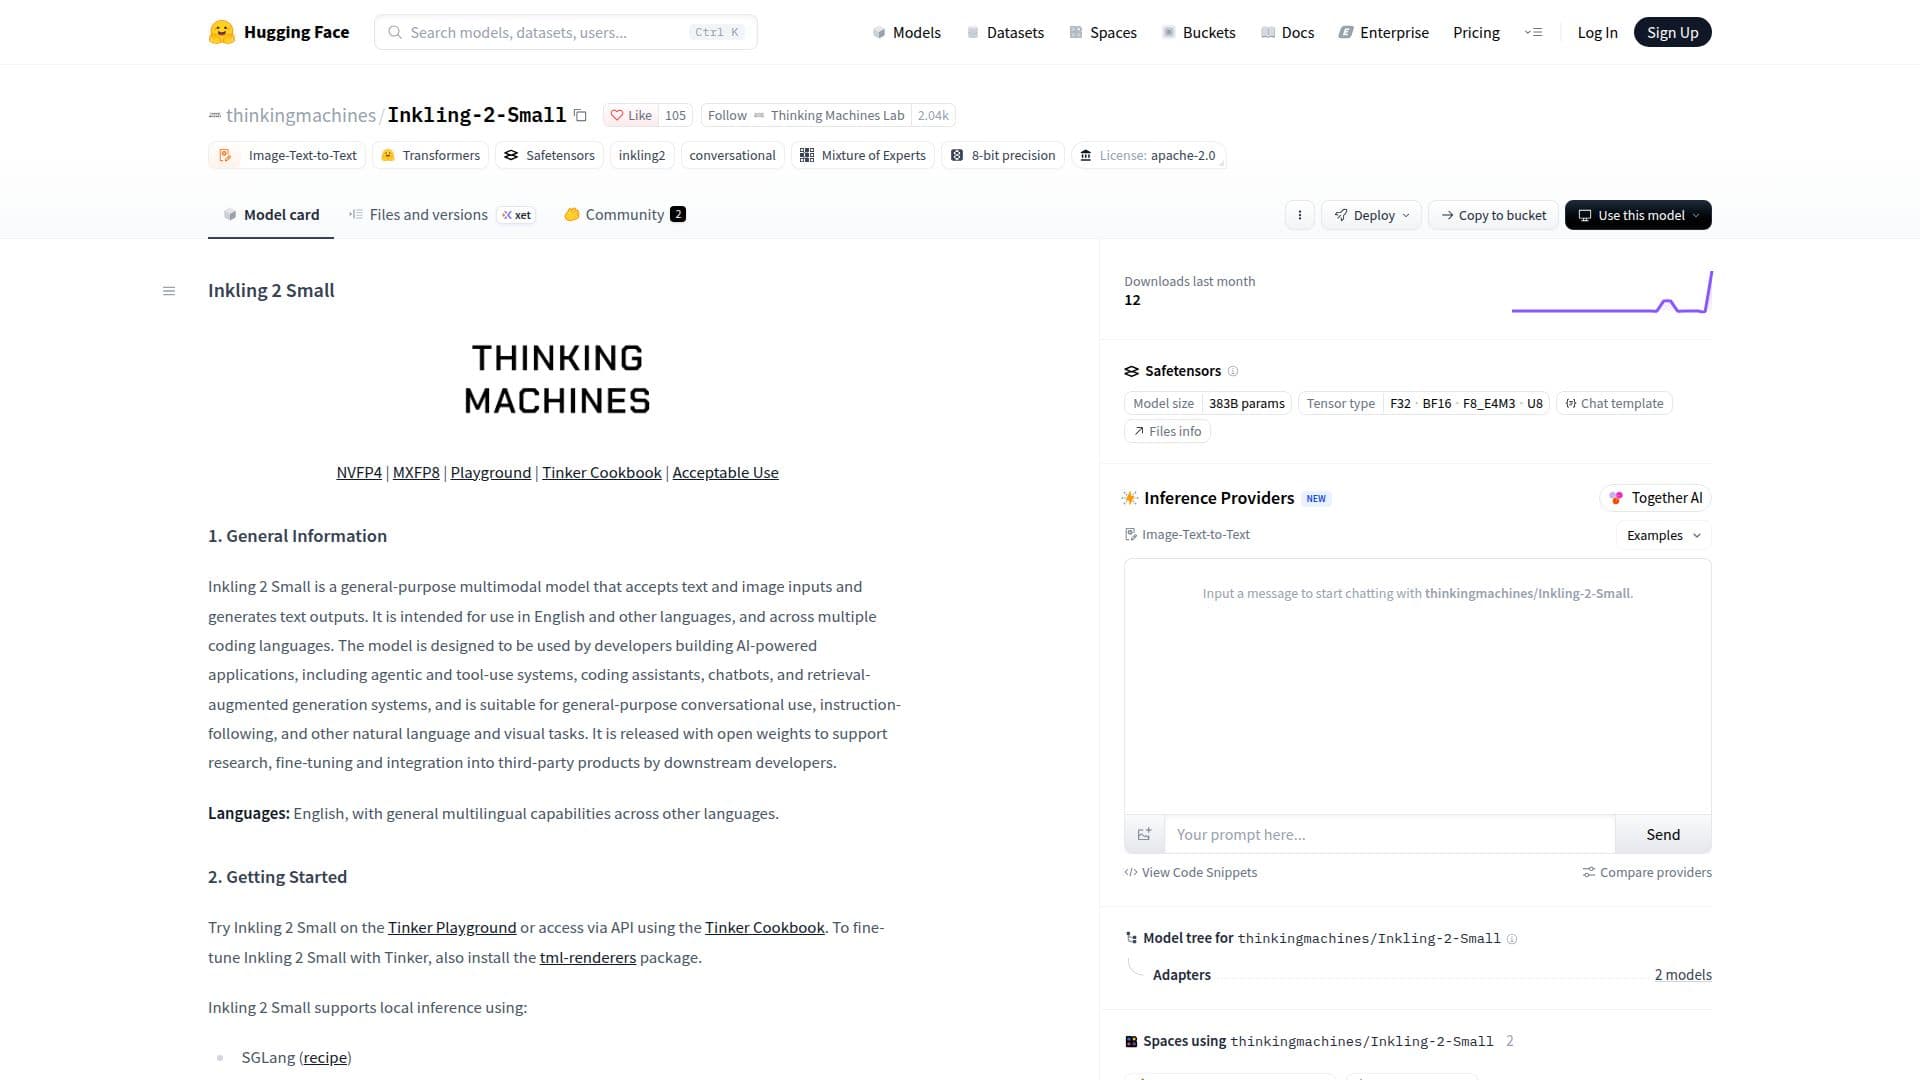
Inkling 2 Small es un modelo multimodal versátil capaz de procesar entradas de texto e imagen para producir salidas de texto. Está diseñado para una amplia aplicabilidad, soportando inglés y otros idiomas, junto con varios lenguajes de programación. El modelo está específicamente dirigido a desarrolladores que están creando aplicaciones impulsadas por IA, como sistemas agentivos y de uso de herramientas, asistentes de codificación, chatbots y sistemas de generación aumentada por recuperación (RAG). Su diseño también lo hace adecuado para interacciones conversacionales de propósito general, seguimiento de instrucciones y una amplia gama de tareas de lenguaje natural y visual.
Leer más
Lanzado con pesos abiertos, Inkling 2 Small fomenta la investigación, el ajuste fino y la integración en productos de terceros por parte de desarrolladores posteriores. Los usuarios pueden experimentar con el modelo en el Tinker Playground o acceder a él a través de la API utilizando el Tinker Cookbook. Para el ajuste fino con Tinker, se requiere el paquete tml-renderers. El modelo soporta inferencia local a través de varios marcos, incluyendo SGLang, vLLM, TokenSpeed y Unsloth. Además, puede ser post-entrenado con Miles, SkyRL y Snowflake Cortex Training. El acceso a la API también está disponible a través de proveedores de inferencia de terceros como NVIDIA, Fireworks, Together, Baseten, Nebius, Modal y Cloudflare.
Los requisitos de hardware para Inkling 2 Small dependen del formato del punto de control. El punto de control principal NVFP4 requiere un clúster de GPU con al menos 500GB de VRAM agregada, alcanzable con configuraciones como 2x GPUs NVIDIA B300 o 4x GPUs NVIDIA H200. El punto de control alternativo MXFP8 requiere al menos 800GB de VRAM agregada, cumplido por 4x GPUs NVIDIA B300 o 8x GPUs NVIDIA H200. Se recomienda el punto de control NVFP4 para todos los casos de uso, ya que es la precisión nativa para el modelo, ofreciendo un rendimiento óptimo.
Arquitectónicamente, Inkling 2 Small es un transformador autoregresivo multimodal. Presenta un transformador de solo decodificador de 48 capas con una columna vertebral de avance disperso Mixture-of-Experts (MoE), donde cada token es dirigido a 8 de 384 expertos. Su mecanismo de atención combina capas locales y globales. El modelo es nativamente multimodal, codificando imágenes a través de un transformador de visión y proyectando tanto entradas de imagen como de texto en un espacio oculto compartido para el procesamiento conjunto por el decodificador. Soporta una ventana de contexto de hasta 1 millón de tokens y acepta texto en codificación UTF-8 y formatos de imagen basados en píxeles (idealmente entre 40px y 4096px por dimensión). Las salidas se generan como texto codificado en UTF-8.
Los datos de entrenamiento para Inkling 2 Small incluyen una amplia gama de tipos de contenido, como texto, imágenes y video, obtenidos de repositorios disponibles públicamente, terceros, generación interna y aumento sintético. El proceso de curación de datos implica limpiar, procesar y modificar conjuntos de datos, incluyendo deduplicación y filtrado por calidad y seguridad. Se realizaron evaluaciones de seguridad en interacciones cotidianas entre humanos e IA y pruebas de capacidades peligrosas, aplicándose mitigaciones para reducir riesgos. El conocimiento del modelo está limitado a su corte de entrenamiento, y se aconseja a los usuarios aplicar supervisión humana para aplicaciones de alto riesgo debido a posibles limitaciones como alucinaciones y sesgos de los datos de entrenamiento.
- CategoríaModelos de IA y LLM
- Modelo de preciosCódigo abierto
- ImplementaciónNube, Autoalojado
- PlataformasWeb
Aspectos destacados de Inkling 2 Small
Entrada Multimodal: Acepta tanto entradas de texto como de imagen
Salida de Texto: Genera salidas de texto codificadas en UTF-8
Modelo de Propósito General: Adecuado para una amplia gama de aplicaciones
Capacidades Multilingües: Soporta inglés y otros idiomas
Soporte para Múltiples Lenguajes de Programación: Funciona en varios lenguajes de programación
Pesos Abiertos: Disponibles para investigación, ajuste fino e integración
Acceso a API: Accesible a través del Tinker Cookbook y proveedores de terceros
Soporte para Inferencia Local: Compatible con SGLang, vLLM, TokenSpeed, Unsloth
Opciones de Post-Entrenamiento: Puede ser post-entrenado con Miles, SkyRL, Snowflake Cortex Training
Transformador Autoregresivo: Utiliza una arquitectura de solo decodificador de 48 capas
Mixture-of-Experts (MoE): Columna vertebral de avance disperso con 384 expertos
Espacio Oculto Compartido: Procesa entradas de imagen y texto conjuntamente
Ventana de Contexto: Soporta hasta 1 millón de tokens
Alto Conteo de Parámetros: 594B parámetros totales, 17B activos
Primeros pasos con Inkling 2 Small
Acceder al Modelo: Visita la página de Inkling 2 Small en Hugging Face.
Probar el Playground: Experimenta con el modelo directamente en el Tinker Playground.
Acceder a través de la API: Usa el Tinker Cookbook para integrar el modelo a través de su API.
Ajustar el Modelo: Instala el paquete tml-renderers para ajustar Inkling 2 Small con Tinker.
Inferencia Local: Utiliza marcos como SGLang, vLLM, TokenSpeed o Unsloth para implementación local.
Post-Entrenar: Mejora el modelo con Miles, SkyRL o Snowflake Cortex Training.
Desplegar con Proveedores: Accede a la API a través de proveedores de inferencia de terceros como NVIDIA o Fireworks.
Configurar Hardware: Asegura un clúster de GPU con al menos 500GB de VRAM para NVFP4 o 800GB para el punto de control MXFP8.
Casos de uso de Inkling 2 Small
- Construcción de Aplicaciones de IA
- Desarrollo de Sistemas Agentivos
- Asistentes de Codificación
- Creación de Chatbots
- Generación Aumentada por Recuperación
- Uso Conversacional General
- Seguimiento de Instrucciones
- Tareas Visuales
- Investigación y Experimentación
- Integración de Productos de Terceros