Descripción
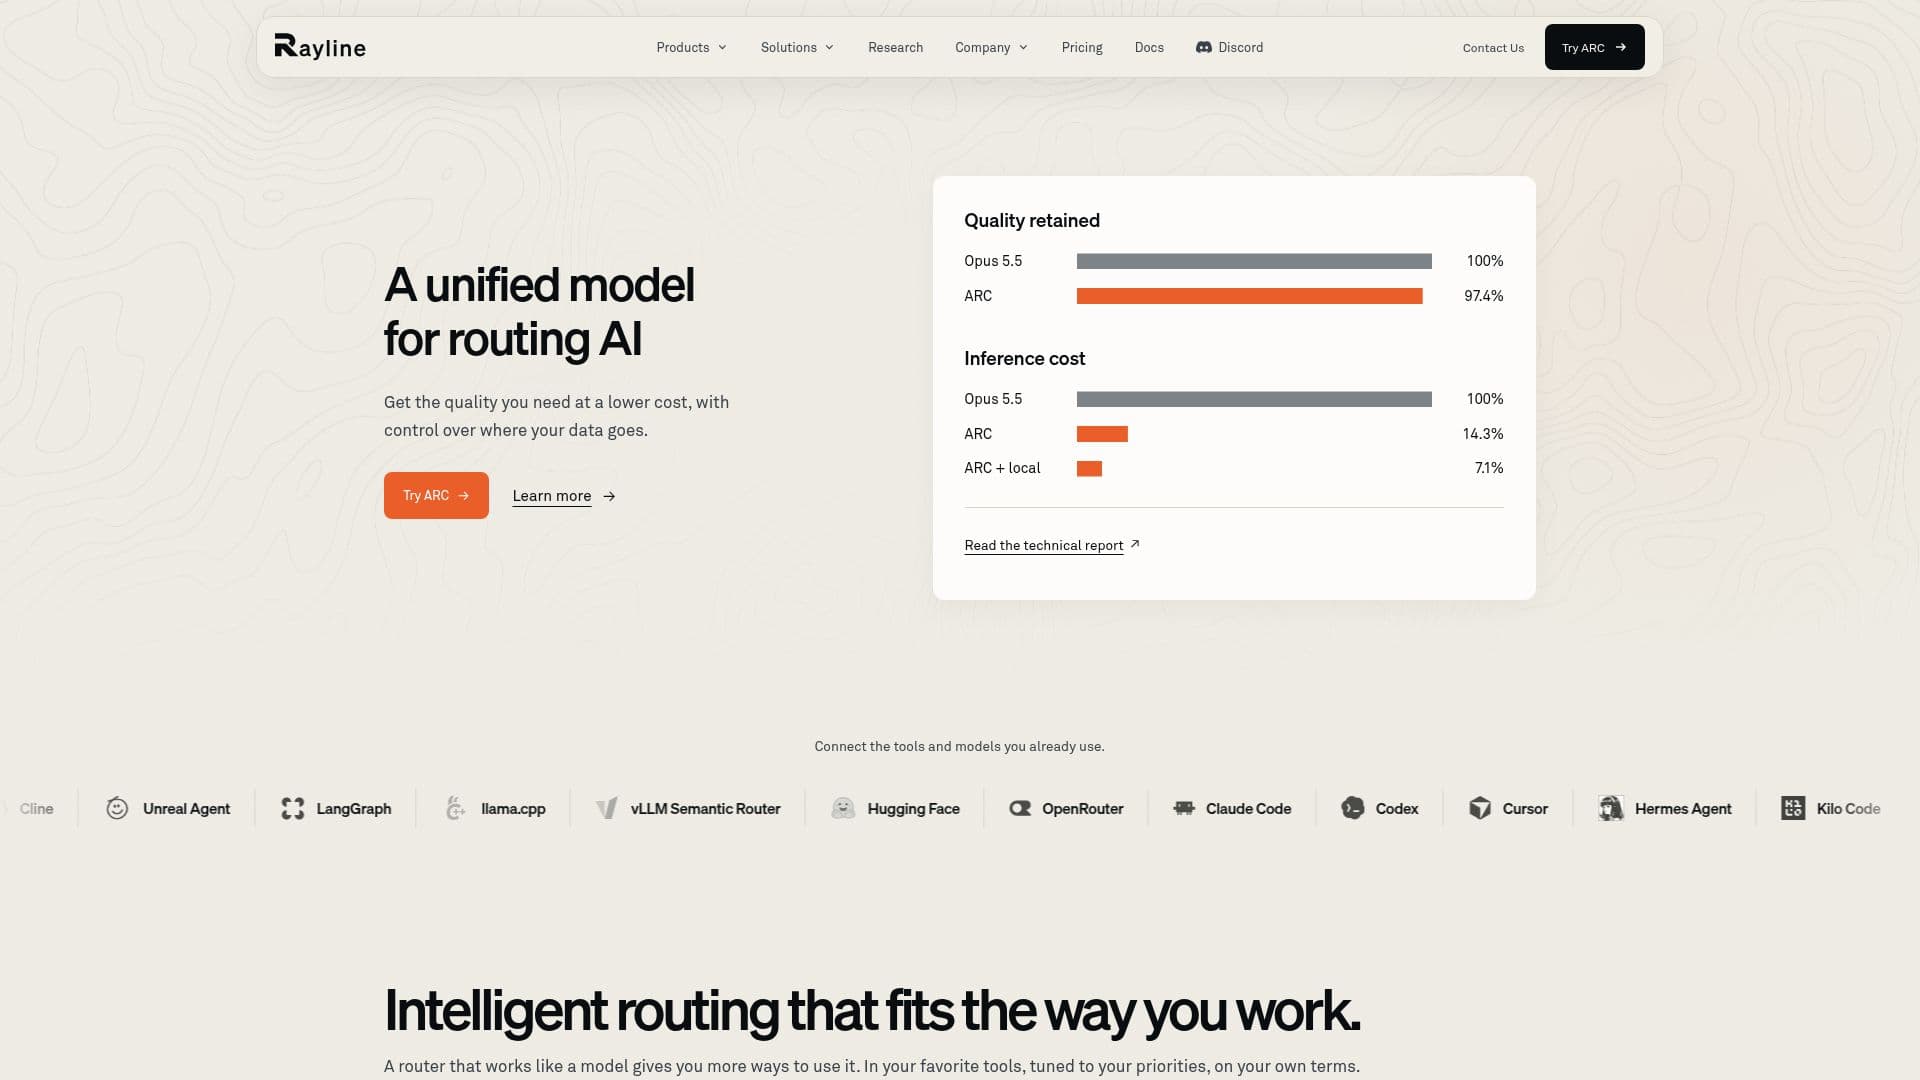
Rayline proporciona un modelo unificado para el enrutamiento de IA, diseñado para ofrecer una calidad óptima a un costo menor mientras asegura que los usuarios mantengan el control sobre sus datos. En su núcleo se encuentra ARC, el sistema de enrutamiento adaptativo de Rayline que elige inteligentemente el modelo de IA y el nivel de razonamiento más adecuados para cada turno conversacional, basándose en factores como el contexto de la conversación, la calidad deseada y el costo.
Leer más
La plataforma se integra sin problemas con una amplia gama de herramientas y modelos existentes, incluyendo llama.cpp, vLLM, Semantic Router, Hugging Face, OpenRouter, Claude, OpenAI, DeepSeek, GLM, Kimi, Qwen, Gemini, Gemma y Mistral. Esta flexibilidad permite a los equipos continuar trabajando dentro de sus entornos familiares mientras se benefician de las capacidades de enrutamiento inteligente de Rayline. Los usuarios pueden moldear las decisiones de ARC en torno a sus prioridades específicas de carga de trabajo y los costos reales de los modelos, incluidos los descuentos negociados.
Rayline ofrece flexibilidad en el despliegue, permitiendo a los usuarios optar por dejar que Rayline ejecute la inferencia o llevar la recomendación del modelo a su propio gateway, proveedor de nube o modelos locales. La API de Decisions proporciona respuestas estructuradas, opciones, probabilidades y puntajes a partir de cualquier entrada, entrenada específicamente para el enrutamiento de modelos pero útil para aplicaciones más amplias. Para la generación alojada, los usuarios pueden comenzar con ARC Swift o Sage, o utilizar la API de Routes para la inferencia autogestionada.
Para los desarrolladores, Rayline ofrece Workshop Cloud y Workshop Desktop, permitiendo la construcción de software listo para producción con agentes adaptativos. La CLI de Rayline conecta modelos locales y servicios en la nube, integrándolos en herramientas existentes. La plataforma también cuenta con ahorros significativos en costos, con ahorros anuales potenciales de hasta $108,000 al lograr hasta un 90% de reducción en los costos de inferencia. El enfoque de Rayline está respaldado por una extensa investigación, detallada en el informe técnico de ARC, que explica la metodología y los resultados de referencia detrás de su equilibrio entre calidad y costo.
Rayline ofrece varios modelos de precios, incluidos presets de tarifa fija como ARC Swift para un trabajo diario eficiente con la API y ARC Sage para tareas de agentes centradas en la calidad. ARC Dynamic proporciona selección de modelos adaptativa con precios de paso basados en el modelo seleccionado, incurriendo en un 0% de comisión. La API de Routes permite a los usuarios pagar por la selección de modelos y el nivel de razonamiento, gestionando sus propios costos de inferencia. La API de Decisions tiene un precio basado en tokens de entrada para respuestas estructuradas. La CLI de Rayline es de código abierto sin tarifa de software, con la inferencia de hardware y nube facturada por separado. Los modelos de contribuidor ofrecen tarifas de tokens más bajas a cambio de permitir que Rayline utilice datos de solicitudes elegibles para el entrenamiento de modelos.
- CategoríaMLOps y despliegue de modelos
- Modelo de preciosFreemium
- ImplementaciónNube, Local
- PlataformasWeb
Características principales de Rayline
Enrutamiento Unificado de Modelos de IA (ARC)
Selección de Modelos Optimizada por Costo
Control de Datos y Privacidad
Integración con Herramientas y Modelos de IA Existentes
Enrutamiento Adaptativo basado en Prioridades
Despliegue Flexible de Inferencia (Alojado o Autogestionado)
API de Decisions para Respuestas Estructuradas
API de Routes para Selección de Modelos
Workshop Cloud y Desktop para Desarrollo
CLI de Rayline para Integración de Modelos Locales
Ahorros Significativos en Costos de Inferencia
Informe Técnico y Respaldo de Investigación
Modelos de Precios de Tarifa Fija y Dinámica
Opciones de Precios para Modelos de Contribuidor
Plataforma de Seguimiento de Uso y Gastos
¿Cómo usar Rayline?
Conectar Herramientas: Integra modelos y herramientas de IA existentes como Claude, OpenAI y Hugging Face con Rayline.
Configurar Enrutamiento: Define tus prioridades para calidad y costo para moldear las decisiones de selección de modelos de ARC.
Desplegar Inferencia: Elige ejecutar la inferencia a través de los servicios alojados de Rayline (Swift, Sage) o gestionarlo en tu propia infraestructura utilizando la API de Routes.
Desarrollar Aplicaciones: Utiliza Workshop Cloud o Desktop para construir software listo para producción con agentes adaptativos.
Monitorear y Optimizar: Realiza un seguimiento del uso y los gastos en la Plataforma Rayline y ajusta las políticas de enrutamiento para una mejora continua.
Casos de uso de Rayline
- Optimización de la Selección de Modelos de IA
- Reducción de Costos de Inferencia
- Integración de Herramientas de IA Diversas
- Desarrollo de Agentes de IA Adaptativos
- Asegurando el Control de Datos
- Toma de Decisiones Estructuradas
- Personalización de la Economía de Enrutamiento
- Evaluación de Políticas de Enrutamiento