Beschreibung
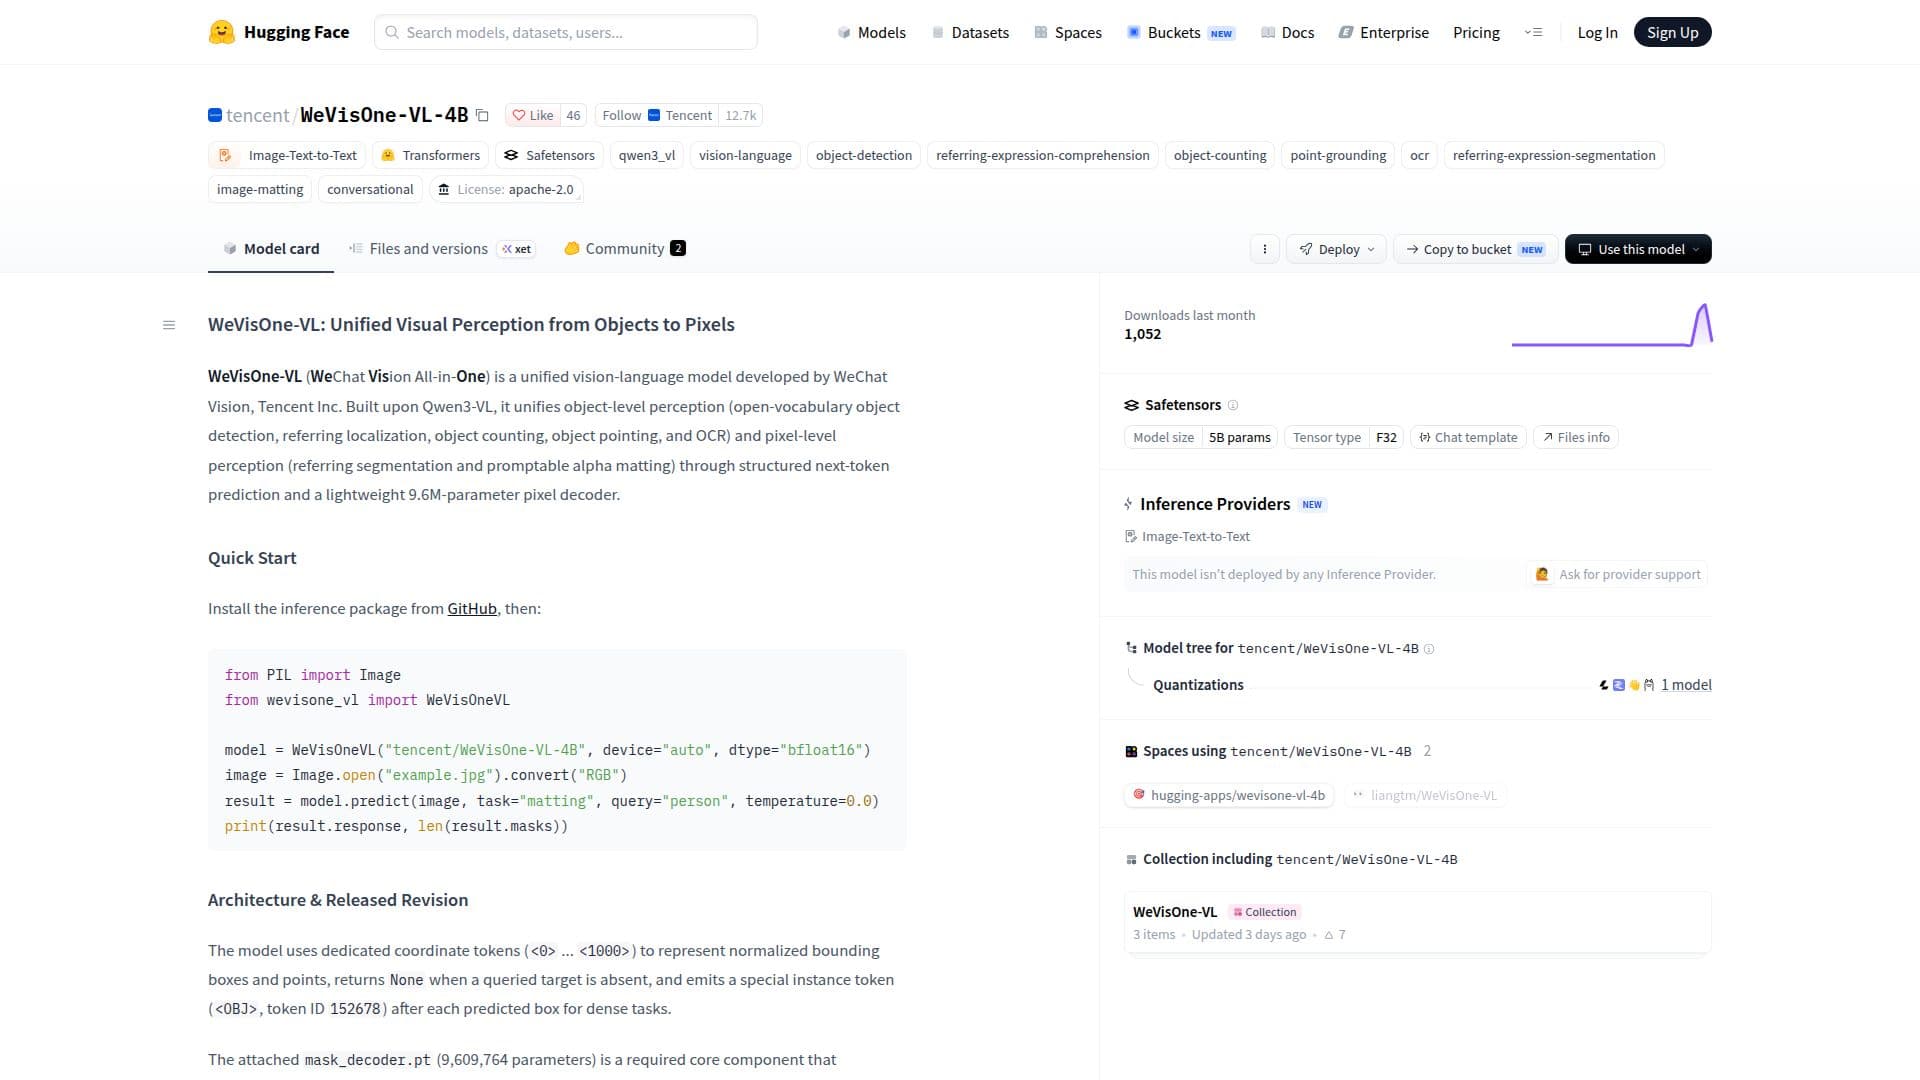
WeVisOne-VL ist ein Vision-Language-Modell, das von WeChat Vision, einem Teil von Tencent Inc., entwickelt wurde. Es wurde entwickelt, um Aufgaben der Objekt- und Pixelwahrnehmung zu vereinheitlichen. Basierend auf dem Qwen3-VL-Framework unterstützt WeVisOne-VL eine Reihe visueller Aufgaben, einschließlich offener Vokabular-Objekterkennung, referenzierender Lokalisierung, Objektezählung, Objektzeigefunktion und optischer Zeichenerkennung (OCR). Darüber hinaus bearbeitet es pixelbasierte Aufgaben wie referenzierende Segmentierung und anpassbares Alpha-Matting. Das Modell verwendet eine strukturierte Vorhersage des nächsten Tokens und verfügt über einen leichten Pixeldecoder mit 9,6 Millionen Parametern.
Weiterlesen
Die Architektur von WeVisOne-VL umfasst spezielle Koordinatentokens zur Darstellung normalisierter Begrenzungsrahmen und Punkte. Es verwendet ein spezielles Instanz-Token für dichte Aufgaben und integriert einen Masken-Decoder als Kernkomponente. Dieser Decoder kombiniert einen Visual Feature Adapter, einen Box-Guided Query Decoder und einen Instance-Conditioned Dense Prediction Head, um Vorhersagen zu verfeinern und Alpha-Mattes in voller Auflösung auszugeben.
WeVisOne-VL ist für Forschungszwecke in den Bereichen visuelle Verankerung, referenzierende Lokalisierung, Zeigen, Zählen, OCR-Lokalisierung, referenzierende Segmentierung und Bildmatting gedacht. Es ist nicht für autonome Entscheidungen mit hohem Einfluss oder individuelle Identifikation konzipiert. Das Modell ist effizient in der Generierung strukturierter Ausgaben, unterstützt jedoch kein explizites Denken in Ketten und ist derzeit auf die Wahrnehmung von Einzelbildern beschränkt.
Das Modell wird unter der Apache License 2.0 veröffentlicht, wobei Drittanbieterkomponenten ihre ursprünglichen Lizenzen behalten. Es wurde im letzten Monat über 1.000 Mal heruntergeladen, was auf seine wachsende Beliebtheit in der Forschungsgemeinschaft hinweist.
- KategorieKI-Modelle & LLMs
- PreismodellKostenlos
- BereitstellungCloud
- PlattformenWeb
WeVisOne-VL im Überblick
Einheitliches Vision-Language-Modell
Objektwahrnehmung
Pixelwahrnehmung
9,6 Millionen Parameter Pixeldecoder
Strukturierte Vorhersage des nächsten Tokens
Spezielle Koordinatentokens
Spezialinstanz-Token für dichte Aufgaben
Apache License 2.0
Erste Schritte mit WeVisOne-VL
Zugriff auf die Modellseite: Besuchen Sie die Hugging Face-Seite für WeVisOne-VL
Authentifizieren: Stellen Sie sicher, dass Sie die erforderlichen Berechtigungen zum Zugriff auf das Modell haben
Konfigurieren: Richten Sie die Modellparameter gemäß Ihren Forschungsbedürfnissen ein
Eingabeaufforderungen senden: Geben Sie Ihre visuellen Aufgaben zur Verarbeitung ein
Feinabstimmung: Passen Sie das Modell bei Bedarf für spezifische Aufgaben an
WeVisOne-VL's Anwendungsfälle
- Objekterkennung
- Referenzlokalisierung
- Objektezählung
- OCR-Lokalisierung
- Bildmatting