Beschreibung
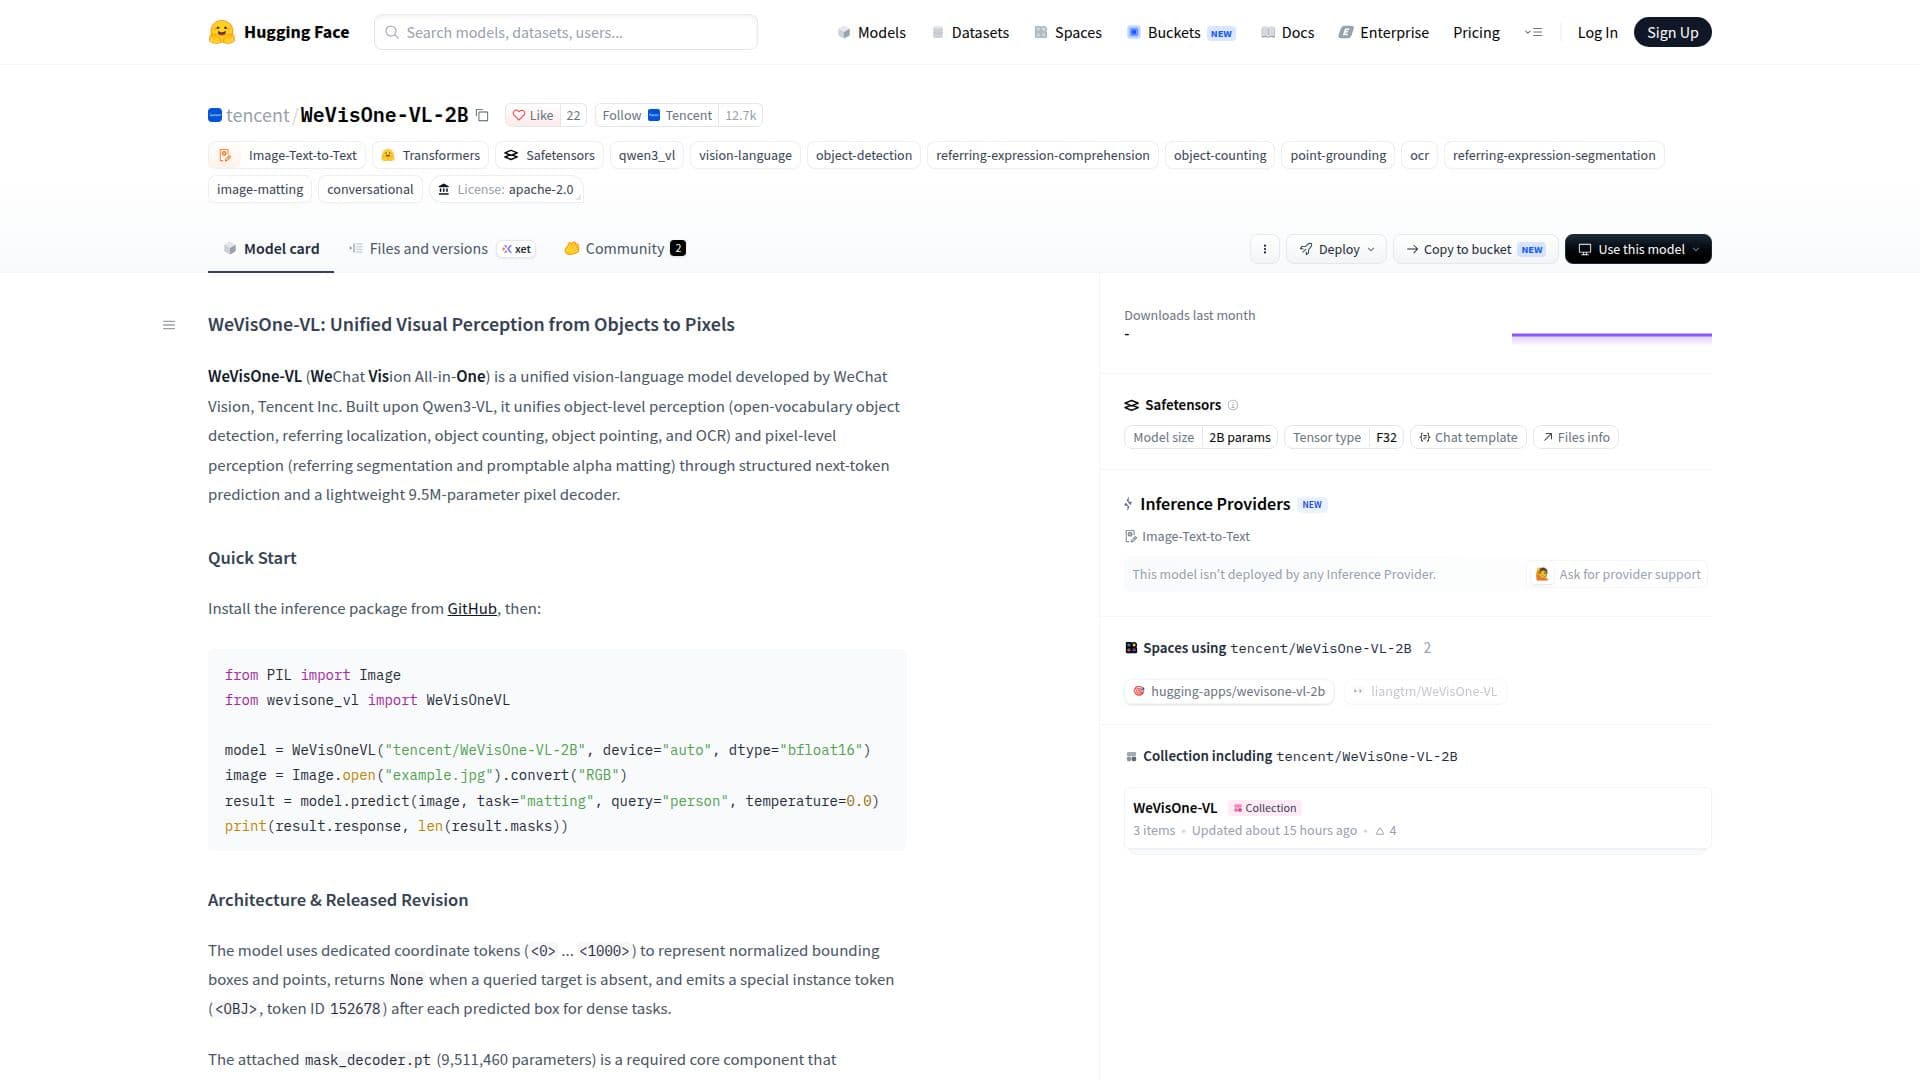
WeVisOne-VL ist ein anspruchsvolles Vision-Language-Modell, das von WeChat Vision, einer Abteilung von Tencent Inc., entwickelt wurde. Dieses Modell basiert auf dem Qwen3-VL-Framework und wurde entwickelt, um objekt- und pixelbasierte Wahrnehmungsaufgaben zu vereinen. Es ist in der Lage, offene Vokabular-Objekterkennung, referenzielle Lokalisierung, Objektezählung, Objektzeiger und optische Zeichenerkennung (OCR) zu verarbeiten. Darüber hinaus unterstützt es pixelbasierte Aufgaben wie referenzielle Segmentierung und anpassbares Alpha-Matting.
Weiterlesen
Das Modell verwendet eine strukturierte Vorhersage des nächsten Tokens und verfügt über einen leichten Pixel-Decoder mit 9,5 Millionen Parametern. Ein zentrales Element von WeVisOne-VL ist der mask_decoder.pt, der einen Visual Feature Adapter, einen Box-Guided Query Decoder und einen Instance-Conditioned Dense Prediction Head integriert. Diese Komponenten arbeiten zusammen, um Vorhersagen zu verfeinern und hochauflösende Alpha-Matten auszugeben.
WeVisOne-VL ist für Forschungsanwendungen in den Bereichen visuelle Verankerung, Lokalisierung, Zeigen, Zählen, OCR, Segmentierung und Bildmatting gedacht. Es ist nicht für autonome Entscheidungsfindung oder individuelle Identifizierung konzipiert. Das Modell ist für die Einzelturn-Bilderkennung optimiert und unterstützt keine Video-Raster.
Das Modell wird unter der Apache License 2.0 veröffentlicht, wobei Drittanbieterkomponenten ihre ursprünglichen Lizenzen behalten. Benutzer werden ermutigt, die Quelldateien auf spezifische Lizenzdetails zu überprüfen.
- KategorieComputer-Vision-Tools
- PreismodellOpen Source
- BereitstellungCloud
- PlattformenWeb
WeVisOne-VL im Überblick
Einheitliches Vision-Language-Modell
Objektbasierte Wahrnehmung
Pixelbasierte Wahrnehmung
Offene Vokabular-Objekterkennung
Referenzielle Segmentierung
Anpassbares Alpha-Matting
Strukturierte Vorhersage des nächsten Tokens
Leichter Pixel-Decoder
Erste Schritte mit WeVisOne-VL
Zugriff auf die Modellseite: Besuchen Sie die Hugging Face Modellseite
Authentifizieren: Melden Sie sich bei Ihrem Hugging Face-Konto an
Konfigurieren: Richten Sie das Modell mit den erforderlichen Parametern ein
Eingabeaufforderungen senden: Geben Sie Ihre visuellen Daten zur Verarbeitung ein
Feinabstimmung: Passen Sie die Modelleinstellungen für spezifische Aufgaben an
WeVisOne-VL's Anwendungsfälle
- Visuelle Verankerung
- Objekterkennung
- Bildmatting
- OCR-Lokalisierung
- Referenzielle Segmentierung