Beschreibung
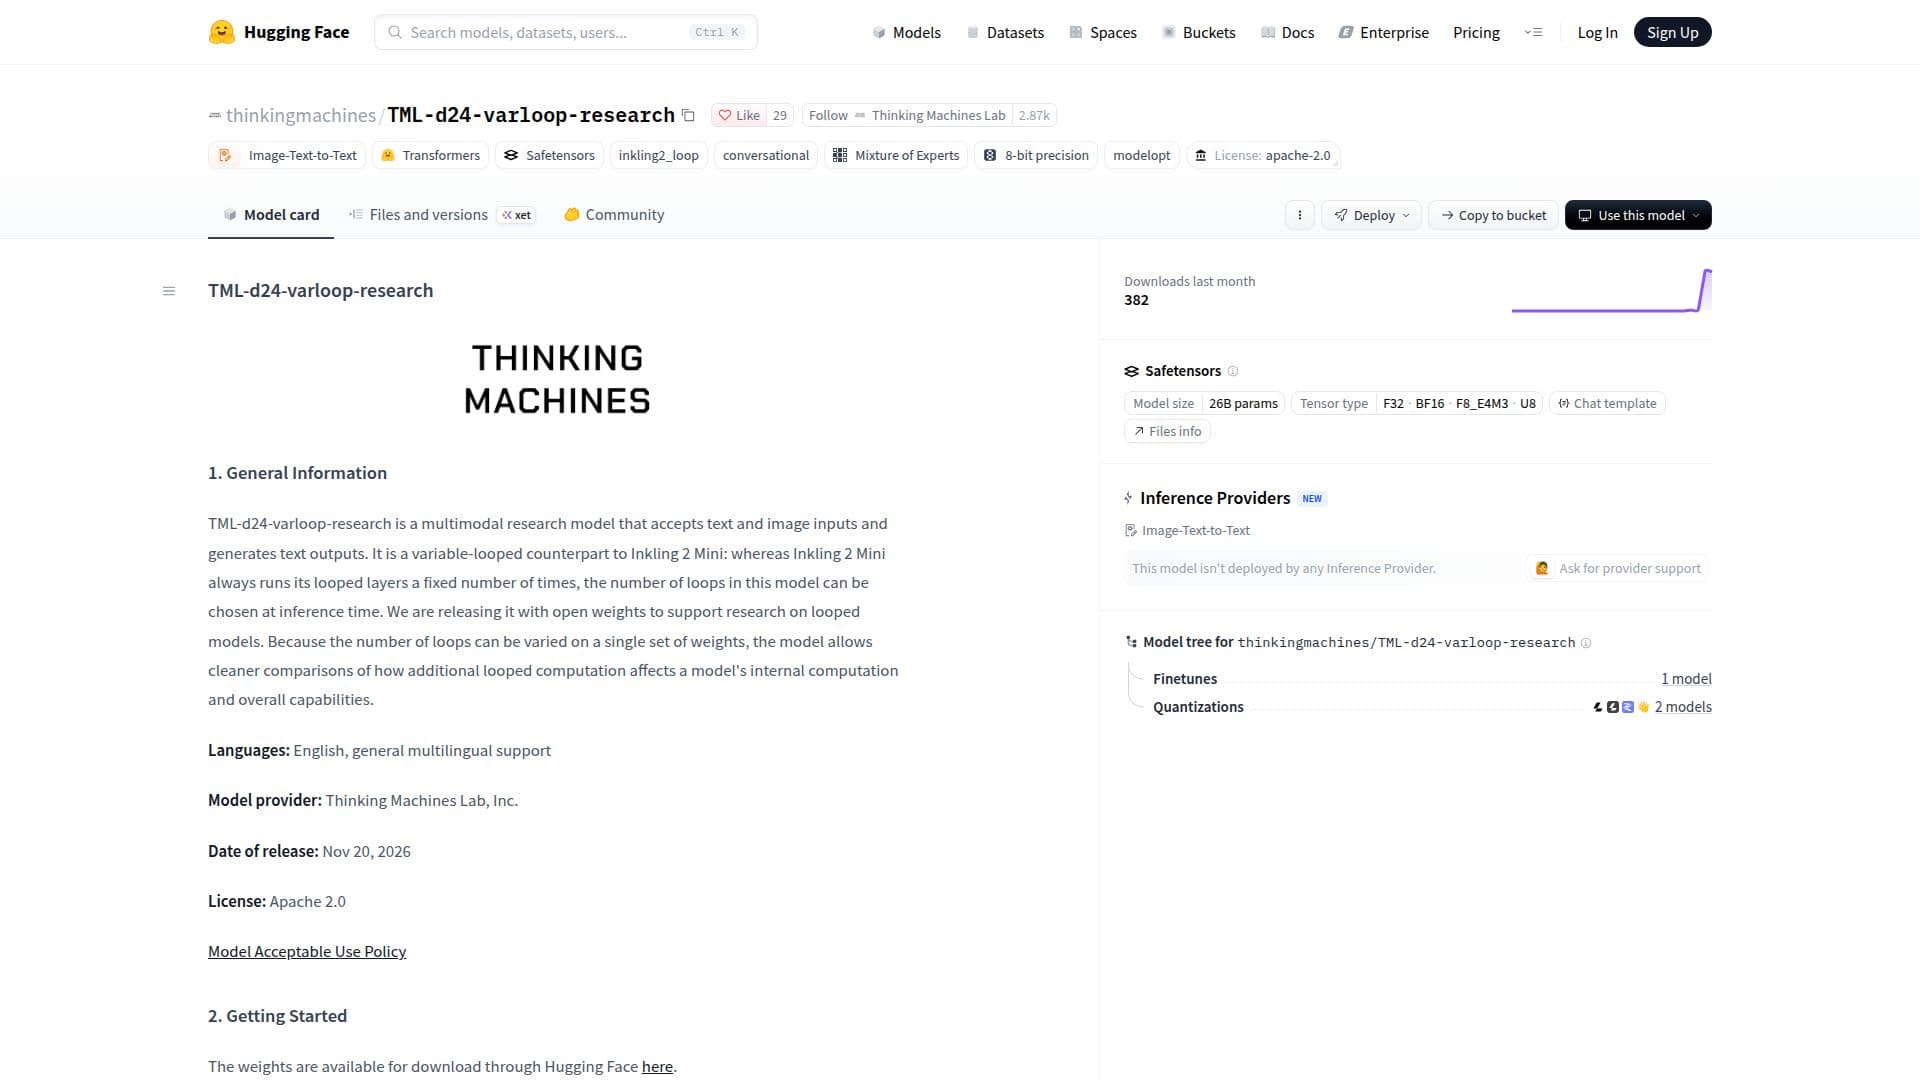
TML-d24-varloop-research ist ein multimodales Forschungsmodell, das von Thinking Machines Lab, Inc. entwickelt wurde und sowohl Text- als auch Bildeingaben verarbeitet, um Texte auszugeben. Es wurde am 20. November 2026 unter einer Apache 2.0-Lizenz veröffentlicht und stellt einen bedeutenden Beitrag im Bereich der geschleiften Modelle dar, da es eine variabel geschleifte Architektur bietet, im Gegensatz zu seinem festen Pendant, Inkling 2 Mini. Forscher können die Anzahl der Schleifen während der Inferenz dynamisch anpassen, was sauberere Vergleiche darüber ermöglicht, wie zusätzliche Berechnungen die internen Prozesse und die Gesamtfähigkeiten eines Modells beeinflussen.
Weiterlesen
Das Modell wird als offene Gewichte über Hugging Face verteilt, mit einer einzelnen Checkpoint-Größe von etwa 20 GB. Es erfordert eine Maschine mit mindestens 32 GB GPU- oder einheitlichem Speicher, die mit Konfigurationen wie NVIDIA DGX Spark, NVIDIA GPUs (z. B. GeForce RTX 5090 oder RTX PRO 6000 Blackwell) oder Apple Silicon Macs kompatibel ist. TML-d24-varloop-research unterstützt lokale Inferenz mit verschiedenen Frameworks, einschließlich Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth, llama.cpp, Llama App, Ollama und Exo Labs. Es unterstützt auch das Nachtraining mit Miles und SkyRL.
Architektonisch ist TML-d24-varloop-research ein 24-schichtiger Decoder-Transformer mit spärlichen Mixture-of-Experts (MoE) Feed-Forward-Schichten. Die mittleren 12 Schichten können eine variable Anzahl von Durchläufen ausführen, wobei Gewichte geteilt werden, und wurden mit 1 bis 5 Durchläufen trainiert. Jede Schicht leitet Tokens an 8 von 128 Experten weiter, und die Aufmerksamkeit ist eine Hybridform aus lokalen und globalen Schichten. Das Modell ist nativ multimodal, kodiert Bilder über einen Vision-Transformer und verarbeitet sie gemeinsam mit Text in einem gemeinsamen verborgenen Raum. Es verfügt über 26,4 Milliarden Parameter (3,4 Milliarden aktiv bei 1 Durchlauf) und unterstützt NVFP4 und MXFP8-Zahlen. Es verarbeitet UTF-8-kodierten Text und pixelbasierte Bildeingaben (40px bis 4096px pro Dimension) mit einem Kontextfenster von bis zu 1 Million Tokens.
Die Trainingsdaten für TML-d24-varloop-research umfassen eine breite Palette von Inhaltstypen aus öffentlich verfügbaren Quellen, Drittanbieterakquisitionen und intern/synthetisch generierten Daten. Die Datenaufbereitung umfasste Reinigung, Duplikatsentfernung und Filterung, um Qualität und Sicherheit zu gewährleisten. Das Modell teilt sein Vortraining und die erste Phase des Midtrainings mit Inkling 2 Mini, weicht jedoch in späteren Phasen ab, insbesondere in seinem variablen Schleifentraining, bei dem 1 bis 5 Durchläufe ausgewählt wurden. Während die Bewertungen eine unterschiedliche Leistung im Vergleich zu Inkling 2 Mini über Benchmarks wie Agentic Coding, Vision Interpretation und Reasoning zeigen, ist es hauptsächlich als Forschungsartefakt gedacht und wird aufgrund potenziell unvorhersehbaren Verhaltens bei unterschiedlichen Durchlaufzahlen und allgemeinen Einschränkungen, die für Grundmodelle typisch sind, wie Halluzinationen und Vorurteile aus den Trainingsdaten, nicht für den Produktionsgebrauch empfohlen.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Source
- BereitstellungLäuft lokal
- PlattformenWeb
TML-d24-varloop-research im Überblick
Multimodale Eingabe: Akzeptiert sowohl Text- als auch Bildeingaben
Textausgabe: Generiert Texte basierend auf Eingaben
Variable Schleifen: Anzahl der geschleiften Schichten kann zur Inferenzzeit gewählt werden
Offene Gewichte: Zum Download verfügbar zur Unterstützung der Forschung
26,4 Milliarden Parameter: Großes Modell mit 3,4 Milliarden aktiven Parametern bei 1 Durchlauf
Mehrsprachige Unterstützung: Allgemeine Unterstützung für mehrere Sprachen
Apache 2.0 Lizenz: Open-Source-Lizenzierung für Nutzung und Modifikation
Unterstützung für lokale Inferenz: Kompatibel mit Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth, llama.cpp, Llama App, Ollama, Exo Labs
Unterstützung für Nachtraining: Kann mit Miles und SkyRL nachtrainiert werden
Spärliche Mixture-of-Experts (MoE): Nutzt MoE-Feed-Forward-Schichten
Hybride Aufmerksamkeit: Kombiniert lokale und globale Aufmerksamkeits-Schichten
Native Multimodalität: Bilder werden über Vision-Transformer kodiert und gemeinsam mit Text verarbeitet
Hohes Kontextfenster: Unterstützt bis zu 1 Million Tokens
Gemischte Präzisionszahlen: Unterstützt NVFP4 und MXFP8
Erste Schritte mit TML-d24-varloop-research
Gewichte herunterladen: Greifen Sie über Hugging Face auf die Modellgewichte zu.
Hardware vorbereiten: Stellen Sie sicher, dass eine einzelne Maschine mit mindestens 32 GB GPU- oder einheitlichem Speicher verfügbar ist.
Software installieren: Richten Sie die erforderlichen Inferenz-Frameworks wie Hugging Face, SGLang oder vLLM sowie deren Abhängigkeiten ein.
Modell konfigurieren: Laden Sie den 20 GB-Checkpoint in Ihr gewähltes Framework.
Schleifendurchläufe festlegen: Wählen Sie die gewünschte Anzahl an geschleiften Schichten für die Inferenz.
Eingaben bereitstellen: Füttern Sie UTF-8-kodierten Text und pixelbasierte Bilder (40px-4096px Dimensionen) in das Modell ein.
Ausgabe generieren: Erhalten Sie Texteingaben vom Modell basierend auf den bereitgestellten Eingaben.
TML-d24-varloop-research's Anwendungsfälle
- Multimodale Forschung
- Studien zu geschleiften Modellen
- Textgenerierung aus Bildern
- Mehrsprachige Textverarbeitung
- Entwicklung von Modellen mit offenen Gewichten
- Bereitstellung lokaler Inferenz
- Modellfeinabstimmung