Zum Hauptinhalt springen
ToolPotion
KI-Berater
Einreichen

SenseNova-Loop-9B-Preview

LLMs#85KI-Modelle & LLMsOpen Source · Web

SenseNova-Loop-9B-Preview ist ein multimodales Sprachmodell, das für Langzeitkontexte und agentische Arbeitsabläufe entwickelt wurde. Es verarbeitet sowohl Text als auch Bilder, um Textausgaben zu generieren, und unterstützt Anwendungen in der Dokumentenverständnis, Programmierung und Interaktion mit externen Werkzeugen. Das Modell verfügt über eine einzigartige Architektur mit einem geschleiften Decoder und zweistreamigen manifold-beschränkten Hyperverbindungen für effiziente, tiefe Ausführungspfade.

URL besuchen
Teilen
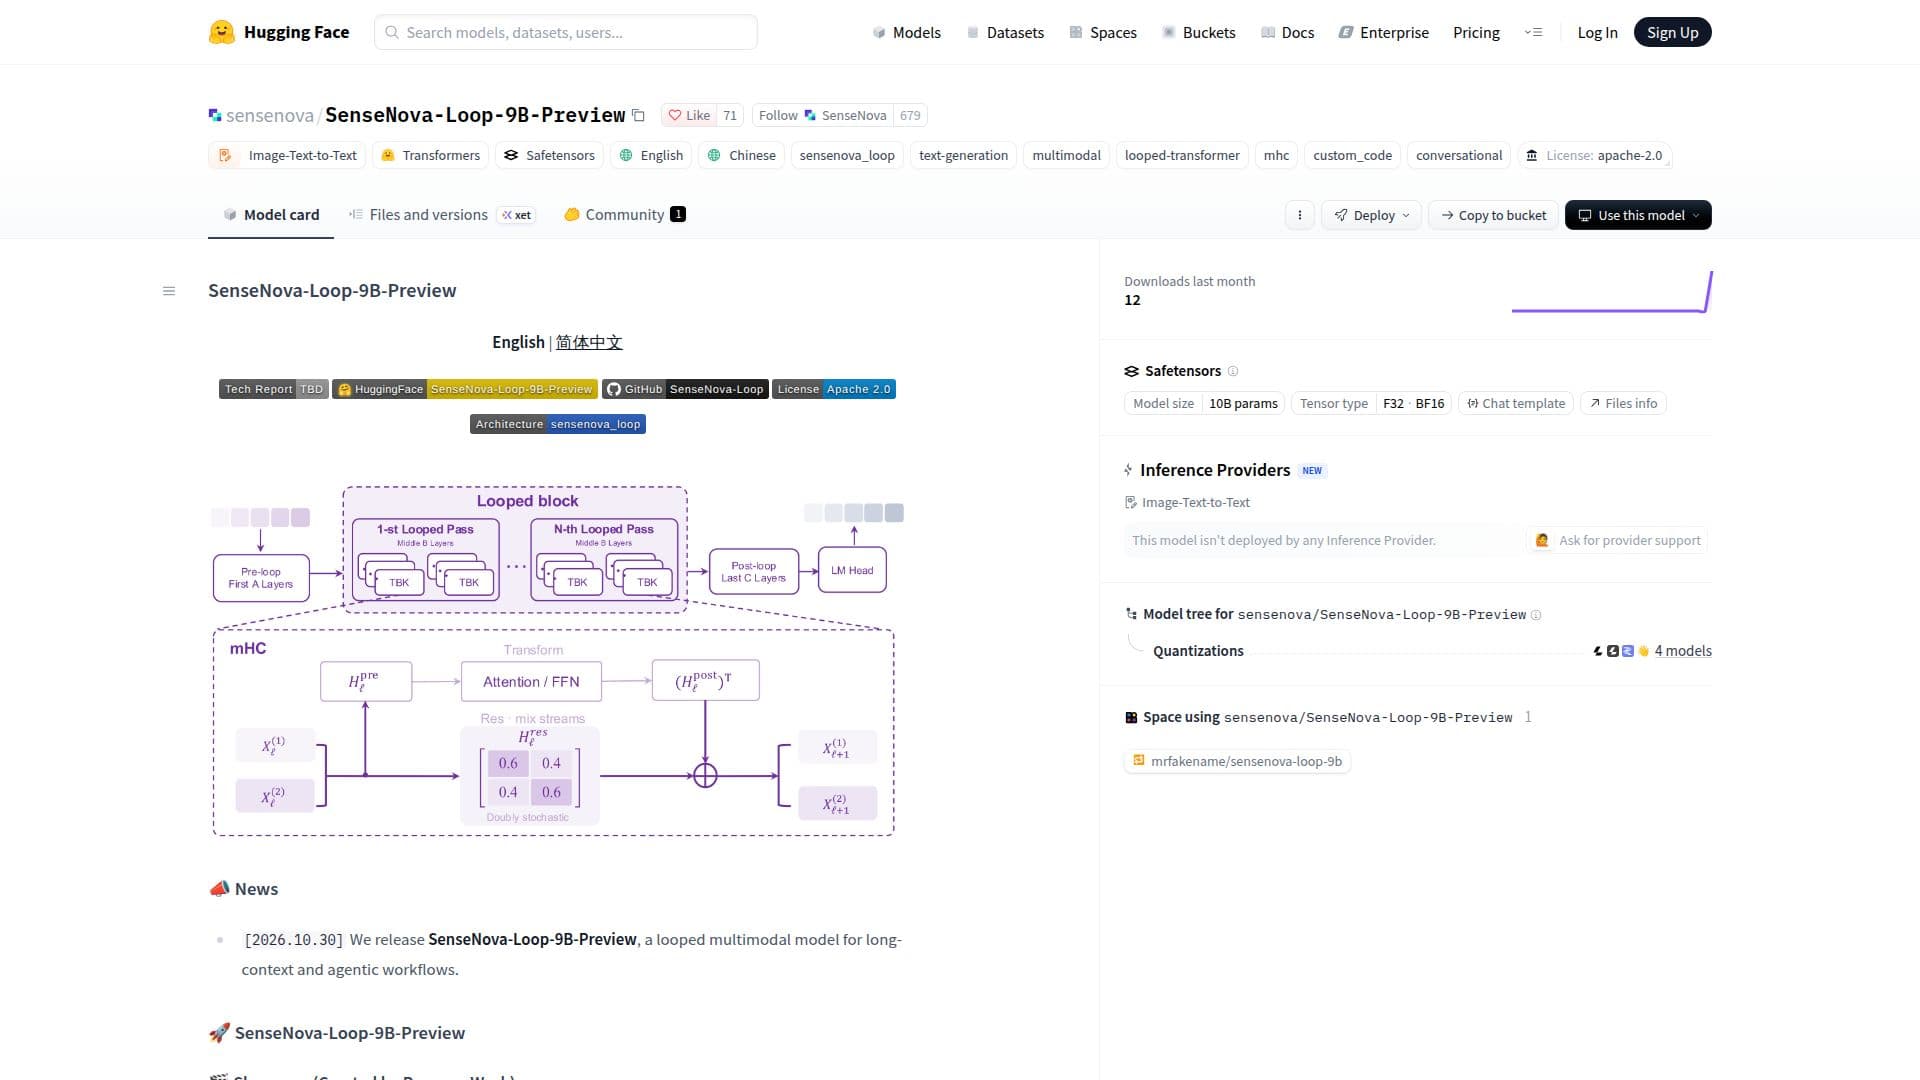
Screenshot von SenseNova-Loop-9B-Preview

SenseNova-Loop-9B-Preview ist ein fortschrittliches multimodales Sprachmodell, das entwickelt wurde, um komplexe, langanhaltende Szenarien und agentische Arbeitsabläufe zu bewältigen. Entwickelt von SenseNova, ist dieses Modell in der Lage, sowohl Text- als auch Bildeingaben zu akzeptieren und anschließend Textausgaben zu generieren. Die Hauptanwendungen umfassen Bereiche wie umfassendes Dokumentenverständnis, anspruchsvolle Programmieraufgaben und nahtlose Interaktion mit verschiedenen externen Werkzeugen.

Weiterlesen

Der Kern der Architektur von SenseNova-Loop-9B-Preview liegt in der innovativen Kombination eines geschleiften Decoders und zweistreamigen manifold-beschränkten Hyperverbindungen (mHC). Dieses Design ermöglicht es, einen zusammenhängenden Block von Decoder-Schichten zweimal mit gemeinsamen Gewichten auszuführen, was den Ausführungspfad erheblich vertieft, ohne Parameter zu duplizieren. Gelernte Zuordnungen innerhalb des mHC-Systems verwalten den Informationsfluss zwischen zwei Residualströmen im geschleiften Abschnitt effizient und verbessern die Fähigkeit des Modells, Informationen zu verarbeiten und zu synthetisieren.

Die Trainingsrezepte für das Modell beinhalten lange Sequenzen, vielfältige multimodale Eingaben und überwachte Aufgabenverläufe, wobei die maximale Trainingssequenzlänge 262.144 Tokens erreicht. Dieses umfangreiche Training ermöglicht eine robuste Leistung über ein breites Spektrum komplexer Aufgaben. Für einen optimalen Betrieb wird den Nutzern geraten, die dokumentierte Bereitstellungsumgebung und Konfigurationsparameter zu verwenden.

Zu den wichtigsten architektonischen Highlights gehört ein gemeinsamer geschleifter Block, in dem 24 Decoder-Schichten zweimal angewendet werden, was zu 56 Ausführungen von Decoder-Schichten aus nur 32 unterschiedlichen Schichten führt. Das zweistreamige mHC erleichtert intelligentes Routing und die Kombination von Informationen über die Residualströme. Darüber hinaus verwendet der Decoder einen hybriden Aufmerksamkeitsmechanismus, der lineare und vollständige Aufmerksamkeitslagen in einem sich wiederholenden vierlagigen Muster miteinander verwebt, das über die Schleifenübergänge hinweg erhalten bleibt. Das Modell unterstützt auch MTP für beschleunigte Inferenz, wobei Dspark und Dflash2 derzeit in Entwicklung sind, um die Geschwindigkeit weiter zu verbessern.

  • KategorieKI-Modelle & LLMs
  • PreismodellOpen Source
  • BereitstellungCloud
  • PlattformenWeb

  • Multimodale Eingabe: Akzeptiert sowohl Text als auch Bilder

  • Textgenerierung: Produziert Textausgaben

  • Geschleifte Decoder-Architektur: Führt Decoder-Schichten zweimal mit gemeinsamen Gewichten aus

  • Zweistreamige manifold-beschränkte Hyperverbindungen (mHC): Verwaltet den Informationsfluss zwischen Residualströmen

  • Langzeitkontextverarbeitung: Unterstützt Trainingssequenzlängen von bis zu 262.144 Tokens

  • Unterstützung für agentische Arbeitsabläufe: Entwickelt für die Interaktion mit externen Werkzeugen

  • Hybride Aufmerksamkeit: Verwebt lineare und vollständige Aufmerksamkeitslagen

  • Parameter-Effizienz: Erreicht 56 Ausführungen von Decoder-Schichten aus 32 unterschiedlichen Schichten

  • Dokumentenverständnis: In der Lage, komplexe Dokumente zu verarbeiten

  • Programmieranwendungen: Unterstützt codebezogene Aufgaben

  • MTP-Inferenzbeschleunigung: Verfügbar für schnellere Verarbeitung

  • Unterstützung für Feinabstimmung: Bietet dokumentierte Trainingsrezepte zur Anpassung

  • Apache License 2.0: Open-Source-Lizenzierung für Nutzung und Modifikation

  • Hugging Face-Integration: Verfügbar zum Download und zur Bereitstellung auf Hugging Face

  1. Zugriff auf die Modellseite: Navigieren Sie zur SenseNova-Loop-9B-Preview-Seite auf Hugging Face.

  2. Abhängigkeiten installieren: Installieren Sie PyTorch, das mit Ihrer CUDA-Umgebung kompatibel ist, und installieren Sie dann Transformers 5.18.0 und PyTorch 2.11.0.

  3. Modell laden: Verwenden Sie die Transformers-Bibliothek, um das Modell und seine benutzerdefinierte Implementierung aus dem Hugging Face-Repository oder einem lokalen Verzeichnis zu laden.

  4. Inference konfigurieren: Setzen Sie `model_id` auf die Repository-ID oder den lokalen Pfad und konfigurieren Sie Parameter wie `enable_thinking` und `device`.

  5. Text generieren: Führen Sie das bereitgestellte Python-Beispiel aus, um die Textgenerierung durchzuführen, und geben Sie die Anzahl neuer Tokens an.

  6. Modell feinabstimmen: Verwenden Sie die dokumentierten Trainingsbefehle mit Ihrem SFT-Datensatz auf einem einzelnen Knoten mit 8 GPUs zur Feinabstimmung.

  7. Modell bereitstellen: Nutzen Sie Bereitstellungsoptionen wie LightLLM oder SGLang, indem Sie den lokalen Modellpfad in den bereitgestellten Beispielen ersetzen.

  • Langzeit-Dokumentenverständnis
  • Agentische Workflow-Automatisierung
  • Multimodale Inhaltserzeugung
  • Fortgeschrittene Programmierhilfe
  • Automatisierung des PPT-Designs
  • Textgenerierung für Motion Design
  • Datenanalyse-Berichterstattung
  • Multimodale Forschung und Entwicklung
SenseNova-Loop-9B-Preview Bewertungen

Wird geladen...

Beliebte KI-Tools wie SenseNova-Loop-9B-Preview

MiniMax M3 ist ein fortschrittliches KI-Modell, das in der Programmierung und agentischen Aufgaben hervorragende Leistungen erbringt. Es verfügt über ein Kontextfenster von 1M und…

KI-Modelle & LLMs

Platz 61 in LLMs

Tool ansehen

Fortschrittliches KI-Modell, das in der Programmierung und agentischen Aufgaben hervorragende Leistungen erbringt. Es verfügt über ein Kontextfenster von 1M und…MiniMax M3 ist ein fortschrittliches KI-Modell, das in der Programmierung und agentischen Aufgaben hervorragende Leistungen erbringt. Es verfügt über ein Kontextfenster von 1M und…

KI-Modelle & LLMs
Platz 61 in LLMs

LiquidAI LFM3-1.7B ist ein Textmodell, das für lokale Agenten und spezialisierte Anwendungen entwickelt wurde. Es verfügt über eine tri-hybride Architektur und unterstützt ein…

KI-Modelle & LLMs

Platz 91 in LLMs

Tool ansehen

Textmodell, das für lokale Agenten und spezialisierte Anwendungen entwickelt wurde. Es verfügt über eine tri-hybride Architektur und unterstützt ein…LiquidAI LFM3-1.7B ist ein Textmodell, das für lokale Agenten und spezialisierte Anwendungen entwickelt wurde. Es verfügt über eine tri-hybride Architektur und unterstützt ein…

KI-Modelle & LLMs
Platz 91 in LLMs

DeepSeek-V4-Flash-Vision-Exp ist ein experimentelles multimodales Modell aus der DeepSeek-V4-Familie, das die visuellen Verständnisfähigkeiten verbessert. Es basiert auf der…

KI-Modelle & LLMs

Platz 70 in LLMs

Tool ansehen

Experimentelles multimodales Modell aus der DeepSeek-V4-Familie, das die visuellen Verständnisfähigkeiten verbessert. Es basiert auf der…DeepSeek-V4-Flash-Vision-Exp ist ein experimentelles multimodales Modell aus der DeepSeek-V4-Familie, das die visuellen Verständnisfähigkeiten verbessert. Es basiert auf der…

KI-Modelle & LLMs
Platz 70 in LLMs

Inkling-Small ist ein vielseitiges multimodales Modell, das Text-, Bild- und Audioeingaben verarbeitet, um Texte auszugeben. Es unterstützt Entwickler bei der Erstellung von…

KI-Modelle & LLMs

Platz 27 in LLMs

Tool ansehen

Vielseitiges multimodales Modell, das Text-, Bild- und Audioeingaben verarbeitet, um Texte auszugeben. Es unterstützt Entwickler bei der Erstellung von…Inkling-Small ist ein vielseitiges multimodales Modell, das Text-, Bild- und Audioeingaben verarbeitet, um Texte auszugeben. Es unterstützt Entwickler bei der Erstellung von…

KI-Modelle & LLMs
Platz 27 in LLMs

pplx-embed-v2-context-9b-preview ist ein kontextuelles Einbettungsmodell, das für Dokumentenabschnitte in RAG-Systemen entwickelt wurde. Es kodiert Dokumentenabschnitte zusammen,…

KI-Modelle & LLMs
Tool ansehen

Kontextuelles Einbettungsmodell, das für Dokumentenabschnitte in RAG-Systemen entwickelt wurde. Es kodiert Dokumentenabschnitte zusammen,…pplx-embed-v2-context-9b-preview ist ein kontextuelles Einbettungsmodell, das für Dokumentenabschnitte in RAG-Systemen entwickelt wurde. Es kodiert Dokumentenabschnitte zusammen,…

KI-Modelle & LLMs
Top 5 KI-Modelle ansehen

DeepSeek V4 Flash ist eine Sammlung von KI-Modellen, die für fortgeschrittene Textgenerierungsaufgaben entwickelt wurde. Sie nutzt Prinzipien der Open Source und der offenen…

KI-Modelle & LLMs
Tool ansehen

Sammlung von KI-Modellen, die für fortgeschrittene Textgenerierungsaufgaben entwickelt wurde. Sie nutzt Prinzipien der Open Source und der offenen…DeepSeek V4 Flash ist eine Sammlung von KI-Modellen, die für fortgeschrittene Textgenerierungsaufgaben entwickelt wurde. Sie nutzt Prinzipien der Open Source und der offenen…

KI-Modelle & LLMs
Top 5 KI-Modelle ansehen

Muse Spark 1.3

KI-Modelle

Muse Spark 1.3 ist Metas KI-Modell für agentische und Programmier-Workflows, entwickelt für langfristige Aufgaben, die zuverlässiges Tool-Calling und mehrstufiges Denken…

KI-Modelle & LLMs
Tool ansehen

KI-Modelle

Metas KI-Modell für agentische und Programmier-Workflows, entwickelt für langfristige Aufgaben, die zuverlässiges Tool-Calling und mehrstufiges Denken…Muse Spark 1.3 ist Metas KI-Modell für agentische und Programmier-Workflows, entwickelt für langfristige Aufgaben, die zuverlässiges Tool-Calling und mehrstufiges Denken…

EmpfohlenKI-Modelle & LLMs
Top 5 KI-Modelle ansehen

LLaVA

KI-GitHub-Repos

LLaVA ist ein Modell für visuelles Instruction Tuning, das große Sprach- und Bildfähigkeiten kombiniert. Es zielt darauf ab, eine Leistung auf GPT-4V-Niveau zu erreichen und…

KI-Modelle & LLMs
Tool ansehen

KI-GitHub-Repos

Modell für visuelles Instruction Tuning, das große Sprach- und Bildfähigkeiten kombiniert. Es zielt darauf ab, eine Leistung auf GPT-4V-Niveau zu erreichen und…LLaVA ist ein Modell für visuelles Instruction Tuning, das große Sprach- und Bildfähigkeiten kombiniert. Es zielt darauf ab, eine Leistung auf GPT-4V-Niveau zu erreichen und…

KI-Modelle & LLMs
Top 250 KI-GitHub-Repos ansehen
1 von 8