Beschreibung
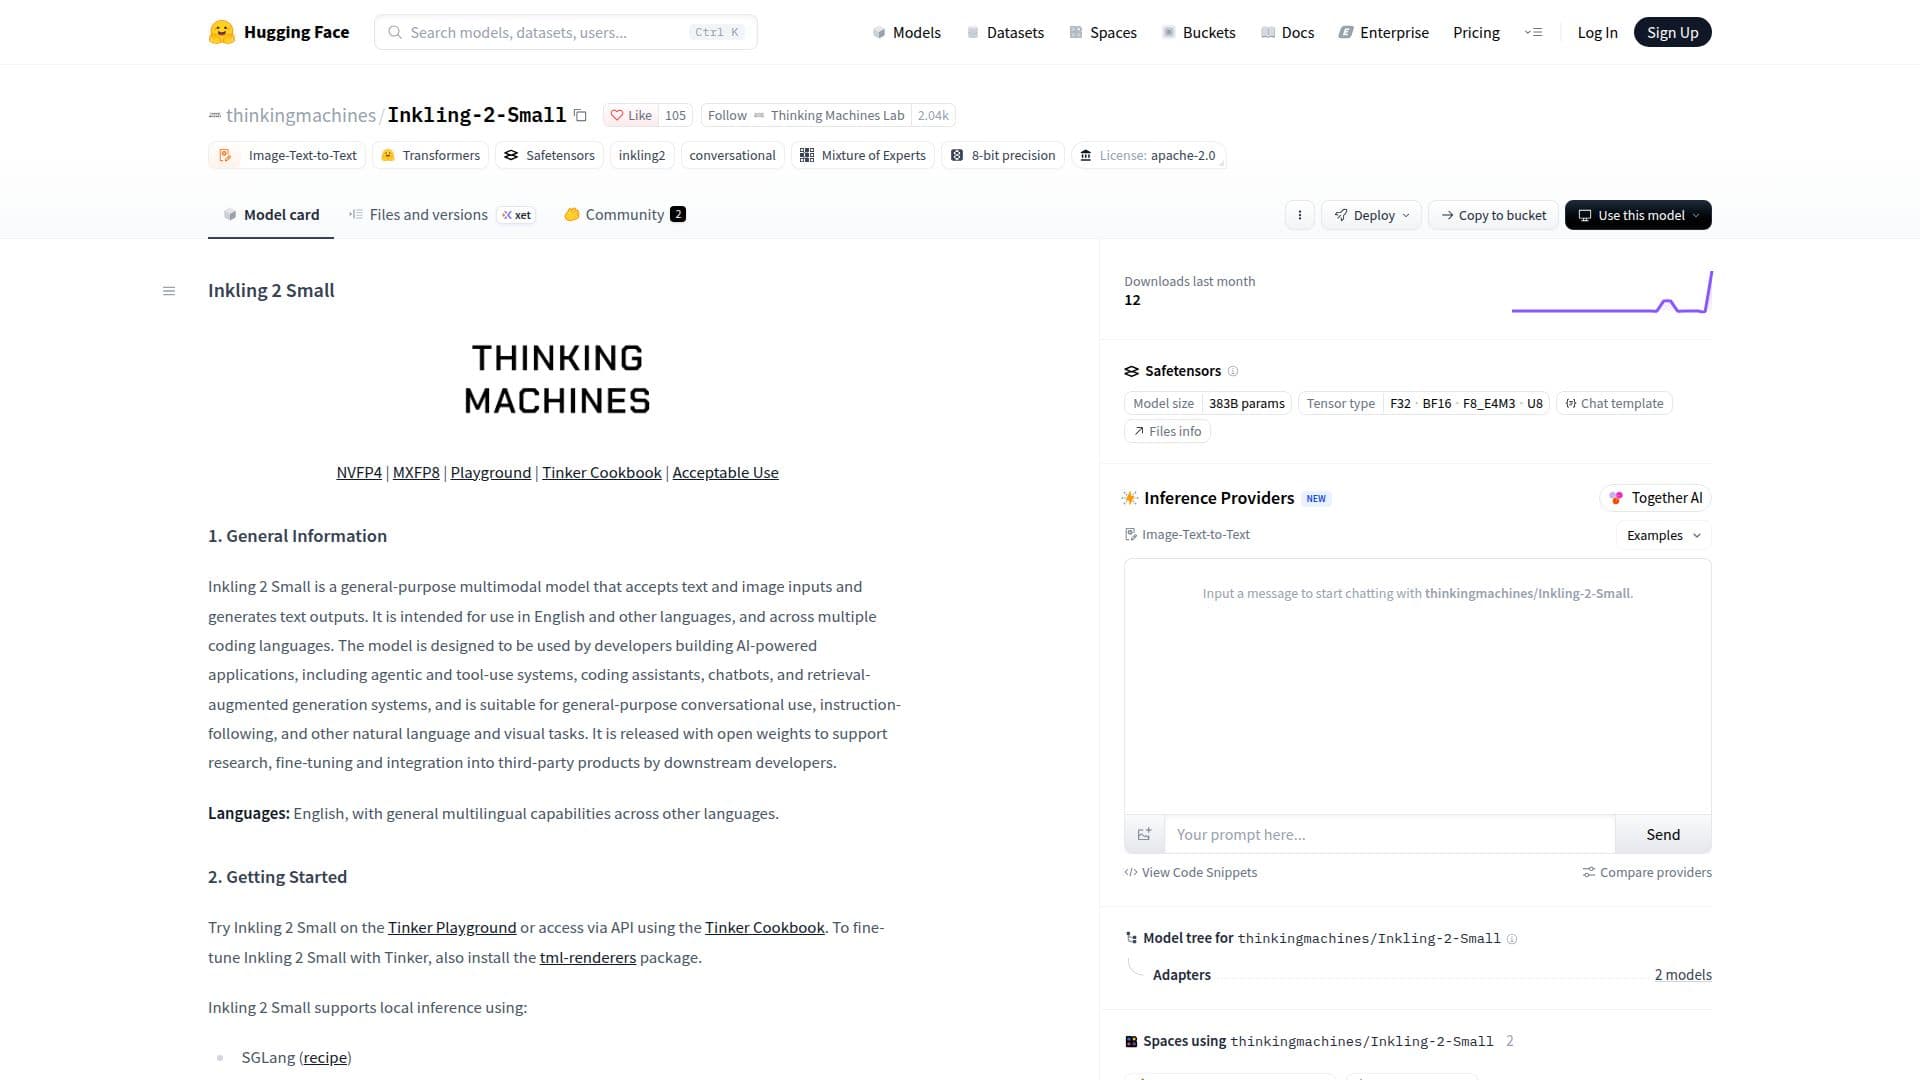
Inkling 2 Small ist ein vielseitiges multimodales Modell, das in der Lage ist, Text- und Bildinputs zu verarbeiten, um Textausgaben zu erzeugen. Es ist für eine breite Anwendbarkeit konzipiert und unterstützt Englisch sowie andere Sprachen und verschiedene Programmiersprachen. Das Modell richtet sich speziell an Entwickler, die KI-gestützte Anwendungen erstellen, wie agentische und werkzeugbasierte Systeme, Codierungsassistenten, Chatbots und retrieval-augmentierte Generierung (RAG) Systeme. Sein Design macht es auch geeignet für allgemeine konversationelle Interaktionen, das Befolgen von Anweisungen und eine Vielzahl von Aufgaben in natürlicher Sprache und visuellen Bereichen.
Weiterlesen
Inkling 2 Small wird mit offenen Gewichten veröffentlicht und fördert Forschung, Feinabstimmung und Integration in Produkte von Drittanbietern durch nachgelagerte Entwickler. Benutzer können mit dem Modell im Tinker Playground experimentieren oder über die API auf es zugreifen, indem sie das Tinker Cookbook verwenden. Für die Feinabstimmung mit Tinker ist das Paket tml-renderers erforderlich. Das Modell unterstützt lokale Inferenz durch verschiedene Frameworks, einschließlich SGLang, vLLM, TokenSpeed und Unsloth. Darüber hinaus kann es mit Miles, SkyRL und Snowflake Cortex Training nachtrainiert werden. Der API-Zugang ist auch über Drittanbieter wie NVIDIA, Fireworks, Together, Baseten, Nebius, Modal und Cloudflare verfügbar.
Die Hardwareanforderungen für Inkling 2 Small hängen vom Checkpoint-Format ab. Der Haupt-NVFP4-Checkpoint erfordert einen GPU-Cluster mit mindestens 500 GB aggregiertem VRAM, was mit Konfigurationen wie 2x NVIDIA B300 GPUs oder 4x NVIDIA H200 GPUs erreicht werden kann. Der alternative MXFP8-Checkpoint benötigt mindestens 800 GB aggregierten VRAM, was durch 4x NVIDIA B300 GPUs oder 8x NVIDIA H200 GPUs erfüllt wird. Der NVFP4-Checkpoint wird für alle Anwendungsfälle empfohlen, da er die native Präzision für das Modell bietet und optimale Leistung gewährleistet.
Architektonisch ist Inkling 2 Small ein multimodaler autoregressiver Transformer. Es verfügt über einen 48-schichtigen Decoder-Only-Transformer mit einem spärlichen Mixture-of-Experts (MoE) Feed-Forward-Rückgrat, bei dem jedes Token an 8 von 384 Experten weitergeleitet wird. Sein Aufmerksamkeitsmechanismus kombiniert lokale und globale Schichten. Das Modell ist nativ multimodal, kodiert Bilder über einen Vision-Transformer und projiziert sowohl Bild- als auch Texteingaben in einen gemeinsamen verborgenen Raum für die gemeinsame Verarbeitung durch den Decoder. Es unterstützt ein Kontextfenster von bis zu 1 Million Tokens und akzeptiert Text in UTF-8-Kodierung sowie pixelbasierte Bildformate (idealerweise zwischen 40px und 4096px pro Dimension). Ausgaben werden als UTF-8-kodierter Text generiert.
Die Trainingsdaten für Inkling 2 Small umfassen eine Vielzahl von Inhaltstypen, wie Text, Bilder und Videos, die aus öffentlich verfügbaren Repositories, Dritten, interner Generierung und synthetischer Augmentierung stammen. Der Datenkuratierungsprozess umfasst das Bereinigen, Verarbeiten und Modifizieren von Datensätzen, einschließlich Duplikatentfernung und Qualitäts- sowie Sicherheitsfilterung. Sicherheitsbewertungen wurden in Bezug auf alltägliche Mensch-KI-Interaktionen und Tests gefährlicher Fähigkeiten durchgeführt, wobei Maßnahmen ergriffen wurden, um Risiken zu minimieren. Das Wissen des Modells ist auf seinen Trainingsstopp beschränkt, und Benutzern wird geraten, menschliche Aufsicht für Anwendungen mit hohen Einsätzen anzuwenden, da potenzielle Einschränkungen wie Halluzinationen und Vorurteile aus den Trainingsdaten bestehen können.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Source
- BereitstellungCloud, Selbst gehostet
- PlattformenWeb
Inkling 2 Small im Überblick
Multimodale Eingabe: Akzeptiert sowohl Text- als auch Bildinputs
Textausgabe: Generiert UTF-8-kodierte Textausgaben
Allzweckmodell: Geeignet für eine Vielzahl von Anwendungen
Mehrsprachige Fähigkeiten: Unterstützt Englisch und andere Sprachen
Unterstützung mehrerer Programmiersprachen: Funktioniert mit verschiedenen Programmiersprachen
Offene Gewichte: Verfügbar für Forschung, Feinabstimmung und Integration
API-Zugang: Zugänglich über das Tinker Cookbook und Drittanbieter
Unterstützung lokaler Inferenz: Kompatibel mit SGLang, vLLM, TokenSpeed, Unsloth
Nachtrainierungsoptionen: Kann mit Miles, SkyRL, Snowflake Cortex Training nachtrainiert werden
Autoregressiver Transformer: Nutzt eine 48-schichtige Decoder-Only-Architektur
Mixture-of-Experts (MoE): Spärliches Feed-Forward-Rückgrat mit 384 Experten
Gemeinsamer verborgener Raum: Verarbeitet Bild- und Texteingaben gemeinsam
Kontextfenster: Unterstützt bis zu 1 Million Tokens
Hohe Parameteranzahl: 594B Gesamtparameter, 17B aktiv
Erste Schritte mit Inkling 2 Small
Modellzugang: Besuchen Sie die Inkling 2 Small-Seite auf Hugging Face.
Spielplatz ausprobieren: Experimentieren Sie direkt im Tinker Playground mit dem Modell.
Zugang über API: Verwenden Sie das Tinker Cookbook, um das Modell über seine API zu integrieren.
Modell feinabstimmen: Installieren Sie das Paket tml-renderers, um Inkling 2 Small mit Tinker feinabzustimmen.
Lokale Inferenz: Nutzen Sie Frameworks wie SGLang, vLLM, TokenSpeed oder Unsloth für die lokale Bereitstellung.
Nachtrainieren: Verbessern Sie das Modell mit Miles, SkyRL oder Snowflake Cortex Training.
Bereitstellung mit Anbietern: Greifen Sie über Drittanbieter wie NVIDIA oder Fireworks auf die API zu.
Hardware konfigurieren: Stellen Sie sicher, dass ein GPU-Cluster mit mindestens 500 GB VRAM für NVFP4 oder 800 GB für MXFP8-Checkpoint vorhanden ist.
Inkling 2 Small's Anwendungsfälle
- Entwicklung von KI-Anwendungen
- Entwicklung agentischer Systeme
- Codierungsassistenten
- Chatbot-Erstellung
- Retrieval-augmentierte Generierung
- Allgemeine konversationelle Nutzung
- Befolgen von Anweisungen
- Visuelle Aufgaben
- Forschung und Experimentation
- Integration in Produkte von Drittanbietern