Beschreibung
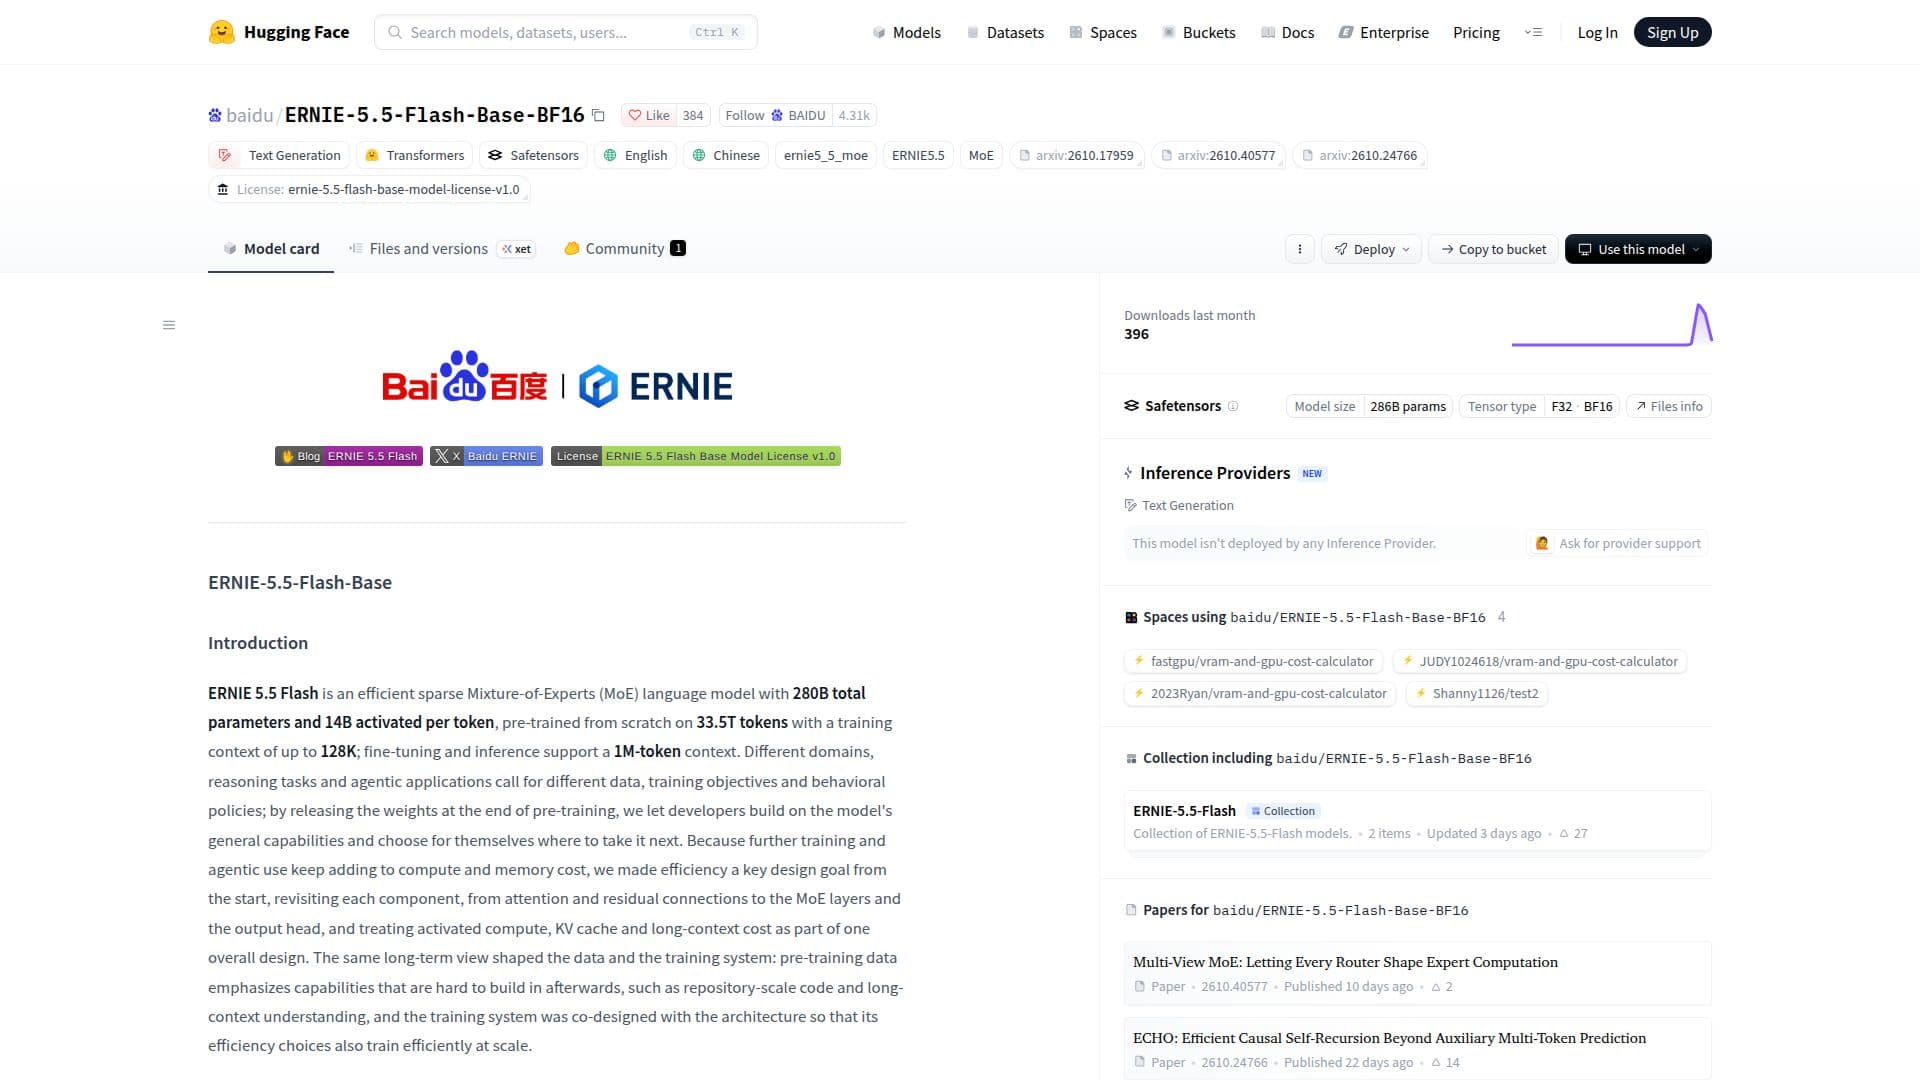
ERNIE-5.5-Flash-Base-BF16 ist ein anspruchsvolles sparsames Mixture-of-Experts (MoE) Sprachmodell, das von Baidu entwickelt wurde. Es verfügt über insgesamt 280 Milliarden Parameter, von denen 14 Milliarden pro Token aktiviert werden, was es äußerst effizient für komplexe Sprachaufgaben macht. Das Modell wurde von Grund auf auf einem umfangreichen Datensatz von 33,5 Billionen Tokens vortrainiert und nutzt einen Trainingskontext von bis zu 128.000 Tokens. Für Fine-Tuning und Inferenz unterstützt es eine beeindruckende Kontextlänge von 1 Million Tokens, die ein tiefes Verständnis und die Generierung von Langtextinhalten ermöglicht.
Weiterlesen
Mit Effizienz als Kernprinzip überarbeitet ERNIE 5.5 Flash jede Komponente, von Aufmerksamkeitsmechanismen und Residualverbindungen bis hin zu MoE-Schichten und dem Ausgabekopf. Dieser ganzheitliche Ansatz gewährleistet optimale Leistung bei der Verwaltung von Rechenressourcen, KV-Cache und Kosten für Langkontexte. Die Vortrainingsdaten betonen Fähigkeiten, die für fortgeschrittene Anwendungen entscheidend sind, wie das Verständnis von Code im Repository-Maßstab und das Verständnis von Langkontexten, was Entwicklern ermöglicht, auf seinen allgemeinen Fähigkeiten für vielfältige Anwendungsfälle aufzubauen.
ERNIE-5.5-Flash-Base-BF16 stellt den Checkpoint am Ende des Vortrainings dar und dient als grundlegendes Modell vor allen Zwischen- oder Nachtrainingsphasen. Dies macht es zu einem idealen Ausgangspunkt für Forscher und Entwickler, die sich mit Domänenanpassung, Instruktions-Tuning und Reinforcement Learning beschäftigen. Das Modell hat in einer einheitlichen Evaluierungs-Pipeline starke Ergebnisse gezeigt und in Benchmarks zu Wissen, Schlussfolgerungen, Mathematik, Code, mehrsprachigen Aufgaben und dem Verständnis von Langkontexten hervorragend abgeschnitten.
Die Architektur umfasst ein 280B-A14B Hybrid-Attention MoE mit 43 Schichten, darunter 1 dichte FFN und 42 Multi-Router Latent MoE-Schichten. Es verfügt über 37 Heavily Compressed Attention (HCA) Schichten und 6 Multi-head Latent Attention (MLA + DSA) Schichten mit sparsamer Aufmerksamkeit. Das Modell nutzt 512 geroutete Experten (Top-10) plus 1 gemeinsamen Experten pro MoE-Schicht. Innovationen wie Low-Rank Gated Attention, Virtual Head Attention (VHA), Multi-Router Latent MoE, ECHO, manifold-constrained Hyper-Connections (mHC) und MultiMax Output Head tragen zu seinen fortschrittlichen Fähigkeiten und seiner Effizienz bei. Der Tokenizer unterstützt etwa 200.000 Einträge und tokenisiert Zahlen von rechts nach links in Gruppen von bis zu drei Ziffern.
Die Bereitstellung wird mit SGLang und vLLM unterstützt, was eine Produktionsbereitstellung mit Kontextlängen von bis zu 1.048.576 Tokens ermöglicht. Das Modell ist unter der ERNIE 5.5 Flash Base Model License Agreement v1.0 verfügbar.
- KategorieKI-Modelle & LLMs
- BereitstellungCloud
- PlattformenWeb
ERNIE-5.5-Flash-Base-BF16 im Überblick
280 Milliarden Gesamtparameter
14 Milliarden aktivierte Parameter pro Token
Vortrainiert auf 33,5 Billionen Tokens
Training Kontext bis zu 128.000 Tokens
Fine-Tuning und Inferenz unterstützen 1 Million-Token Kontext
Effiziente sparsames Mixture-of-Experts (MoE) Architektur
Hybrid-Attention MoE mit 43 Schichten
37 Heavily Compressed Attention (HCA) Schichten
6 Multi-head Latent Attention (MLA + DSA) Schichten
512 geroutete Experten (Top-10) plus 1 gemeinsamer Experte pro MoE-Schicht
Low-Rank Gated Attention und Virtual Head Attention (VHA)
Multi-Router Latent MoE für präzise Expertenauswahl
ECHO für Multi-Horizon-Verlust und spekulative Dekodierung
Manifold-constrained Hyper-Connections (mHC) für Signalübertragung
MultiMax Output Head für schärfere Wortschatzverteilung
Etwa 200.000-Eintrag BPE-Tokenizer
Unterstützung für SGLang und vLLM für Produktionsbereitstellung
Erste Schritte mit ERNIE-5.5-Flash-Base-BF16
Zugriff auf die Modellseite: Navigieren Sie zur ERNIE-5.5-Flash-Base-BF16 Seite auf Hugging Face.
Dateien erkunden: Überprüfen Sie die auf der Seite verfügbaren Modell-Dateien und Dokumentationen.
Modell herunterladen: Laden Sie den ERNIE-5.5-Flash-Base-BF16 Modell-Checkpoint herunter.
vLLM und Plugin installieren: Installieren Sie vLLM und das ERNIE 5.5 Plugin für die Bereitstellung.
Server starten: Verwenden Sie SGLang oder vLLM, um den Modellserver zu starten.
Anfragen senden: Senden Sie Anfragen an den Completions-Endpunkt mit Tools wie curl für die Inferenz.
ERNIE-5.5-Flash-Base-BF16's Anwendungsfälle
- Textgenerierung
- Domänenanpassung
- Instruktions-Tuning
- Forschung im Bereich Reinforcement Learning
- Codeverständnis
- Langkontextverständnis
- Mehrsprachige Anwendungen
- Schlussfolgerungsaufgaben
- Agentische Anwendungen