Beschreibung
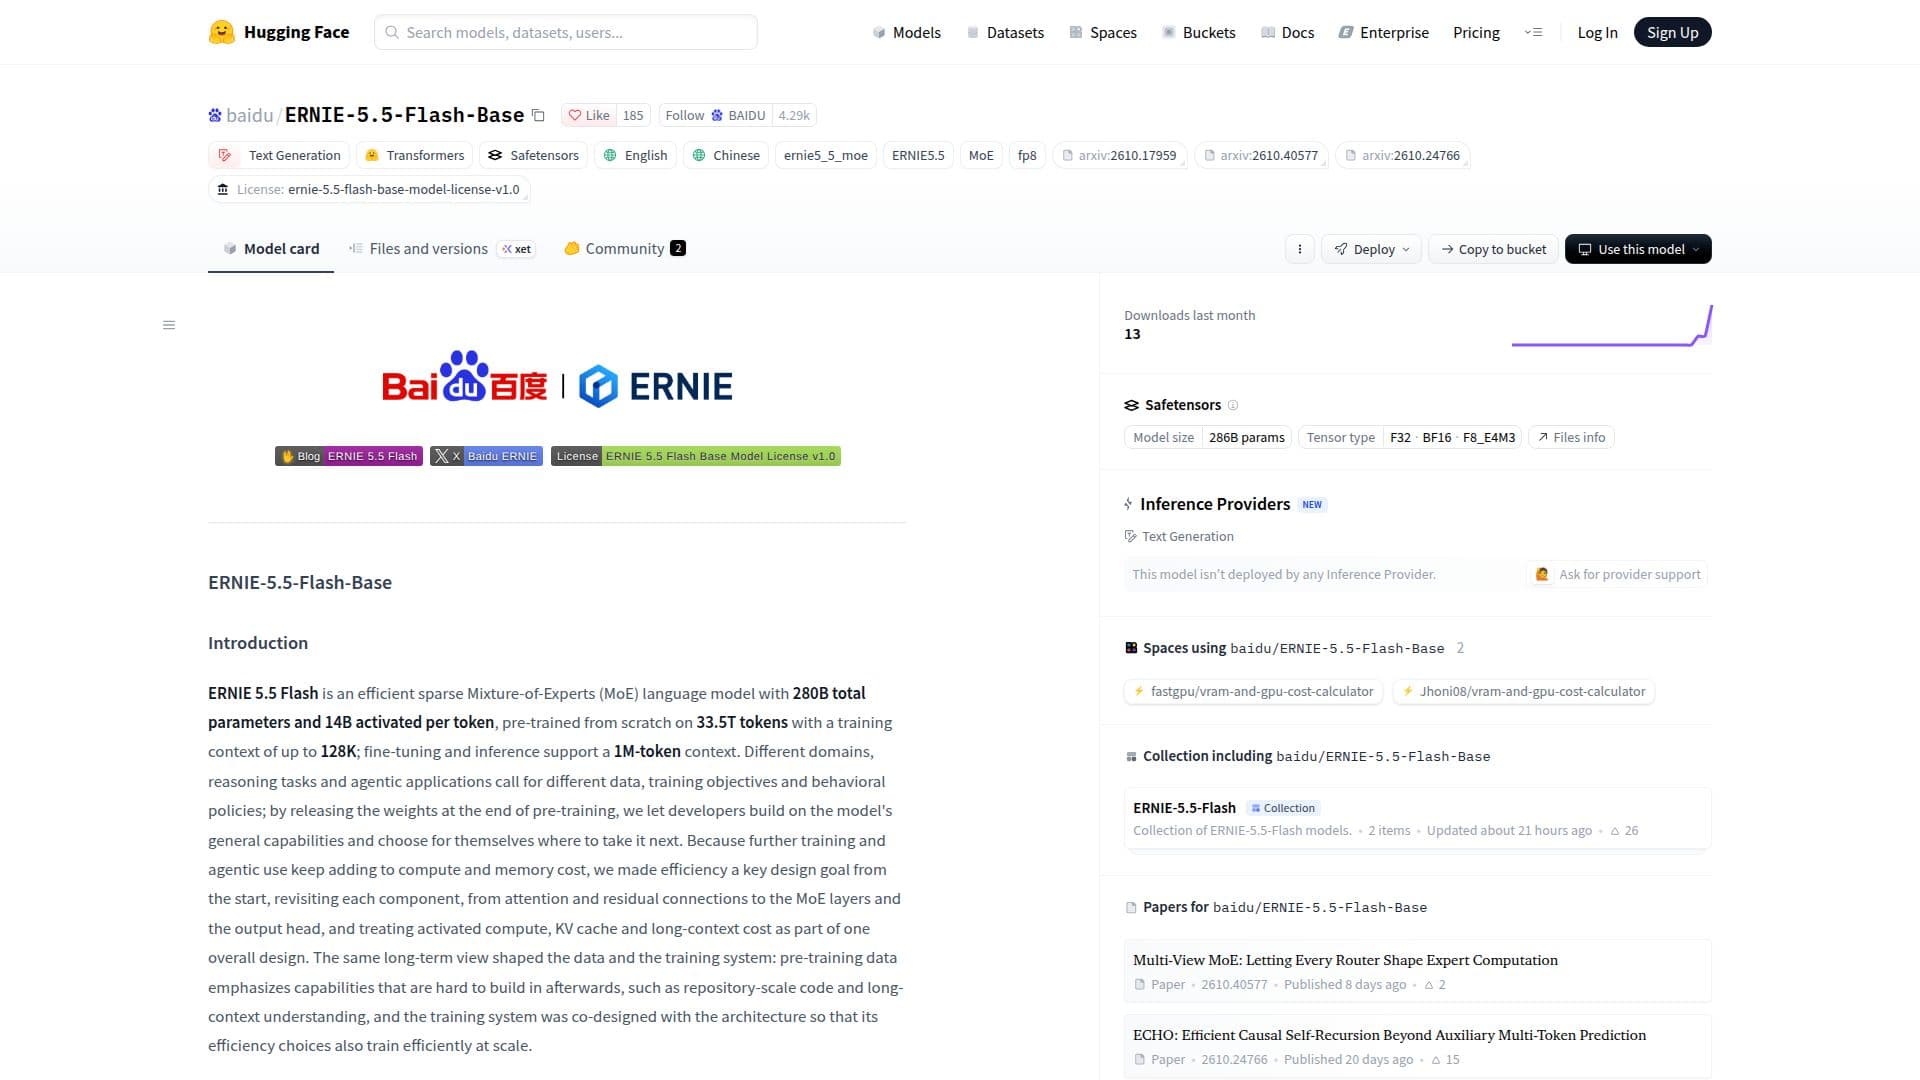
ERNIE-5.5-Flash-Base ist ein anspruchsvolles Textgenerierungsmodell, das von Baidu entwickelt wurde und auf Hugging Face verfügbar ist. Es handelt sich um ein effizientes sparsames Mixture-of-Experts (MoE) Sprachmodell mit insgesamt 280 Milliarden Parametern, wobei 14 Milliarden pro Token aktiviert sind. Das Modell wurde von Grund auf auf einem umfangreichen Datensatz von 33,5 Billionen Tokens vortrainiert und nutzt einen Trainingskontext von bis zu 128K. Für Fine-Tuning und Inferenz unterstützt es eine beeindruckende Kontextlänge von 1 Million Tokens.
Weiterlesen
Mit Effizienz als Kernziel wurde ERNIE 5.5 Flash in jedem Bestandteil überarbeitet, von Aufmerksamkeitsmechanismen und Residualverbindungen bis hin zu MoE-Schichten und dem Ausgabekopf. Dieser ganzheitliche Ansatz berücksichtigt aktivierte Berechnungen, KV-Cache und Kosten für lange Kontexte als Teil eines integrierten Designs. Die Vortrainingsdaten betonen Fähigkeiten, die nach dem Training schwer zu entwickeln sind, wie das Verständnis von Code im Repository-Maßstab und das Verständnis von langen Kontexten. Das Trainingssystem wurde gemeinsam mit der Architektur entworfen, um eine effiziente Skalierung zu gewährleisten.
ERNIE-5.5-Flash-Base stellt den Checkpoint am Ende des Vortrainings dar und ist somit eine ideale Grundlage für Entwickler. Es ermöglicht die Anpassung an spezifische Domänen, Instruction Tuning und Forschung im Bereich Reinforcement Learning. Das Modell zeigt starke Ergebnisse in einer einheitlichen Evaluierungspipeline, die Wissen, Schlussfolgerungen, Mathematik, Code, mehrsprachige Aufgaben und Benchmarks für lange Kontexte abdeckt. Seine Leistung wird mit anderen großen Modellen wie DeepSeek-V4-Flash-Base, Hy3-preview-Base und MiMo-V2.5-Base verglichen, die alle unter konsistenten Bedingungen bewertet wurden.
Die Architektur umfasst ein 280B-A14B Hybrid-Attention MoE mit 43 Schichten, darunter 1 dichte FFN und 42 Multi-Router Latent MoE-Schichten. Es verfügt über 37 Heavily Compressed Attention (HCA) Schichten und 6 Multi-Head Latent Attention Schichten mit sparsamer Aufmerksamkeit (MLA + DSA). Das Modell nutzt 512 geroutete Experten (Top-10) sowie 1 gemeinsamen Experten pro MoE-Schicht. Zu den wichtigsten Innovationen gehören Hybrid MLA + HCA-Attention mit schichtenspezifischen Kopfdimensionen, Low-Rank Gated Attention, Virtual Head Attention (VHA), Multi-Router Latent MoE, ECHO für die Vorhersage zukünftiger Tokens, manifold-beschränkte Hyper-Verbindungen (mHC) und ein MultiMax Output Head. Der Tokenizer verwendet einen ≈200K-Einträge BPE-Tokenizer, der Zahlen von rechts nach links in Gruppen von bis zu drei Ziffern tokenisiert.
Die Bereitstellung von ERNIE-5.5-Flash-Base wird durch SGLang und vLLM unterstützt, was die Produktionsbereitstellung mit Kontextlängen von bis zu 1.048.576 Tokens für die Inferenz mit langen Kontexten ermöglicht. Das Modell wird unter der ERNIE 5.5 Flash Base Model License Agreement v1.0 bereitgestellt, mit dem Urheberrecht, das bei Baidu liegt.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Source
- BereitstellungCloud
- PlattformenWeb
ERNIE-5.5-Flash-Base im Überblick
280B Gesamtparameter mit 14B aktivierten pro Token
Vortrainiert auf 33,5T Tokens
Unterstützt 1M-Token-Kontext für Fine-Tuning und Inferenz
Effiziente sparsames Mixture-of-Experts (MoE) Architektur
Hybrid MLA + HCA-Attention mit schichtenspezifischen Kopfdimensionen
Low-Rank Gated Attention und Virtual Head Attention (VHA)
Multi-Router Latent MoE mit 512 gerouteten Experten und 1 gemeinsamen Experten
ECHO für Multi-Horizon-Verlust und spekulative Dekodierung
Manifold-beschränkte Hyper-Verbindungen (mHC) für Signalpropagation
MultiMax Output Head für schärfere Wortschatzverteilung
≈200K-Einträge BPE-Tokenizer mit rechts-nach-links-Zahlentokenisierung
Unterstützt Bereitstellung mit SGLang und vLLM
Starke Leistung in den Bereichen Wissen, Schlussfolgerungen, Mathematik, Code, mehrsprachige und lange Kontext-Benchmarks
FP8 und BF16 Präzisionsgewichte verfügbar
Erste Schritte mit ERNIE-5.5-Flash-Base
Modellzugriff: Navigieren Sie zur ERNIE-5.5-Flash-Base-Seite auf Hugging Face.
Modell herunterladen: Wählen Sie zwischen FP8 (safetensors) oder BF16 (safetensors) Präzision zum Herunterladen.
Bereitstellungstools installieren: Installieren Sie vLLM und das ERNIE 5.5 Plugin oder verwenden Sie das offizielle SGLang vorgefertigte Docker-Image.
Server starten: Starten Sie den vLLM- oder SGLang-Server, um das Modell zu hosten.
Anfragen senden: Verwenden Sie curl oder andere API-Clients, um Anfragen an den Completions-Endpunkt zur Textgenerierung zu senden.
Modell feinabstimmen: Nutzen Sie den vortrainierten Checkpoint für die Anpassung an spezifische Domänen, Instruction Tuning oder Forschung im Bereich Reinforcement Learning.
ERNIE-5.5-Flash-Base's Anwendungsfälle
- Textgenerierung
- Domänenanpassung
- Instruction Tuning
- Forschung im Bereich Reinforcement Learning
- Codegenerierung und -verständnis
- Verständnis von langen Kontexten
- Mehrsprachige Anwendungen
- Schlussfolgerungsaufgaben