Beschreibung
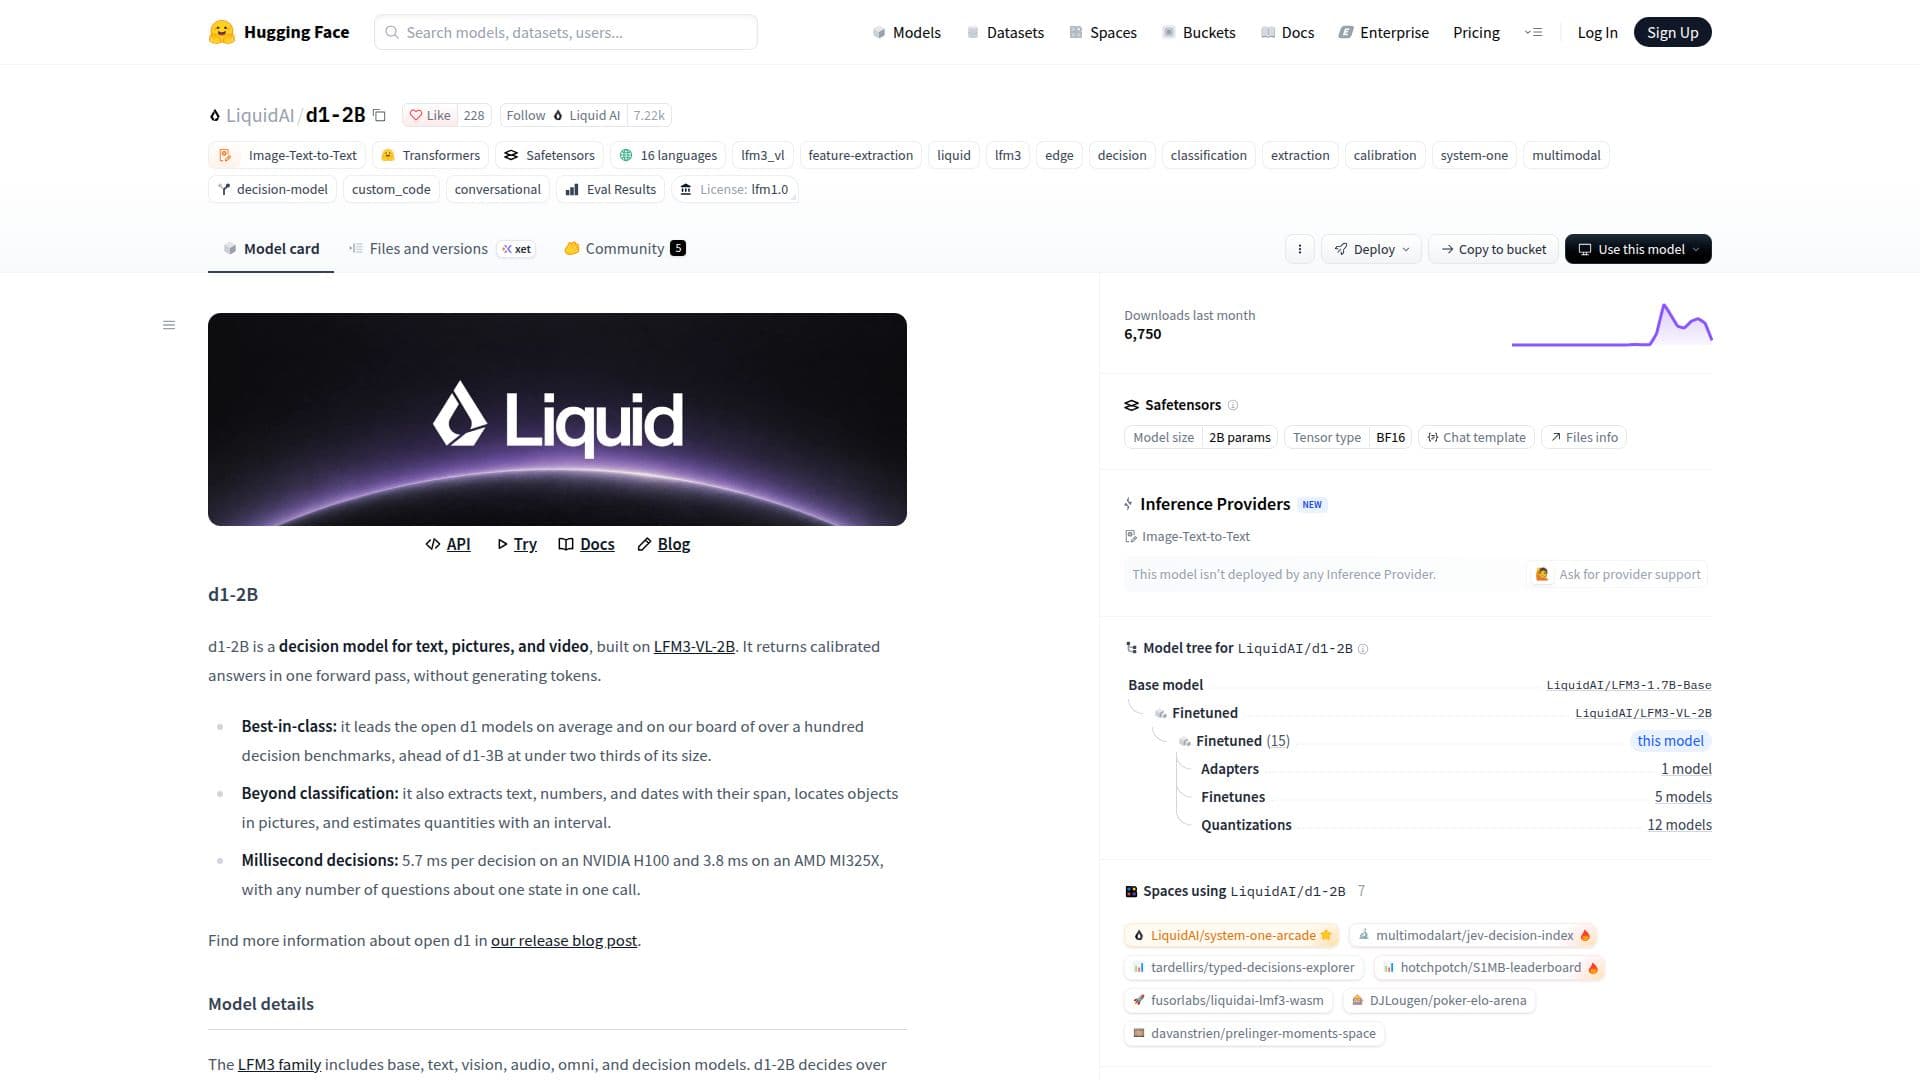
d1-2B ist ein hocheffizientes Entscheidungsmodell, das von LiquidAI entwickelt wurde und auf Hugging Face verfügbar ist. Basierend auf der Architektur von LFM3-VL-2B ist dieses Modell darauf ausgelegt, multimodale Eingaben, einschließlich Text, Bilder und Videos, zu verarbeiten und Entscheidungen zu treffen. Ein zentrales Merkmal von d1-2B ist seine Fähigkeit, kalibrierte Antworten in einem einzigen Vorwärtsdurchlauf zurückzugeben, wodurch die Notwendigkeit der Token-Generierung entfällt, was zu seiner Geschwindigkeit und Effizienz beiträgt.
Weiterlesen
Das Modell zeigt eine Best-in-Class-Leistung unter den offenen d1-Modellen und führt im Durchschnitt über hundert Entscheidungsbenchmarks. Trotz seiner kleineren Größe im Vergleich zu d1-3B übertrifft es dieses oft und demonstriert sein optimiertes Design. Über traditionelle Klassifikationsaufgaben hinaus bietet d1-2B fortgeschrittene Fähigkeiten wie das Extrahieren spezifischer Texte, Zahlen und Daten mit ihren Zeitspannen, das präzise Lokalisieren von Objekten in Bildern und das Schätzen von Mengen mit definierten Intervallen.
Die Leistung ist ein wesentlicher Vorteil, da d1-2B Entscheidungszeiten von 5,7 Millisekunden auf einem NVIDIA H100 und 3,8 Millisekunden auf einem AMD MI325X erreicht. Diese schnelle Verarbeitung wird selbst bei mehreren Fragen zu einem einzigen Zustand in einem Aufruf aufrechterhalten. Die LFM3-Familie, zu der auch d1-2B gehört, umfasst Basis-, Text-, Bild-, Audio-, Omni- und Entscheidungsmodelle. Während d1-2B Texte, Bilder und Videos verarbeitet, erweitert sein Geschwistermodell d1-Omni-2B die Fähigkeiten um Audio.
Mit 1,92 Milliarden Parametern und einer LFM3-Rückenarchitektur, die aus 24 Schichten besteht (13 gated short convolutions, 5 sliding-window attention, 6 global attention), unterstützt d1-2B eine Kontextlänge von 128K Tokens und ein Vokabular von 128.000 Tokens. Es akzeptiert Eingaben als Zustand (Text oder JSON), Bilder oder Videos, zusammen mit beliebig vielen benannten Fragen und produziert typisierte Antworten mit Wahrscheinlichkeiten, ohne Tokens zu generieren. Es unterstützt eine breite Palette von Sprachen, darunter Englisch, Arabisch, Chinesisch, Französisch, Deutsch, Italienisch, Japanisch, Koreanisch, Portugiesisch, Spanisch, Vietnamesisch, Thailändisch, Indonesisch, Hindi, Russisch und Polnisch.
d1-2B ist vielseitig und eignet sich für verschiedene Pipeline-Schritte, die Entscheidungen erfordern, wie Routing und Triage, Inhaltsmoderation, Absicht und Themenklassifikation, Datenauszug aus Dokumenten, Bewertung und Neurangierung sowie visuelle Inspektion. Es wird ausdrücklich darauf hingewiesen, dass es sich nicht um ein Chat-Modell handelt. Während es für wissensintensive Fragen effektiv ist, kann die Zuverlässigkeit über 64K Tokens des Zustands abnehmen. Schätzungen sind zuverlässig für Zählungen und Punktzahlen, jedoch weniger für freie Mengen. Das Modell läuft in Transformers mit eigenem Code und benötigt keine Sampling-Parameter.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Source
- BereitstellungCloud
- PlattformenWeb
d1-2B im Überblick
Multimodales Entscheidungsmodell (Text, Bilder, Video)
2 Milliarden Parameter
Einzelner Vorwärtsdurchlauf für kalibrierte Antworten
Keine Token-Generierung
Best-in-Class-Leistung bei Entscheidungsbenchmarks
Texte, Zahlen und Datenauszug
Objektlokalisierung in Bildern
Mengenschätzung mit Intervallen
Entscheidungsgeschwindigkeit in Millisekunden (z.B. 3,8 ms auf AMD MI325X)
LFM3-Rückenarchitektur
128K Token Kontextlänge
128.000 Token Vokabular
Mehrsprachige Unterstützung (15+ Sprachen)
Entwickelt für Routing, Triage, Moderation, Extraktion
Läuft in Transformers mit benutzerdefiniertem Modellcode
Erste Schritte mit d1-2B
Modellseite aufrufen: Navigieren Sie zur LiquidAI/d1-2B Modellseite auf Hugging Face.
Dateien erkunden: Überprüfen Sie die bereitgestellten Modellinformationen, Architektur und Spezifikationen.
Inference konfigurieren: Nutzen Sie die Transformers-Bibliothek, um das Modell für die Inferenz einzurichten.
Eingaben vorbereiten: Stellen Sie einen Zustand (Text oder JSON), Bilder oder Videos sowie benannte Fragen bereit.
Aufrufe ausführen: Verwenden Sie `system_one` für Einzelanfragen oder `system_one_batch` für gebündelte Anfragen.
Ausgabe interpretieren: Erhalten Sie typisierte Antworten mit Wahrscheinlichkeiten, ohne generierte Tokens.
d1-2B's Anwendungsfälle
- Routing und Triage
- Moderation und Richtlinien
- Absichtsklassifikation
- Themenklassifikation
- Extraktion aus Dokumenten
- Bewertung und Neurangierung
- Visuelle Inspektion
- Multimodale Entscheidungsfindung