Beschreibung
Thinker ist ein spezialisiertes Tool, das entwickelt wurde, um die Leistung und Kosteneffizienz von KI-Agenten zu optimieren, indem es deren Tokenverbrauch intelligent verwaltet. Es geht die häufige Herausforderung an, dass Agenten wiederholt denselben Kontext verarbeiten, was zu höheren Kosten und langsameren Abläufen führen kann. Thinker erreicht dies durch drei Kernmechanismen: Kontextkompression, Anweisungsverkürzung und einen Wissenscache.
Weiterlesen
Die Kontextkompression identifiziert automatisch redundante oder weniger relevante Informationen im Kontext eines Agenten und entfernt diese, sodass nur wesentliche Daten in nachfolgende Aufrufe übernommen werden. Dies reduziert erheblich die Anzahl der pro Aufruf verarbeiteten Tokens und macht die Interaktionen der Agenten effizienter. Beispielsweise kann es große Tool-Ausgaben kürzen und nur die relevantesten Abschnitte für zukünftige Referenzen beibehalten.
Die Anweisungsverkürzung analysiert Anweisungsdateien und Tool-Einstellungen, um unnötige oder wenig nützliche Anweisungen zu identifizieren und zu entfernen, die Agenten möglicherweise wiederholt verarbeiten. Indem es sich auf die Anweisungen konzentriert, die wirklich ihren Platz verdienen, hilft Thinker den Agenten, mit einem schlankeren, effektiveren Satz von Direktiven zu arbeiten, was den Tokenverbrauch weiter reduziert und die Verarbeitungsgeschwindigkeit verbessert. Benutzer können vorgeschlagene Kürzungen überprüfen und anwenden, die dann in die Konfiguration ihres Agenten integriert werden.
Der Wissenscache ermöglicht es Agenten, Informationen zu lernen und wiederzuverwenden, wodurch die Notwendigkeit entfällt, dasselbe Wissen wiederholt zu verarbeiten. Wenn ein Agent ein neues Stück Information lernt, kann es als „Notiz“ (z. B. Regeln, Karten, Anleitungen, Verhaltensweisen) gespeichert und bei Bedarf abgerufen werden. Dieser Cache ist dynamisch, lernt aus jeder Sitzung und weiß, wann eine Notiz veraltet ist, sodass Agenten immer Zugang zu aktuellem und relevantem Wissen haben, ohne wiederholte Tokenkosten für Erkundungen zu verursachen.
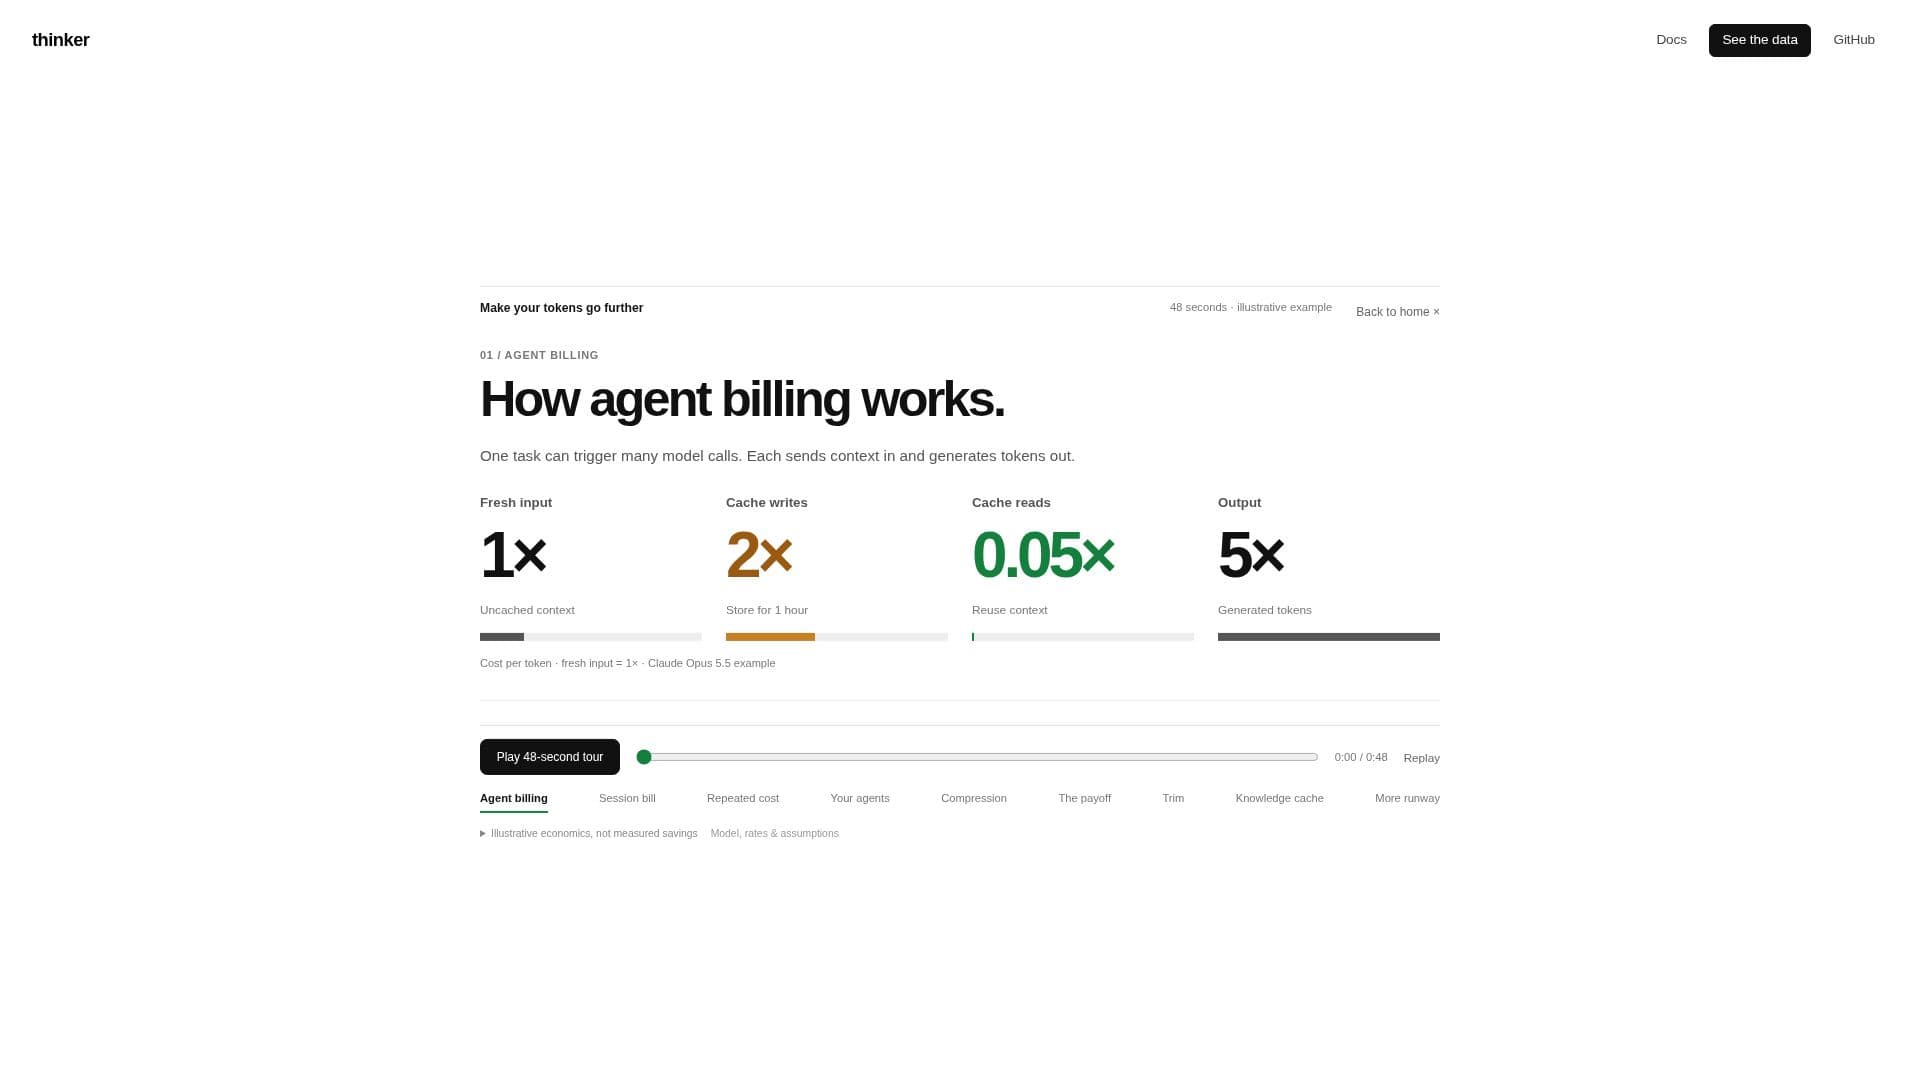
Thinker unterstützt eine Reihe beliebter KI-Agenten, darunter Claude Code, Codex CLI, Gemini CLI, Cursor, Devin CLI, Pi, Windsurf Cascade, GitHub Copilot CLI und OpenCode. Es integriert sich, indem es lokal installiert wird und sich mit den Einstellungen der Agenten verbindet, was einen nahtlosen Betrieb ermöglicht. Die Plattform bietet Ansichten wie „Einsparungen finden“, um die Kontextkosten und -nutzung zu überwachen, „Bericht anzeigen“, um die Tokenkosten im Laufe der Zeit zu verfolgen, und „Aktuelle Aktivitäten“, um angewandte Änderungen zu verwalten. Die wirtschaftlichen Illustrationen von Thinker deuten auf erhebliche Einsparungen hin, indem frische Eingaben, neue Schreibvorgänge und Ausgabetokens reduziert werden, was letztendlich die effektive Laufzeit für Agentenaufgaben innerhalb der bestehenden Tokenlimits verlängert.
- KategoriePrompt-Engineering-Tools
- PreismodellKostenpflichtig
- BereitstellungLokal
- PlattformenWeb
Thinker's Kernfunktionen
Automatische Kontextkompression: Reduziert wiederholten Kontext in Agentensitzungen.
Anweisungsverkürzung: Analysiert und entfernt unnötige Anweisungstokens.
Wissenscache: Speichert und wiederverwendet erlernte Informationen, um Wiederverarbeitung zu vermeiden.
Tokenkostenoptimierung: Hilft Agenten, effizienter innerhalb der Tokenlimits zu arbeiten.
Agentenintegration: Verbindet sich mit verschiedenen KI-Agenten wie Claude Code, Codex, Gemini, Cursor, Devin, Pi, Copilot CLI, OpenCode.
Ausgabeverkürzung: Optionale Funktion zum Kürzen von Toolergebnissen, bevor sie in den Kontext eingehen.
Nutzungsberichterstattung: Bietet Einblicke in Kontextkosten und Tokenverbrauch über die Zeit.
Änderungsmanagement: Verfolgt und ermöglicht die Verwaltung angewandter Kontextkürzungen und Änderungen.
Lokale Datenspeicherung: Speichert Notizen und Konfiguration lokal unter ~/.thinker.
GitHub-Integration: Verwaltet Anweisungsänderungen über Pull-Requests zur Überprüfung.
Mehrsprachige Unterstützung: Verwendet den Tree-sitter-Parser für Python, JavaScript, TypeScript, Go, Rust.
Konfigurierbares Lernen: Ermöglicht Kontrolle über Sitzungsdestillation und Verifizierung.
Telemetrie-Kontrolle: Option zum Deaktivieren des Sendens von Metriken aus Datenschutzgründen.
Mehrere Cache-Typen: Unterstützt verschiedene Cache-Typen für Tools, Anweisungen, RAG-Kontext und Gesprächsverlauf.
Cache-Invalidierungsmanagement: Details, welche Änderungen verschiedene Cache-Segmente ungültig machen.
Wie verwendet man Thinker?
Thinker installieren: Installieren Sie Thinker lokal, was unter ~/.thinker eingerichtet wird und sich mit den Einstellungen Ihrer Agenten verbindet.
Nutzung analysieren: Thinker erstellt einen ersten Bericht, indem es kürzliche Sitzungen aus Ihren aktiven Repositories liest.
Einsparungen identifizieren: Verwenden Sie die Ansicht „Einsparungen finden“, um Kontextkosten und -nutzung zu sehen und Bereiche für Kürzungen zu identifizieren.
Kontextkompression anwenden: Aktivieren Sie die automatische Kontextkompression, wo dies von Ihrem Agenten unterstützt wird.
Anweisungen kürzen: Überprüfen Sie vorgeschlagene Anweisungskürzungen und wenden Sie diese an, um verschwendete Tokens zu reduzieren.
Wissenscache nutzen: Lassen Sie Thinker aus Sitzungen lernen und Wissen durch Notizen wiederverwenden.
Leistung überwachen: Verwenden Sie den „Bericht anzeigen“, um Tokenkosten und Cache-Einsparungen über die Zeit zu verfolgen.
Änderungen verwalten: Überprüfen und verwalten Sie alle angewandten Änderungen und deren Status unter „Aktuelle Aktivitäten“.
Thinker's Anwendungsfälle
- Optimierung der Token-Nutzung von Agenten
- Kostenreduzierung für KI-Agenten
- Verbesserung der Effizienz von Agenten
- Verwaltung von Entwickler-Workflows
- Wissensmanagement für Agenten
- Debugging des Agenten-Kontexts
- Anpassung von Agentenanweisungen
- Erweiterung der Nutzungslimits von Agenten