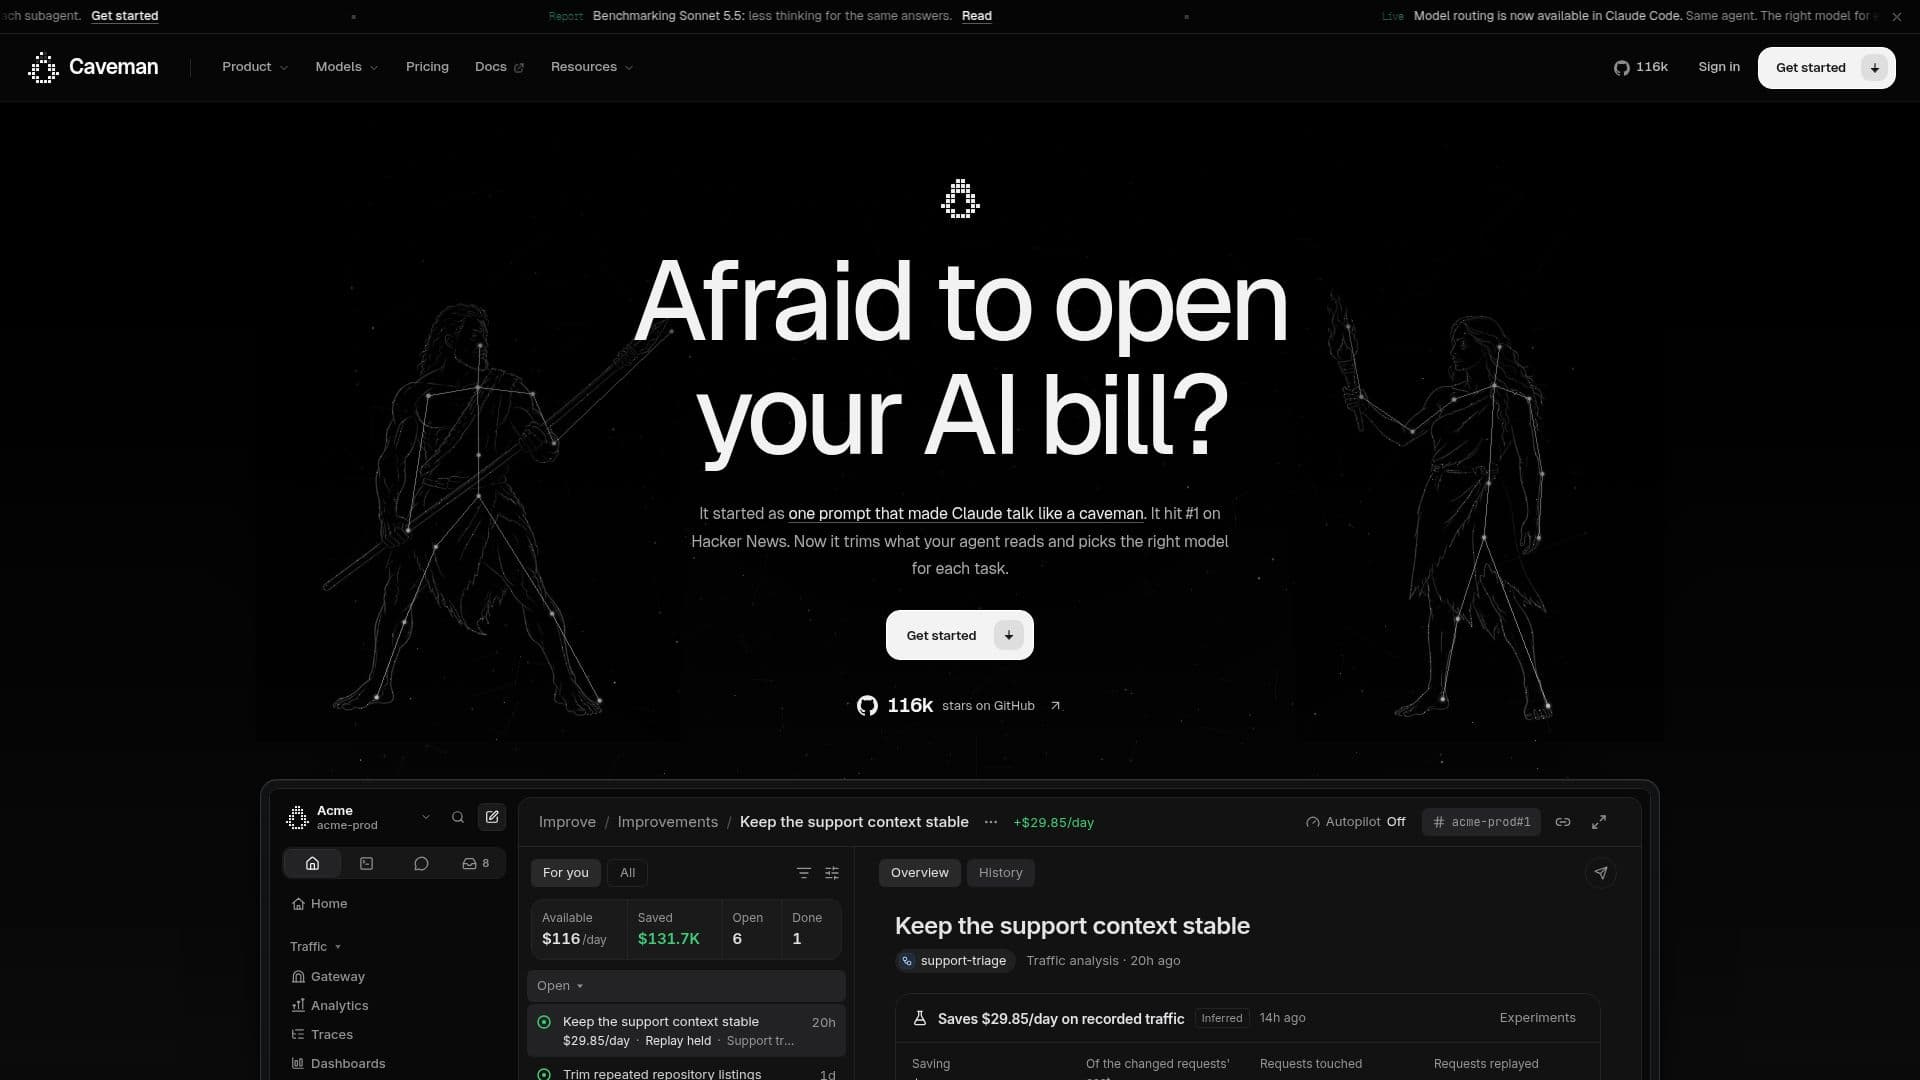
Beschreibung
Caveman bietet eine umfassende Lösung für Entwickler und Teams, die ihre Interaktionen mit KI-Agenten optimieren und die Betriebskosten erheblich senken möchten. Die Plattform bietet lokale Kontextkompression, die geeignete Eingaben wie Protokolle, Testausgaben, JSON und Diffs verkleinert, bevor sie das Modell erreichen, während die ursprünglichen Daten zur Wiederherstellung verfügbar bleiben. Dieser Prozess kann zu erheblichen Einsparungen bei den Eingabetokens führen, mit berichteten Einsparungen von bis zu 33,2 % in gesamten Sitzungen.
Weiterlesen
Neben der Eingabeoptimierung konzentriert sich Caveman auch auf die Effizienz der Ausgaben, indem kürzere Antworten von Agenten angefordert werden. Diese „Sagt weniger“-Funktion hilft, Füllwörter aus den Antworten der Agenten zu eliminieren und liefert Code, Befehle und Fehler Byte für Byte. Dies kann zu bis zu 65 % weniger lesbarem Output führen, was etwa 10 % der gesamten Tokenersparnis bei langfristigen Codierungsaufgaben entspricht.
Eine Schlüsselkompetenz von Caveman ist die adaptive Modellauswahl, die jede Agentenrunde intelligent an das kostengünstigste Modell weiterleitet, das die Aufgabe korrekt ausführen kann. Dies stellt sicher, dass anspruchsvolle Arbeiten weiterhin den fortschrittlichsten Modellen zugewiesen werden, während einfachere Aufgaben kostengünstigere Optionen nutzen, was die Kosten pro Aufgabe um 0,46x senken kann. Die Plattform integriert sich mit beliebten Codierungsagenten wie Claude Code, Codex und Gemini CLI und bietet SDKs für mit TypeScript und Python erstellte Agenten, einschließlich Middleware für Vercel AI SDK, OpenAI, Anthropic und LangChain.
Caveman Cloud erweitert diese Funktionen mit fortschrittlicher Analyse, die Einblick in die Kosten der Agenten, Nachverfolgung jeder Anfrage und teamweite Ausgaben bietet. Es identifiziert Verschwendung, schlägt Lösungen vor und kann sogar Verbesserungen im Autopilot-Modus implementieren, indem sie an historischen Daten getestet werden, bevor sie bereitgestellt werden. Die Plattform umfasst auch Governance-Funktionen wie weiche und harte Ausgabenobergrenzen, Ratenlimits und Schutzmaßnahmen zum Maskieren oder Blockieren sensibler Daten, die alle in einem Prüfprotokoll aufgezeichnet werden. Die Kernwerkzeuge (Agent und SDK) sind kostenlos und Open Source, mit einem kostenlosen Tarif für Cloud-Dienste für einzelne Entwickler und kostenpflichtigen Plänen für Teams und Unternehmen, die zusätzliche Funktionen wie semantisches Caching, Projektzugriffskontrolle und VPC-Bereitstellung bieten.
- KategorieKI-DevOps- & -Cloud-Tools
- PreismodellFreemium
- BereitstellungLocal, Cloud, VPC
- PlattformenTypeScript, Python
Caveman's Kernfunktionen
Wiederherstellbare lokale Kontextkompression
Kürzere Antworten von KI-Agenten
Adaptive Modellauswahl
Messung der Tokenverwendung
Analytik zu KI-Agentenkosten
Identifizierung und Optimierung von Verschwendung
Autopilot für Leistungsverbesserungen
Echtzeit-Anfragenverfolgung
Transparenz der Team-Ausgaben
Budgetverwaltung und Ausgabenobergrenzen
Schutzmaßnahmen zum Maskieren/Blockieren von Daten
Prüfprotokollierung für Änderungen
Open-Source lokale Werkzeuge
TypeScript- und Python-Middleware
Semantischer Cache
Wie verwendet man Caveman?
Lokale Werkzeuge installieren: Verwenden Sie die CLI oder das SDK, um Caveman mit Ihrem bestehenden Codierungsagenten oder Ihrer Anwendung zu integrieren.
Kompression konfigurieren: Implementieren Sie die Kontextkompression für Protokolle, JSON, Diffs und andere Eingaben, um die Tokenverwendung zu reduzieren.
Kürzere Antworten aktivieren: Richten Sie Agenten ein, um prägnantere Antworten zu generieren und die Ausgabetokens zu reduzieren.
Modellrouting aktivieren: Konfigurieren Sie die adaptive Modellauswahl, um automatisch das kosteneffektivste Modell für jede Aufgabe auszuwählen.
Kosten überwachen: Nutzen Sie Caveman Cloud, um die Ausgaben der Agenten zu verfolgen, Ineffizienzen zu identifizieren und die Leistung zu analysieren.
Verbesserungen umsetzen: Wenden Sie vorgeschlagene Lösungen für Verschwendung an und nutzen Sie den Autopilot für automatisierte Optimierungen.
Governance festlegen: Legen Sie Ausgabenobergrenzen, Ratenlimits und Daten-Schutzmaßnahmen für Ihre KI-Agentenoperationen fest.
Leistung bewerten: Verwenden Sie integrierte Evaluierungstools, um Änderungen zu testen und die Kosten pro erfolgreicher Aufgabe zu messen.
Caveman's Anwendungsfälle
- KI-API-Kosten senken
- Leistung von Codierungsagenten optimieren
- Ausgaben von KI-Agenten überwachen
- Automatisierte Kosteneinsparungen
- Daten-Governance verbessern
- Effiziente KI-Agenten entwickeln
- Optimierungen von Agenten bewerten
- Team-KI-Nutzung verwalten