Beschreibung
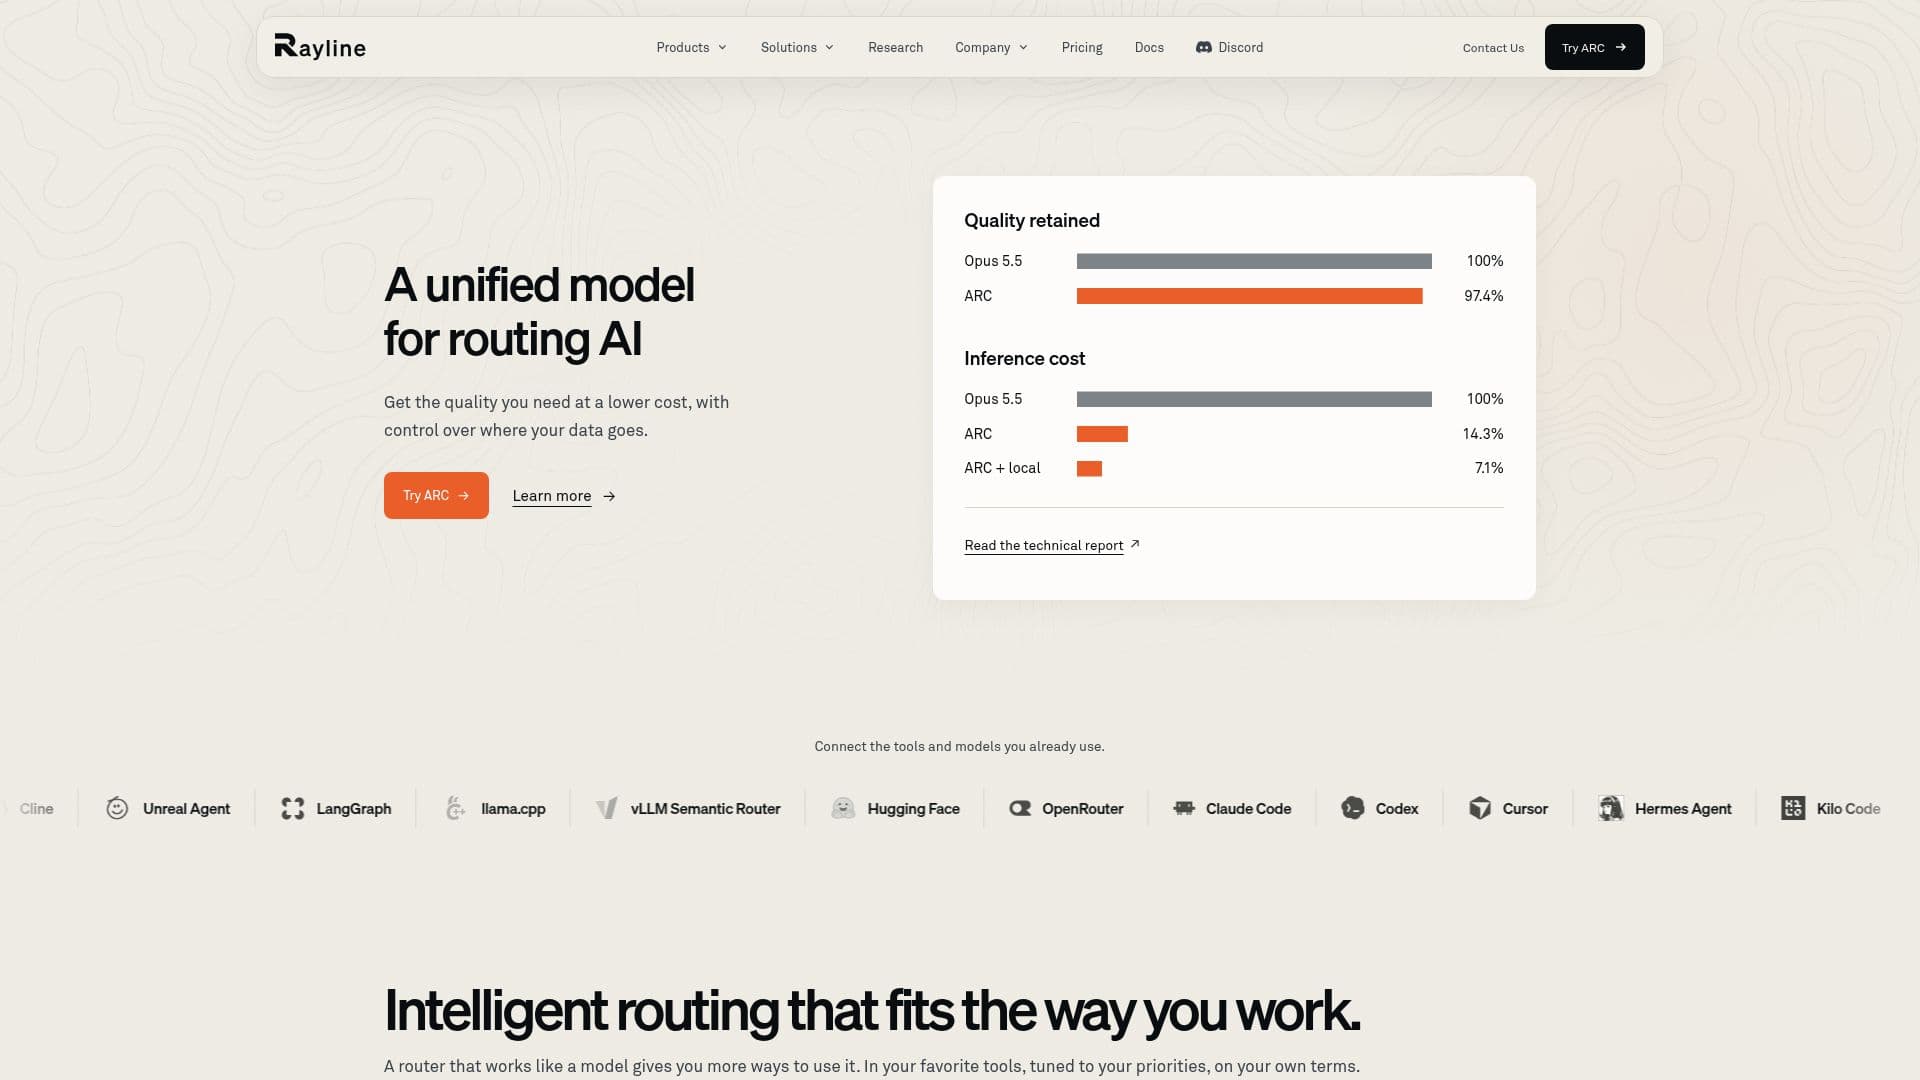
Rayline bietet ein einheitliches Modell für das Routing von KI, das darauf ausgelegt ist, optimale Qualität zu einem niedrigeren Preis zu liefern, während die Benutzer die Kontrolle über ihre Daten behalten. Im Kern steht ARC, Raylines adaptives Routingsystem, das intelligent das am besten geeignete KI-Modell und das Denklevel für jede Gesprächsrunde auswählt, basierend auf Faktoren wie Gesprächskontext, gewünschter Qualität und Kosten.
Weiterlesen
Die Plattform integriert sich nahtlos in eine Vielzahl bestehender Tools und Modelle, darunter llama.cpp, vLLM, Semantic Router, Hugging Face, OpenRouter, Claude, OpenAI, DeepSeek, GLM, Kimi, Qwen, Gemini, Gemma und Mistral. Diese Flexibilität ermöglicht es Teams, weiterhin in ihren gewohnten Umgebungen zu arbeiten und gleichzeitig von Raylines intelligenten Routing-Fähigkeiten zu profitieren. Benutzer können die Entscheidungen von ARC an ihren spezifischen Arbeitslastprioritäten und den tatsächlichen Modellkosten, einschließlich aller ausgehandelten Rabatte, ausrichten.
Rayline bietet Flexibilität bei der Bereitstellung, sodass Benutzer entweder Rayline die Inferenz durchführen lassen oder die Modellempfehlung an ihr eigenes Gateway, ihren Cloud-Anbieter oder lokale Modelle weitergeben können. Die Decisions API liefert strukturierte Antworten, Auswahlmöglichkeiten, Wahrscheinlichkeiten und Bewertungen aus beliebigen Eingaben, die speziell für das Modellrouting trainiert wurden, aber auch für breitere Anwendungen nützlich sind. Für gehostete Generierung können Benutzer mit ARC Swift oder Sage beginnen oder die Routes API für selbstverwaltete Inferenz nutzen.
Für Entwickler bietet Rayline Workshop Cloud und Workshop Desktop, die den Aufbau von produktionsbereiter Software mit adaptiven Agenten ermöglichen. Die Rayline CLI verbindet lokale Modelle und Cloud-Dienste und integriert sie in bestehende Tools. Die Plattform bietet auch erhebliche Kosteneinsparungen, mit potenziellen jährlichen Einsparungen von bis zu 108.000 USD durch bis zu 90 % niedrigere Inferenzkosten. Raylines Ansatz wird durch umfangreiche Forschung unterstützt, die im technischen Bericht zu ARC detailliert beschrieben ist und die Methodik sowie die Benchmark-Ergebnisse hinter der Qualität und Kostenbalance erklärt.
Rayline bietet verschiedene Preismodelle an, darunter Festpreissetzungen wie ARC Swift für effiziente tägliche API-Arbeiten und ARC Sage für qualitätsorientierte Agentenaufgaben. ARC Dynamic bietet eine adaptive Modellauswahl mit Durchleitungs-Preisen basierend auf dem ausgewählten Modell, ohne Provisionen. Die Routes API ermöglicht es Benutzern, für Modellauswahl und Denklevel zu zahlen und ihre eigenen Inferenzkosten zu verwalten. Die Decisions API wird basierend auf Eingabetoken für strukturierte Antworten bepreist. Die Rayline CLI ist Open Source und ohne Softwaregebühr, wobei Hardware- und Cloud-Inferenz separat abgerechnet werden. Contributor-Modelle bieten niedrigere Tokenpreise im Austausch dafür, dass Rayline berechtigt ist, Anfragedaten für das Modelltraining zu verwenden.
- KategorieMLOps & Modell-Deployment
- PreismodellFreemium
- BereitstellungCloud, Lokal
- PlattformenWeb
Rayline's Kernfunktionen
Einheitliches KI-Modell-Routing (ARC)
Kostenoptimierte Modellauswahl
Datenkontrolle und Datenschutz
Integration mit bestehenden KI-Tools und -Modellen
Adaptives Routing basierend auf Prioritäten
Flexible Inferenzbereitstellung (gehostet oder selbstverwaltet)
Decisions API für strukturierte Antworten
Routes API für Modellauswahl
Workshop Cloud und Desktop für Entwicklung
Rayline CLI für lokale Modellintegration
Erhebliche Einsparungen bei Inferenzkosten
Technischer Bericht und Forschungsunterstützung
Festpreis- und dynamische Preismodelle
Preismodelle für Contributor-Modelle
Plattform zur Nutzung und Ausgabenverfolgung
Wie verwendet man Rayline?
Tools verbinden: Integrieren Sie bestehende KI-Modelle und -Tools wie Claude, OpenAI und Hugging Face mit Rayline.
Routing konfigurieren: Definieren Sie Ihre Prioritäten für Qualität und Kosten, um die Modellauswahlentscheidungen von ARC zu gestalten.
Inferenz bereitstellen: Wählen Sie, ob Sie die Inferenz über Raylines gehostete Dienste (Swift, Sage) durchführen oder sie auf Ihrer eigenen Infrastruktur mit der Routes API verwalten möchten.
Anwendungen entwickeln: Nutzen Sie Workshop Cloud oder Desktop, um produktionsbereite Software mit adaptiven Agenten zu erstellen.
Überwachen und optimieren: Verfolgen Sie die Nutzung und Ausgaben auf der Rayline-Plattform und passen Sie die Routing-Richtlinien für kontinuierliche Verbesserungen an.
Rayline's Anwendungsfälle
- Optimierung der Modellauswahl für KI
- Reduzierung der Inferenzkosten
- Integration verschiedener KI-Tools
- Entwicklung adaptiver KI-Agenten
- Sicherstellung der Datenkontrolle
- Strukturierte Entscheidungsfindung
- Anpassung der Routing-Ökonomie
- Bewertung von Routing-Richtlinien