تخطَّ إلى المحتوى الرئيسي
ToolPotion
مستشار الذكاء الاصطناعي
إرسال (مجاني)

WeVisOne-VL

WeVisOne-VL هو نموذج موحد للرؤية واللغة من WeChat Vision التابعة لشركة Tencent. يدمج الإدراك على مستوى الكائنات والبكسلات لمهام مثل اكتشاف الكائنات وتقطيع الصور، باستخدام مفكك بكسل خفيف الوزن.

زيارة الرابط
مشاركة
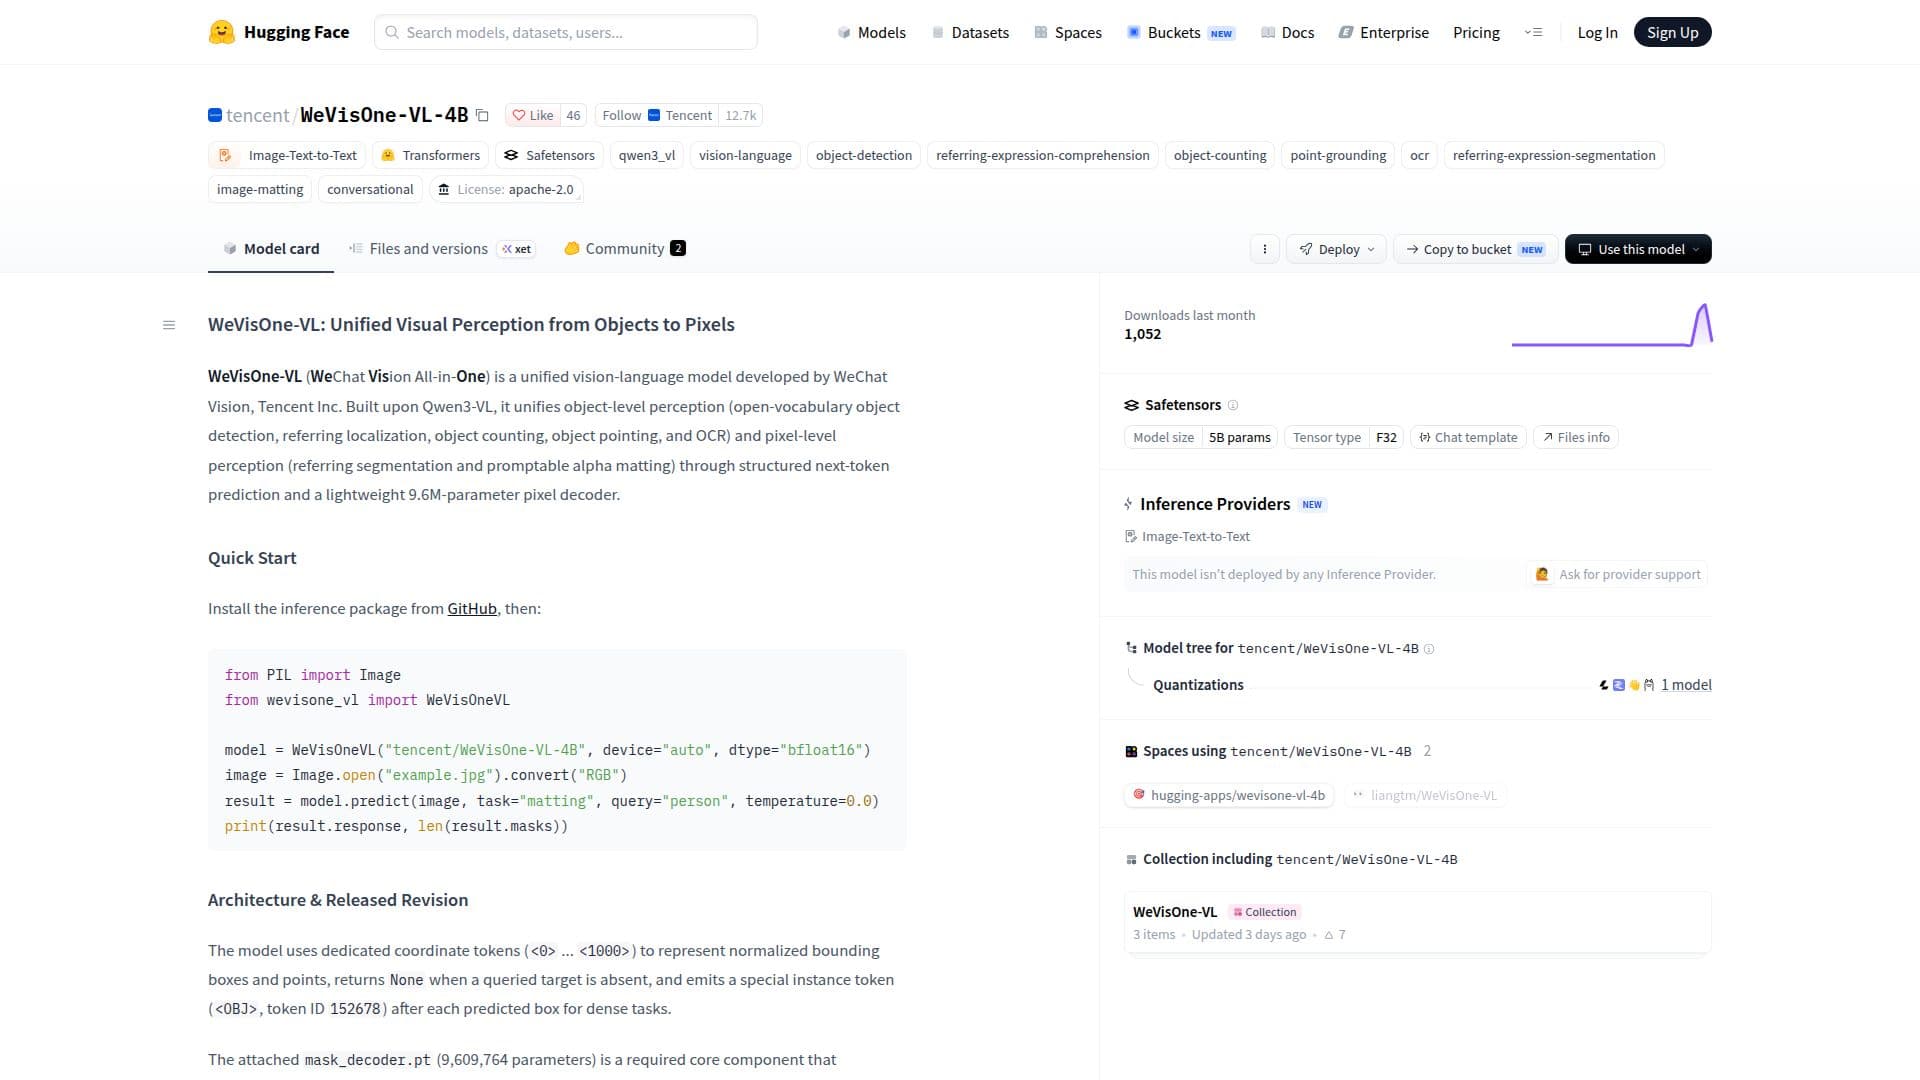
لقطة شاشة لـ WeVisOne-VL

WeVisOne-VL هو نموذج للرؤية واللغة تم تطويره بواسطة WeChat Vision، وهي جزء من شركة Tencent Inc. تم تصميمه لتوحيد مهام الإدراك على مستوى الكائنات والبكسلات. يعتمد على إطار عمل Qwen3-VL، يدعم WeVisOne-VL مجموعة من المهام البصرية بما في ذلك اكتشاف الكائنات ذات المفردات المفتوحة، والتحديد المرجعي، وعد الكائنات، والإشارة إلى الكائنات، والتعرف الضوئي على الحروف (OCR). بالإضافة إلى ذلك، يتعامل مع المهام على مستوى البكسل مثل التقسيم المرجعي وتقطيع ألفا القابل للتوجيه. يستخدم النموذج تنبؤات منظمة للرمز التالي ويتميز بمفكك بكسل خفيف الوزن يحتوي على 9.6 مليون معلمة.

قراءة المزيد

تتضمن بنية WeVisOne-VL رموز إحداثية مخصصة لتمثيل الصناديق المحيطة والنقاط العادية. يستخدم رمز حالة خاص للمهام الكثيفة ويجمع بين مفكك قناع كعنصر أساسي. يجمع هذا المفكك بين محول الميزات البصرية، ومفكك استعلام موجه بالصندوق، ورأس التنبؤ الكثيف المشروط بالحالة لتحسين التنبؤات وإخراج تقطيع ألفا بدقة كاملة.

يهدف WeVisOne-VL إلى الأغراض البحثية في التأسيس البصري، والتحديد المرجعي، والإشارة، والعد، وتحديد موقع OCR، والتقسيم المرجعي، وتقطيع الصور. لم يتم تصميمه لاتخاذ قرارات ذات تأثير عالٍ بشكل مستقل أو التعرف على الأفراد. النموذج فعال في إنتاج مخرجات منظمة ولكنه لا يدعم التفكير المتسلسل الصريح ومحدود حاليًا في إدراك الصور في جولة واحدة.

تم إصدار النموذج بموجب رخصة Apache 2.0، مع احتفاظ المكونات التابعة لجهات خارجية برخصها الأصلية. تم تنزيله أكثر من 1,000 مرة في الشهر الماضي، مما يدل على شعبيته المتزايدة في مجتمع البحث.

  • الفئةنماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
  • نموذج التسعيرمجاني
  • النشرسحابي
  • المنصاتالويب

  • نموذج موحد للرؤية واللغة

  • إدراك على مستوى الكائنات

  • إدراك على مستوى البكسلات

  • مفكك بكسل يحتوي على 9.6 مليون معلمة

  • تنبؤ منظم للرمز التالي

  • رموز إحداثية مخصصة

  • رمز حالة خاص للمهام الكثيفة

  • رخصة Apache 2.0

  1. الوصول إلى صفحة النموذج: زيارة صفحة WeVisOne-VL على Hugging Face

  2. المصادقة: التأكد من أن لديك الأذونات اللازمة للوصول إلى النموذج

  3. التكوين: إعداد معلمات النموذج وفقًا لاحتياجات البحث الخاصة بك

  4. إرسال المطالبات: إدخال المهام البصرية الخاصة بك للمعالجة

  5. التعديل: ضبط النموذج لمهام محددة إذا لزم الأمر

  • اكتشاف الكائنات
  • التحديد المرجعي
  • عد الكائنات
  • تحديد موقع OCR
  • تقطيع الصور

أدوات ذكاء اصطناعي شائعة مثل WeVisOne-VL

WeVisOne-VL

نماذج اللغة الكبيرة

WeVisOne-VL هو نموذج موحد للرؤية واللغة تم تطويره بواسطة WeChat Vision، شركة Tencent Inc. يدمج الإدراك على مستوى الكائنات والإدراك على مستوى البكسل لمهام مثل اكتشاف الكائنات…

أدوات الرؤية الحاسوبية
عرض الأداة

نماذج اللغة الكبيرة

نموذج موحد للرؤية واللغة تم تطويره بواسطة WeChat Vision، شركة Tencent Inc. يدمج الإدراك على مستوى الكائنات والإدراك على مستوى البكسل لمهام مثل اكتشاف الكائنات…WeVisOne-VL هو نموذج موحد للرؤية واللغة تم تطويره بواسطة WeChat Vision، شركة Tencent Inc. يدمج الإدراك على مستوى الكائنات والإدراك على مستوى البكسل لمهام مثل اكتشاف الكائنات…

أدوات الرؤية الحاسوبية
عرض أفضل 50 من نماذج اللغة الكبيرة

Qwen2-VL-7B-Instruct

نماذج الذكاء الاصطناعي

Qwen2-VL-7B-Instruct هو نموذج متقدم للذكاء الاصطناعي مصمم لفهم الصور ودعم اللغات المتعددة. يتفوق في معالجة الصور ومقاطع الفيديو، ويقدم أداءً رائدًا في مختلف المعايير. يدعم النموذج…

أدوات الرؤية الحاسوبية
عرض الأداة

نماذج الذكاء الاصطناعي

نموذج متقدم للذكاء الاصطناعي مصمم لفهم الصور ودعم اللغات المتعددة. يتفوق في معالجة الصور ومقاطع الفيديو، ويقدم أداءً رائدًا في مختلف المعايير. يدعم النموذج…Qwen2-VL-7B-Instruct هو نموذج متقدم للذكاء الاصطناعي مصمم لفهم الصور ودعم اللغات المتعددة. يتفوق في معالجة الصور ومقاطع الفيديو، ويقدم أداءً رائدًا في مختلف المعايير. يدعم النموذج…

أدوات الرؤية الحاسوبية
عرض أفضل 5 من نماذج الذكاء الاصطناعي

Qwen-VL

مستودعات GitHub للذكاء الاصطناعي

Qwen-VL هو نموذج لغة رؤية كبير تم تطويره بواسطة Alibaba Cloud. يوفر قدرات متقدمة لمهام الدردشة والرؤية، مما يوفر منصة قوية لتطبيقات الذكاء الاصطناعي في هذه المجالات.

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
عرض الأداة

مستودعات GitHub للذكاء الاصطناعي

نموذج لغة رؤية كبير تم تطويره بواسطة Alibaba Cloud. يوفر قدرات متقدمة لمهام الدردشة والرؤية، مما يوفر منصة قوية لتطبيقات الذكاء الاصطناعي في هذه المجالات.Qwen-VL هو نموذج لغة رؤية كبير تم تطويره بواسطة Alibaba Cloud. يوفر قدرات متقدمة لمهام الدردشة والرؤية، مما يوفر منصة قوية لتطبيقات الذكاء الاصطناعي في هذه المجالات.

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
عرض أفضل 250 من مستودعات GitHub للذكاء الاصطناعي

أداة رؤية الكمبيوتر - MATLAB

تطبيقات الذكاء الاصطناعي

توفر أداة رؤية الكمبيوتر خوارزميات وتطبيقات لتصميم واختبار أنظمة رؤية الكمبيوتر، بما في ذلك الفحص البصري، واكتشاف الكائنات، ومطابقة الميزات. تدعم تقنيات الذكاء الاصطناعي مثل…

أدوات الرؤية الحاسوبية
عرض الأداة

تطبيقات الذكاء الاصطناعي

توفر أداة رؤية الكمبيوتر خوارزميات وتطبيقات لتصميم واختبار أنظمة رؤية الكمبيوتر، بما في ذلك الفحص البصري، واكتشاف الكائنات، ومطابقة الميزات. تدعم تقنيات الذكاء الاصطناعي مثل…

أدوات الرؤية الحاسوبية
عرض أفضل 250 من تطبيقات الذكاء الاصطناعي

Qwen2-VL-72B-Instruct

نماذج الذكاء الاصطناعي

Qwen2-VL-72B-Instruct هو نموذج متقدم للذكاء الاصطناعي مصمم لفهم بصري متطور ودعم متعدد اللغات. يتفوق في معالجة الصور والفيديوهات ومهام التفكير المعقد، مما يجعله مناسبًا لتطبيقات…

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
عرض الأداة

نماذج الذكاء الاصطناعي

نموذج متقدم للذكاء الاصطناعي مصمم لفهم بصري متطور ودعم متعدد اللغات. يتفوق في معالجة الصور والفيديوهات ومهام التفكير المعقد، مما يجعله مناسبًا لتطبيقات…Qwen2-VL-72B-Instruct هو نموذج متقدم للذكاء الاصطناعي مصمم لفهم بصري متطور ودعم متعدد اللغات. يتفوق في معالجة الصور والفيديوهات ومهام التفكير المعقد، مما يجعله مناسبًا لتطبيقات…

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
عرض أفضل 5 من نماذج الذكاء الاصطناعي

Ultralytics YOLO

مستودعات GitHub للذكاء الاصطناعي

يتضمن Ultralytics YOLO YOLO26 و YOLO11 و YOLOv8، ويوفر قدرات لكشف الكائنات، وتقسيم الكائنات، والتقسيم الدلالي، وتصنيف الصور، وتقدير الوضع، وتتبع الكائنات. تم تصميمه للمطورين…

أدوات الرؤية الحاسوبية

المرتبة 19 في مستودعات GitHub للذكاء الاصطناعي

عرض الأداة

مستودعات GitHub للذكاء الاصطناعي

يتضمن Ultralytics YOLO YOLO26 و YOLO11 و YOLOv8، ويوفر قدرات لكشف الكائنات، وتقسيم الكائنات، والتقسيم الدلالي، وتصنيف الصور، وتقدير الوضع، وتتبع الكائنات. تم تصميمه للمطورين…

مميزةأدوات الرؤية الحاسوبية
المرتبة 19 في مستودعات GitHub للذكاء الاصطناعي

CLIP ViT-B/32

نماذج الذكاء الاصطناعي

نموذج clip-vit-base-patch32 من OpenAI مصمم لمهام تصنيف الصور بدون تدريب مسبق. يستخدم بنية Vision Transformer لتعزيز القوة والقدرة على التعميم في رؤية الكمبيوتر، مما يجعله موردًا…

أدوات الرؤية الحاسوبية
عرض الأداة

نماذج الذكاء الاصطناعي

نموذج clip-vit-base-patch32 من OpenAI مصمم لمهام تصنيف الصور بدون تدريب مسبق. يستخدم بنية Vision Transformer لتعزيز القوة والقدرة على التعميم في رؤية الكمبيوتر، مما يجعله موردًا…

مميزةأدوات الرؤية الحاسوبية
عرض أفضل 5 من نماذج الذكاء الاصطناعي

Ultralytics

تطبيقات الذكاء الاصطناعي

منصة رؤية حاسوبية شاملة لتوضيح البيانات، تدريب نماذج YOLO، ونشرها عالميًا، مبنية حول إطار العمل مفتوح المصدر Ultralytics YOLO الذي يتمتع بشعبية واسعة.

أدوات الرؤية الحاسوبيةالتصنيع والصناعة

المرتبة 5 في التصنيع والصناعة

عرض الأداة

تطبيقات الذكاء الاصطناعي

منصة رؤية حاسوبية شاملة لتوضيح البيانات، تدريب نماذج YOLO، ونشرها عالميًا، مبنية حول إطار العمل مفتوح المصدر Ultralytics YOLO الذي يتمتع بشعبية واسعة.

مميزةأدوات الرؤية الحاسوبيةالتصنيع والصناعة
المرتبة 5 في التصنيع والصناعة
1 من 8