الوصف
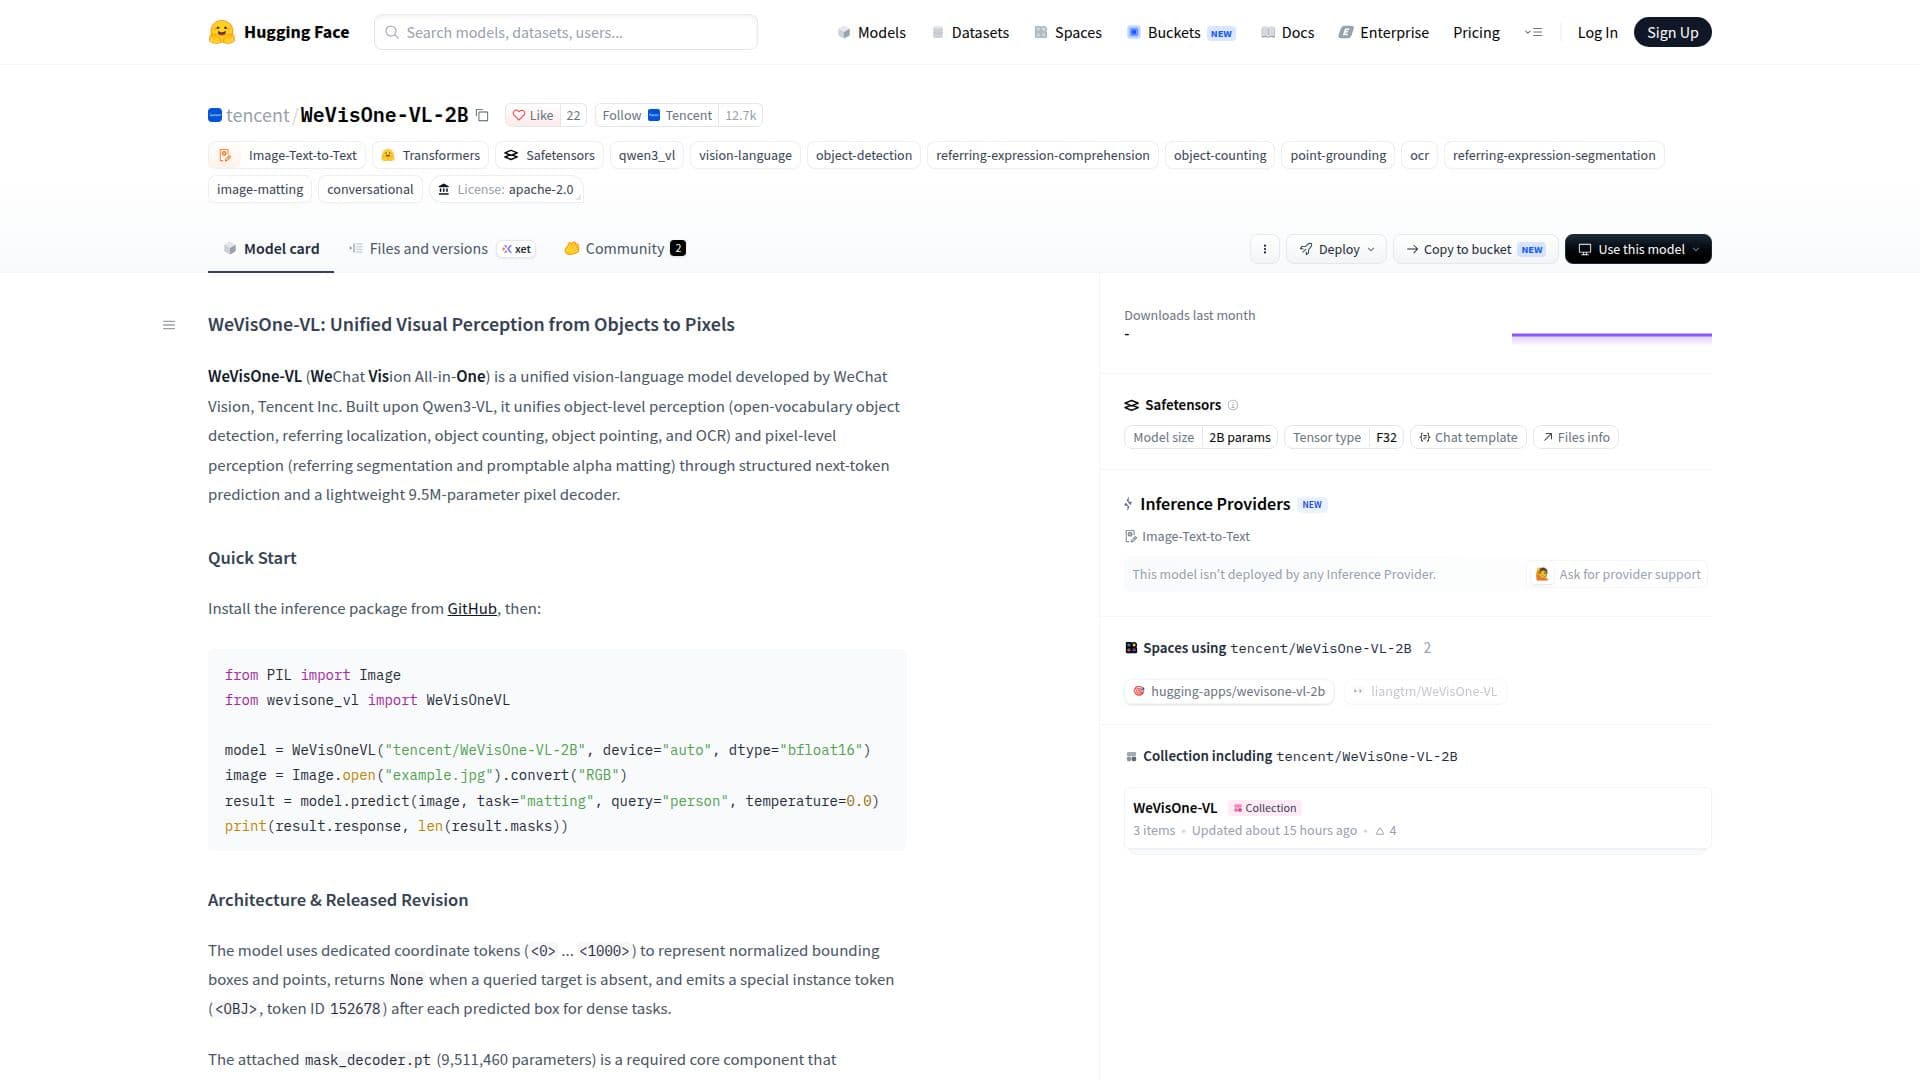
WeVisOne-VL هو نموذج متقدم للرؤية واللغة تم تطويره بواسطة WeChat Vision، قسم من شركة Tencent Inc. يعتمد هذا النموذج على إطار عمل Qwen3-VL ومصمم لتوحيد مهام الإدراك على مستوى الكائنات والإدراك على مستوى البكسل. إنه قادر على التعامل مع اكتشاف الكائنات بفتح المفردات، والتحديد المرجعي، وعد الكائنات، والإشارة إلى الكائنات، والتعرف الضوئي على الأحرف (OCR). بالإضافة إلى ذلك، يدعم المهام على مستوى البكسل مثل التقسيم المرجعي وتقطيع ألفا القابل للتوجيه.
قراءة المزيد
يستخدم النموذج توقع الرمز التالي المنظم ويتميز بوجود مفكك بكسل خفيف الوزن يحتوي على 9.5 مليون معلمة. أحد المكونات الرئيسية لـ WeVisOne-VL هو mask_decoder.pt، الذي يدمج محول الميزات البصرية، ومفكك استعلام موجه بالصندوق، ورأس التنبؤ الكثيف المشروط بالنسخة. تعمل هذه المكونات معًا لتحسين التوقعات وإنتاج تقطيع ألفا عالي الدقة.
يهدف WeVisOne-VL إلى التطبيقات البحثية في التأسيس البصري، والتحديد، والإشارة، والعد، وOCR، والتقسيم، وتقطيع الصور. إنه غير مصمم لاتخاذ قرارات مستقلة أو تحديد الأفراد. تم تحسين النموذج للإدراك البصري في جولة واحدة ولا يدعم شبكات الفيديو.
تم إصدار النموذج بموجب رخصة Apache 2.0، مع احتفاظ المكونات التابعة بحقوقها الأصلية. يُشجع المستخدمون على مراجعة ملفات المصدر للحصول على تفاصيل الترخيص المحددة.
- الفئةأدوات الرؤية الحاسوبية
- نموذج التسعيرمفتوح المصدر
- النشرسحابي
- المنصاتالويب
أبرز ملامح WeVisOne-VL
نموذج موحد للرؤية واللغة
إدراك على مستوى الكائنات
إدراك على مستوى البكسل
اكتشاف كائنات بفتح المفردات
تقسيم مرجعي
تقطيع ألفا القابل للتوجيه
توقع الرمز التالي المنظم
مفكك بكسل خفيف الوزن
البدء مع WeVisOne-VL
الوصول إلى صفحة النموذج: زيارة صفحة نموذج Hugging Face
المصادقة: تسجيل الدخول إلى حساب Hugging Face الخاص بك
التكوين: إعداد النموذج مع المعلمات اللازمة
إرسال المطالبات: إدخال بياناتك البصرية للمعالجة
التعديل: ضبط إعدادات النموذج لمهام محددة
حالات استخدام WeVisOne-VL
- التأسيس البصري
- اكتشاف الكائنات
- تقطيع الصور
- تحديد موقع OCR
- تقسيم مرجعي