الوصف
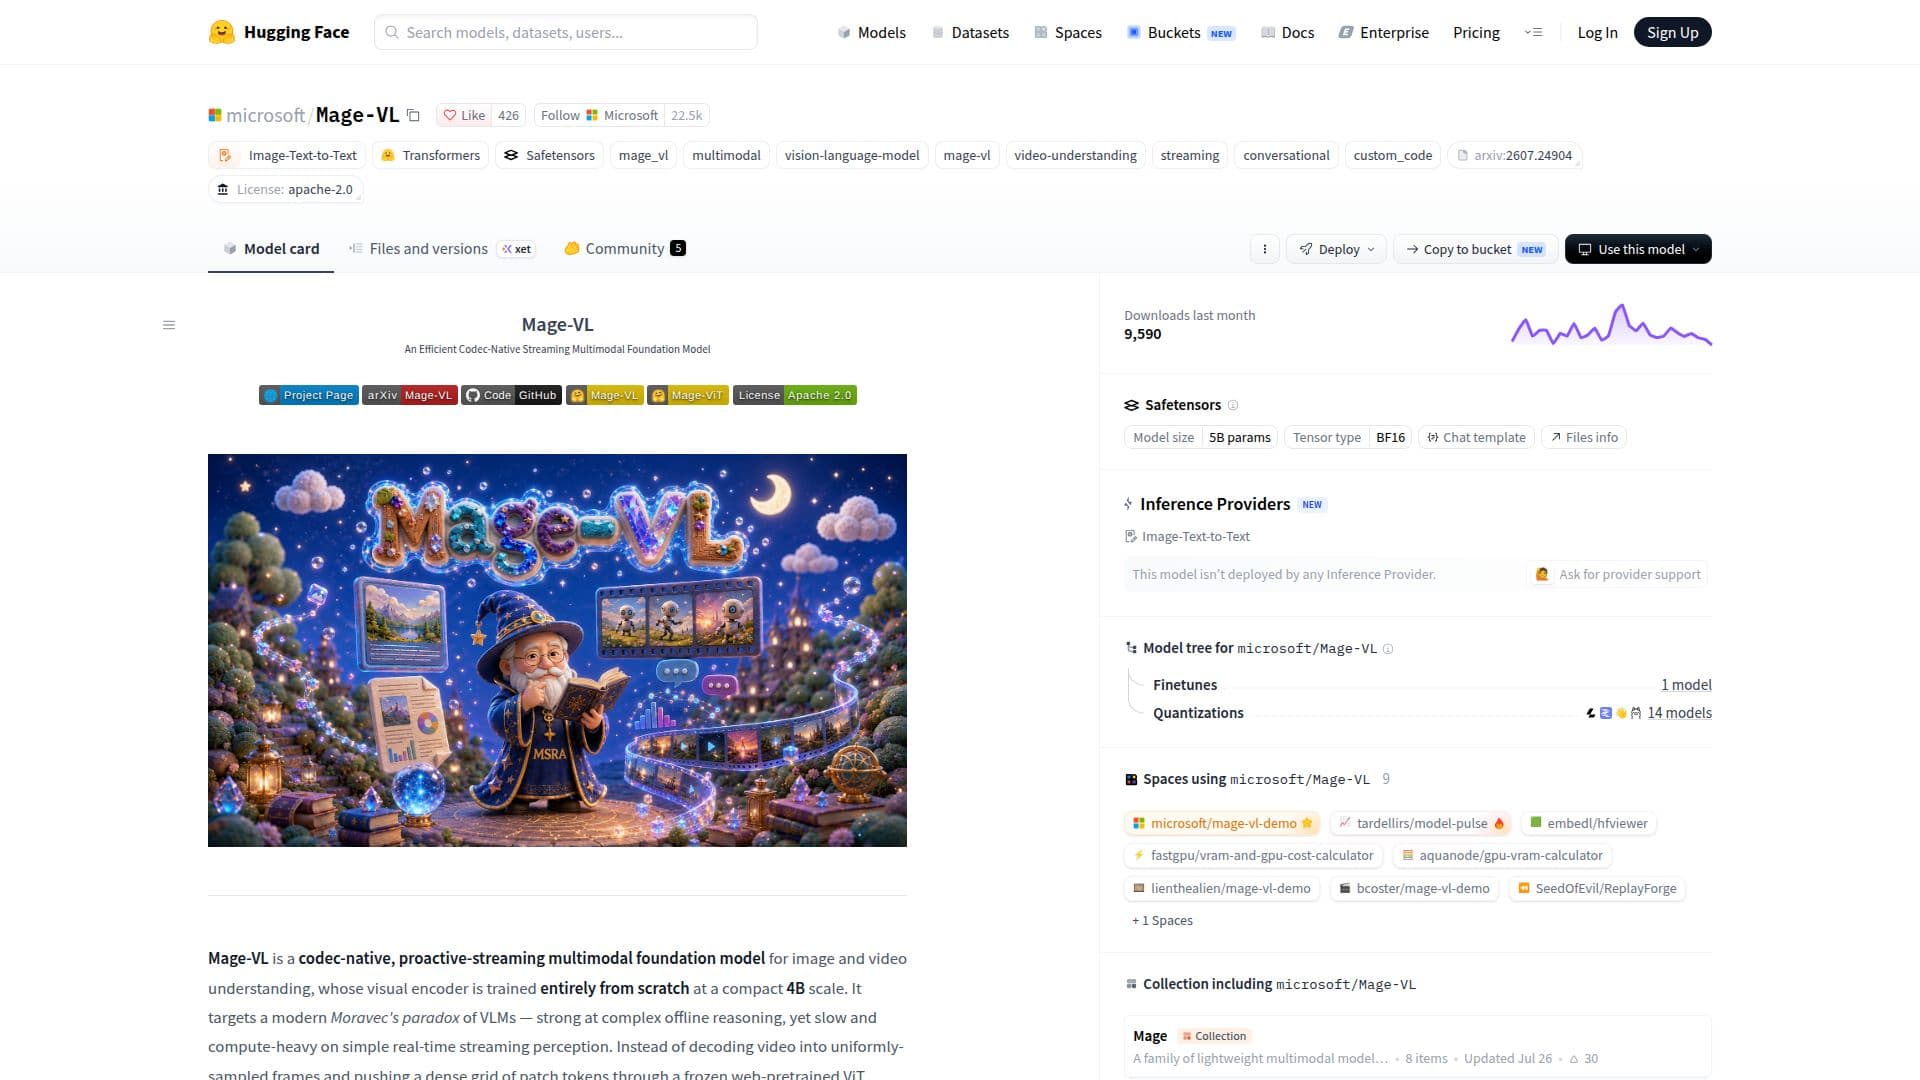
Mage-VL هو نموذج أساسي مبتكر متعدد الوسائط تم تطويره لمعالجة تحديات فهم الصور والفيديوهات. تم تصميمه كنموذج يعتمد على الترميز، يعمل بشكل استباقي ويعالج البيانات البصرية بكفاءة. مشفر النموذج البصري، Mage-ViT، تم تدريبه من الصفر ويعمل على نطاق مضغوط يبلغ 4B. يتميز هذا المشفر بقدرته الفريدة على تخصيص الرموز بناءً على الأهمية الزمانية والمكانية المستمدة من الترميز، مما يسمح له بمعالجة الفيديوهات التي تصل مدتها إلى ثمانية أضعاف تحت نفس الميزانية الحاسوبية.
قراءة المزيد
تتضمن بنية Mage-VL مفككًا سببيًا Qwen3-4B، وهو المكون الوحيد المدرب مسبقًا. يعمل هذا المفكك بالتعاون مع Mage-ViT للتعامل مع تدفقات الرموز ذات الأطوال المتغيرة، مما يدعم واجهة موحدة للصور والفيديوهات ذات الأطوال المختلفة. يتضمن تصميم النموذج ذو العمليتين بوابة إدراكية تتيح البث الاستباقي من خلال مراقبة المحتوى وتفعيل النموذج البصري الكامل فقط عند الحاجة.
تقلل الطريقة المعتمدة على الترميز بشكل كبير من استهلاك الرموز البصرية بأكثر من 75%، مما يؤدي إلى تسريع الاستدلال بمعدل 3.5× مقارنة بالطرق التقليدية. يتم تحقيق هذه الكفاءة دون المساس بالدقة، مما يجعل Mage-VL أداة قوية لتحليل وفهم الفيديوهات في الوقت الحقيقي.
يتميز Mage-VL بقوة خاصة في فهم الفيديوهات والذكاء المكاني، حيث يتفوق على النماذج المماثلة في عدة معايير. تظهر قدراته في البث الاستباقي من خلال أدائه في مهام بث SoccerNet، حيث يقدم تعليقات ذات زمن استجابة منخفضة ومبنية على الأحداث.
بشكل عام، يمثل Mage-VL تقدمًا كبيرًا في نماذج الذكاء الاصطناعي متعددة الوسائط، حيث يقدم حلاً فعالاً من حيث البيانات للمهام البصرية المعقدة. إن طبيعته مفتوحة المصدر وقدراته الشاملة تجعله موردًا قيمًا للمطورين والباحثين في مجال الذكاء الاصطناعي.
- الفئةنماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
- نموذج التسعيرمفتوح المصدر
- النشرسحابي
- المنصاتالويب
أبرز ملامح Mage-VL
مشفر بصري يعتمد على الترميز
بوابة بث استباقية
مفكك سببي Qwen3-4B
تسريع الاستدلال بمعدل 3.5×
محلل بيانات فعال
تدريب مسبق بدقة متغيرة
نموذج موحد للصور والفيديوهات
تعليقات مبنية على الأحداث
البدء مع Mage-VL
الوصول إلى صفحة النموذج: زيارة مستودع Hugging Face
المصادقة: استخدام بيانات اعتماد حساب Hugging Face الخاص بك
التكوين: إعداد معلمات النموذج والبيئة
إرسال المطالبات: إدخال بيانات الصورة أو الفيديو الخاصة بك للمعالجة
التعديل الدقيق: ضبط إعدادات النموذج للمهام المحددة
حالات استخدام Mage-VL
- تحليل الفيديو في الوقت الحقيقي
- الذكاء المكاني
- تعليقات مبنية على الأحداث
- فهم الصور
- البث الاستباقي