الوصف
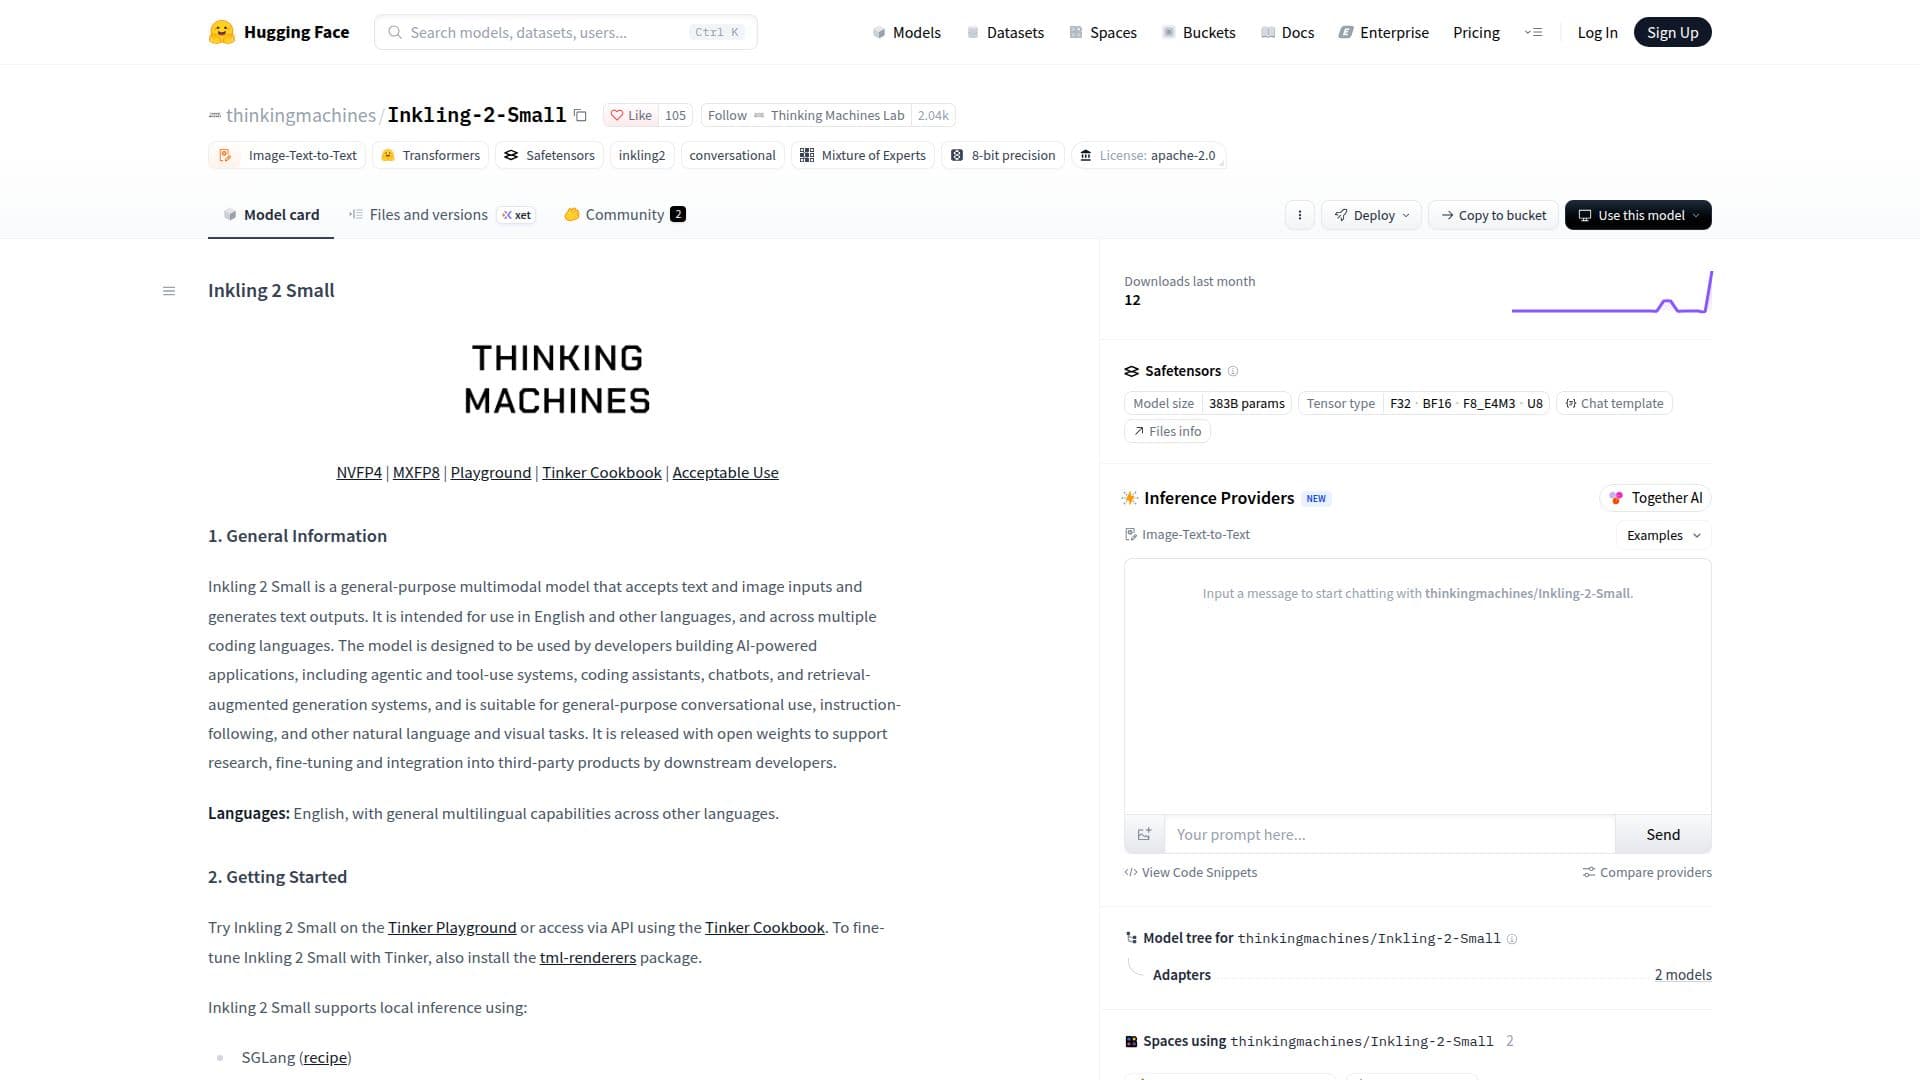
Inkling 2 Small هو نموذج متعدد الوسائط متعدد الاستخدامات قادر على معالجة مدخلات النص والصورة لإنتاج مخرجات نصية. تم تصميمه ليكون قابلاً للتطبيق على نطاق واسع، حيث يدعم اللغة الإنجليزية ولغات أخرى، بالإضافة إلى لغات برمجة متنوعة. النموذج موجه بشكل خاص للمطورين الذين يقومون بإنشاء تطبيقات مدعومة بالذكاء الاصطناعي، مثل الأنظمة الوكيلة وأنظمة استخدام الأدوات، مساعدي البرمجة، الدردشة، وأنظمة التوليد المعزز بالاسترجاع (RAG). كما أن تصميمه يجعله مناسبًا للتفاعلات الحوارية العامة، واتباع التعليمات، ومجموعة واسعة من المهام اللغوية الطبيعية والمرئية.
قراءة المزيد
تم إصدار Inkling 2 Small مع أوزان مفتوحة، مما يشجع على البحث، والتخصيص، والتكامل في المنتجات التابعة من قبل المطورين. يمكن للمستخدمين تجربة النموذج على Tinker Playground أو الوصول إليه عبر API باستخدام Tinker Cookbook. للتخصيص باستخدام Tinker، يتطلب الأمر حزمة tml-renderers. يدعم النموذج الاستدلال المحلي من خلال أطر عمل متنوعة بما في ذلك SGLang، vLLM، TokenSpeed، وUnsloth. بالإضافة إلى ذلك، يمكن تدريبه بعد ذلك باستخدام Miles، SkyRL، وSnowflake Cortex Training. الوصول إلى API متاح أيضًا من خلال مزودي الاستدلال من الأطراف الثالثة مثل NVIDIA، Fireworks، Together، Baseten، Nebius، Modal، وCloudflare.
تعتمد متطلبات الأجهزة لـ Inkling 2 Small على تنسيق نقطة التحقق. تتطلب نقطة التحقق الرئيسية NVFP4 مجموعة GPU تحتوي على ما لا يقل عن 500 جيجابايت من VRAM المجمعة، وهو ما يمكن تحقيقه مع تكوينات مثل 2x NVIDIA B300 GPUs أو 4x NVIDIA H200 GPUs. تتطلب نقطة التحقق البديلة MXFP8 ما لا يقل عن 800 جيجابايت من VRAM المجمعة، والتي يمكن تلبيتها بواسطة 4x NVIDIA B300 GPUs أو 8x NVIDIA H200 GPUs. يُوصى باستخدام نقطة التحقق NVFP4 لجميع حالات الاستخدام لأنها الدقة الأصلية للنموذج، مما يوفر أداءً مثاليًا.
معماريًا، يعد Inkling 2 Small نموذجًا متعدد الوسائط من نوع المحولات التلقائية. يتميز بمحول مكون من 48 طبقة فقط من فك التشفير مع هيكل خلفي نادر من مزيج من الخبراء (MoE)، حيث يتم توجيه كل رمز إلى 8 من 384 خبيرًا. يجمع آلية الانتباه بين الطبقات المحلية والعالمية. النموذج متعدد الوسائط بشكل أصلي، حيث يقوم بتشفير الصور عبر محول بصري ويعرض كل من مدخلات الصورة والنص في مساحة خفية مشتركة لمعالجتها بشكل مشترك بواسطة فك التشفير. يدعم نافذة سياق تصل إلى 1 مليون رمز ويقبل النص بتشفير UTF-8 وصيغ الصور المعتمدة على البكسل (يفضل أن تكون بين 40 بكسل و4096 بكسل لكل بُعد). يتم توليد المخرجات كنص مشفر بتشفير UTF-8.
تشمل بيانات التدريب لـ Inkling 2 Small مجموعة متنوعة من أنواع المحتوى، مثل النصوص والصور والفيديو، المستمدة من مستودعات متاحة للجمهور، والأطراف الثالثة، والتوليد الداخلي، والتعزيز الاصطناعي. تتضمن عملية تنسيق البيانات تنظيف ومعالجة وتعديل مجموعات البيانات، بما في ذلك إزالة التكرار والتصفية من أجل الجودة والسلامة. تم إجراء تقييمات السلامة عبر تفاعلات الإنسان والذكاء الاصطناعي اليومية واختبارات القدرات الخطرة، مع تطبيق تدابير للحد من المخاطر. المعرفة في النموذج محدودة بموعد قطع التدريب، وينصح المستخدمون بتطبيق إشراف بشري للتطبيقات ذات المخاطر العالية بسبب القيود المحتملة مثل الهلوسة والتحيزات من بيانات التدريب.
- الفئةنماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
- نموذج التسعيرمفتوح المصدر
- النشرسحابي, استضافة ذاتية
- المنصاتالويب
أبرز ملامح Inkling 2 Small
مدخلات متعددة الوسائط: يقبل كل من مدخلات النص والصورة
مخرجات نصية: يولد مخرجات نصية مشفرة بتشفير UTF-8
نموذج متعدد الاستخدامات: مناسب لمجموعة واسعة من التطبيقات
قدرات متعددة اللغات: يدعم اللغة الإنجليزية ولغات أخرى
دعم لغات البرمجة المتعددة: يعمل عبر لغات برمجة متنوعة
أوزان مفتوحة: متاحة للبحث، والتخصيص، والتكامل
الوصول إلى API: متاح عبر Tinker Cookbook ومزودي الأطراف الثالثة
دعم الاستدلال المحلي: متوافق مع SGLang، vLLM، TokenSpeed، Unsloth
خيارات التدريب بعد ذلك: يمكن تدريبه بعد ذلك باستخدام Miles، SkyRL، Snowflake Cortex Training
محول تلقائي: يستخدم هيكل 48 طبقة فقط من فك التشفير
مزيج من الخبراء (MoE): هيكل خلفي نادر مع 384 خبيرًا
مساحة خفية مشتركة: يعالج مدخلات الصورة والنص بشكل مشترك
نافذة سياق: يدعم حتى 1 مليون رمز
عدد كبير من المعلمات: 594 مليار معلمة إجمالية، 17 مليار نشطة
البدء مع Inkling 2 Small
الوصول إلى النموذج: زيارة صفحة Inkling 2 Small على Hugging Face.
تجربة الملعب: تجربة النموذج مباشرة على Tinker Playground.
الوصول عبر API: استخدام Tinker Cookbook لتكامل النموذج عبر API.
تخصيص النموذج: تثبيت حزمة tml-renderers لتخصيص Inkling 2 Small باستخدام Tinker.
الاستدلال المحلي: استخدام أطر عمل مثل SGLang، vLLM، TokenSpeed، أو Unsloth للنشر المحلي.
التدريب بعد ذلك: تعزيز النموذج باستخدام Miles، SkyRL، أو Snowflake Cortex Training.
النشر مع المزودين: الوصول إلى API من خلال مزودي الاستدلال من الأطراف الثالثة مثل NVIDIA أو Fireworks.
تكوين الأجهزة: التأكد من وجود مجموعة GPU تحتوي على ما لا يقل عن 500 جيجابايت من VRAM لنقطة التحقق NVFP4 أو 800 جيجابايت لنقطة التحقق MXFP8.
حالات استخدام Inkling 2 Small
- بناء تطبيقات الذكاء الاصطناعي
- تطوير الأنظمة الوكيلة
- مساعدي البرمجة
- إنشاء الدردشة
- التوليد المعزز بالاسترجاع
- الاستخدام الحواري العام
- اتباع التعليمات
- المهام المرئية
- البحث والتجريب
- تكامل المنتجات التابعة