Описание
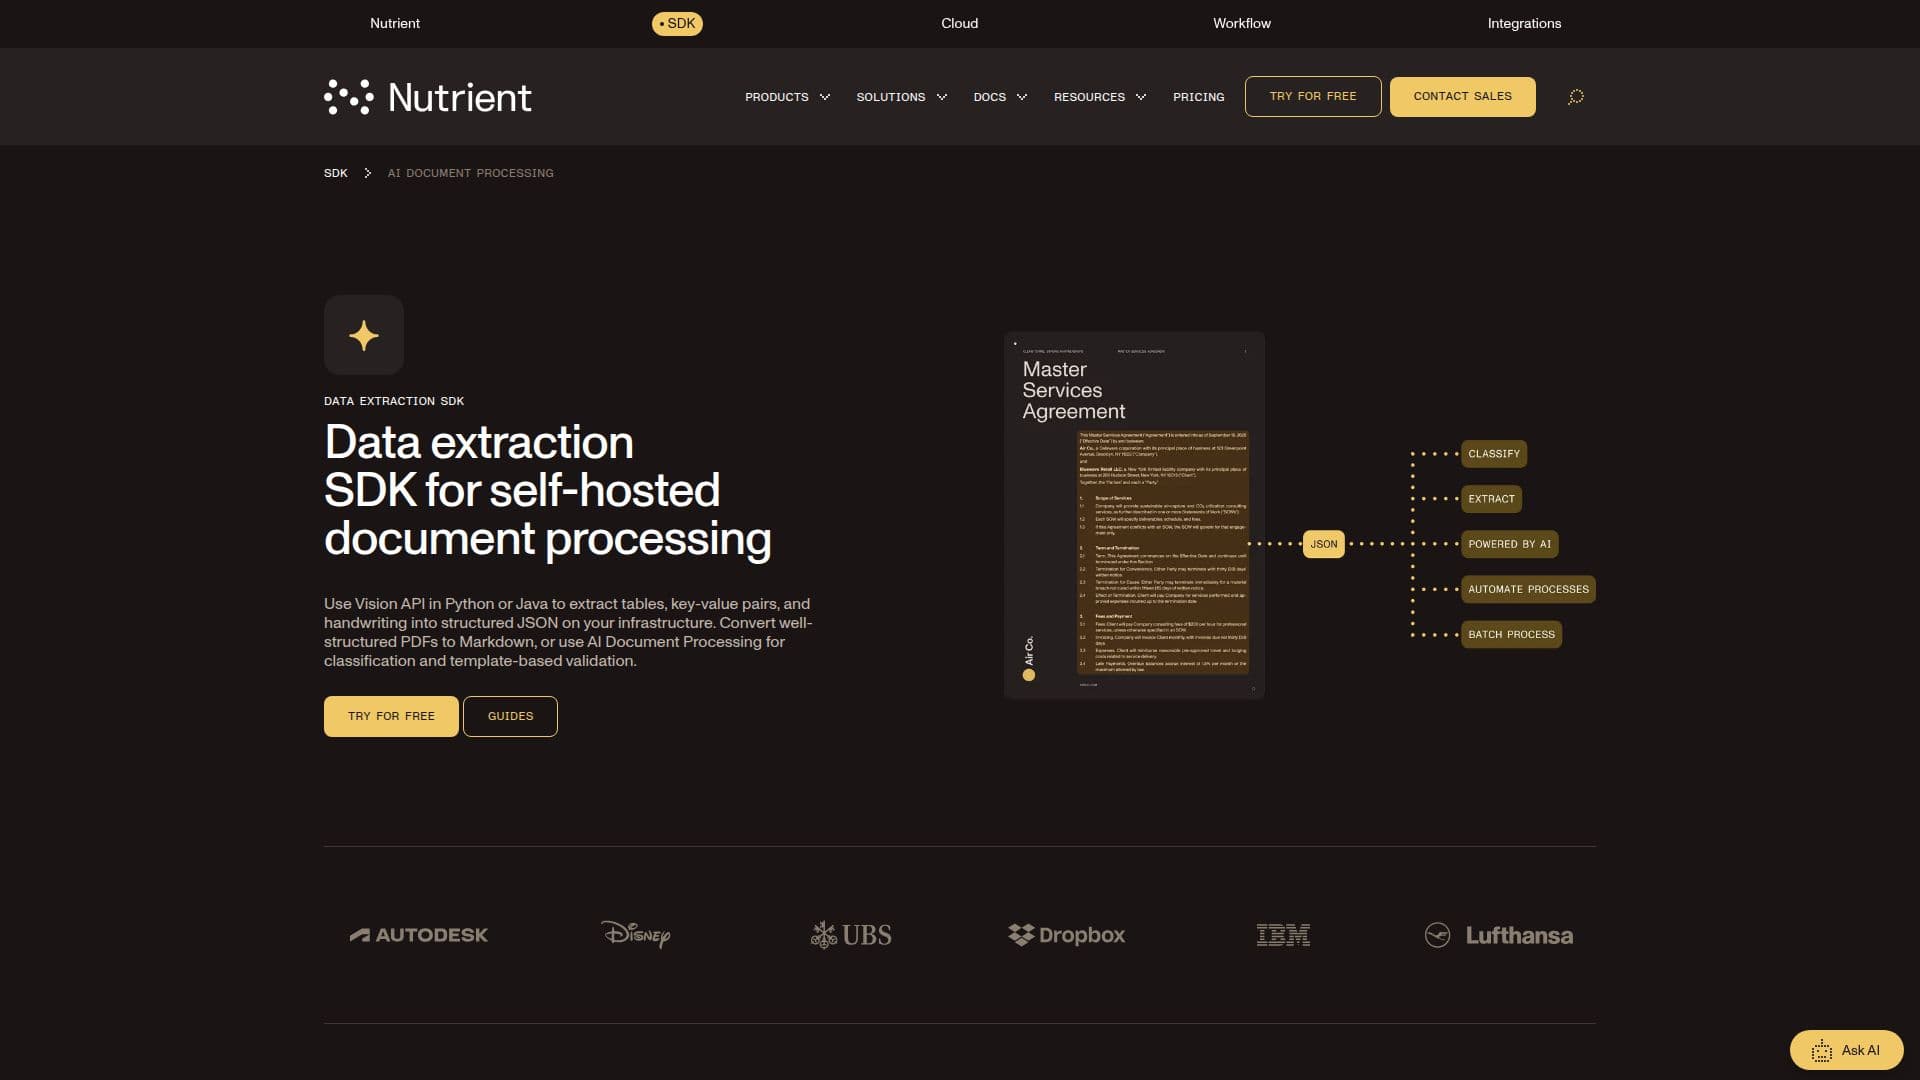
Обработка документов Nutrient AI — это SDK для извлечения данных из документов, ранее продававшийся под названием XtractFlow компанией Nutrient (ранее PSPDFKit). Он работает как часть SDK Nutrient для Python и Java и предназначен для обработки счетов, заказов на покупку, удостоверений личности, резюме и квитанций на инфраструктуре компании, а не через облачный сервис третьей стороны.
Читать далее
LLM определяет тип документа и направляет его к соответствующему шаблону извлечения; десять шаблонов поставляются готовыми к использованию, охватывающими такие документы, как счета, паспорта, удостоверения личности и квитанции, а пользовательские шаблоны могут быть созданы путем описания необходимых полей на простом языке, а не написания правил или регулярных выражений. Извлеченные значения проверяются одиннадцатью встроенными валидаторами, включая IBAN, VAT ID, номер кредитной карты, почтовый адрес, электронную почту и номер телефона; любое значение, не прошедшее проверку, помечается как требующее верификации, а не принимается молча.
Та же страница продукта также охватывает более низкоуровневый SDK для извлечения данных Nutrient, который возвращает структурированный JSON с координатами элементов, порядком чтения и оценками уверенности с использованием OCR, локальных AI моделей для компоновки и распознавания рукописного текста (ICR) или модели визуального языка, которая может работать локально с Qwen или подключаться к облачному провайдеру, такому как Claude или OpenAI. Он считывает более 100 типов файлов, включая отсканированные PDF, документы Office, файлы CAD и более 40 форматов RAW с камер, а также обрабатывает многоколонные макеты, смешанные языки и искаженные сканы. Отдельный режим PDF в Markdown преобразует уже цифровые PDF в чистый Markdown без запуска каких-либо AI моделей.
Обработка документов AI требует подключения к провайдеру LLM (OpenAI или Azure OpenAI); режимы OCR, ICR и PDF в Markdown работают полностью локально без необходимости в сетевом доступе. Извлечение данных доступно сегодня для Python (3.8+) и Java (8+), поддержка .NET и API DWS Processor запланированы; предлагается бесплатная пробная версия без необходимости предоставления платежной информации.
Это SDK для разработчиков, а не хостинг-инструмент без кода, предназначенный для инженерных команд, создающих процессы обработки счетов, верификации удостоверений личности или потоков ввода документов, которым необходимо контролировать, куда идут их документы и данные. Кроссплатформенная поддержка обработки документов AI за пределами текущей доступности запланирована, а не выпущена сегодня.
- КатегорияВеб-скрапинг и извлечение данных
- Модель ценообразованияКомпонентный
- РазвёртываниеЛокально, облако
- ПлатформыPython, Java
Основные функции Обработка документов Nutrient AI
Классификация документов на основе LLM, которая направляет каждый документ к соответствующему шаблону извлечения
Десять готовых шаблонов для счетов, паспортов, удостоверений личности, квитанций и других документов
Пользовательские шаблоны извлечения, определяемые на простом языке, без необходимости в регулярных выражениях или движке правил
Одиннадцать встроенных валидаторов (IBAN, VAT ID, номер кредитной карты, почтовый адрес, электронная почта, номер телефона и другие)
Три движка извлечения (OCR, ICR и VLM), объединенные в структурированный JSON с координатами и оценками уверенности
Локальная обработка для каждого движка, включая модель визуального языка, с подключением облачных провайдеров только при выборе
Поддержка более 100 типов файлов, включая отсканированные PDF, документы Office и файлы CAD
Конвертация PDF в Markdown для цифровых PDF, без необходимости в AI модели или сетевом доступе
SDK для Python и Java доступен сегодня, поддержка .NET и API DWS Processor запланированы
Как использовать Обработка документов Nutrient AI?
Установите SDK: добавьте SDK Nutrient для Python или Java в ваш проект.
Выберите режим извлечения: выберите PDF в Markdown для чистых цифровых PDF или Извлечение данных (OCR, ICR или VLM) для сканов и сложных макетов.
Подключите LLM (по желанию): для обработки документов AI настройте ключ OpenAI или Azure OpenAI для включения классификации и шаблонов.
Запустите извлечение: обработайте документ и получите структурированный JSON с координатами, оценками уверенности и порядком чтения.
Проверьте поля: встроенные валидаторы помечают значения, такие как IBAN или VAT ID, которые не прошли проверку формата.
Разверните на вашей инфраструктуре: запускайте SDK в саморазмещенном режиме, так как данные документов остаются в вашей сети, если вы не подключаете облачного провайдера.
Варианты использования Обработка документов Nutrient AI
- Обработка счетов
- Верификация удостоверений личности и паспортов
- Цифровизация отсканированных документов
- Саморазмещаемые потоки данных