Описание
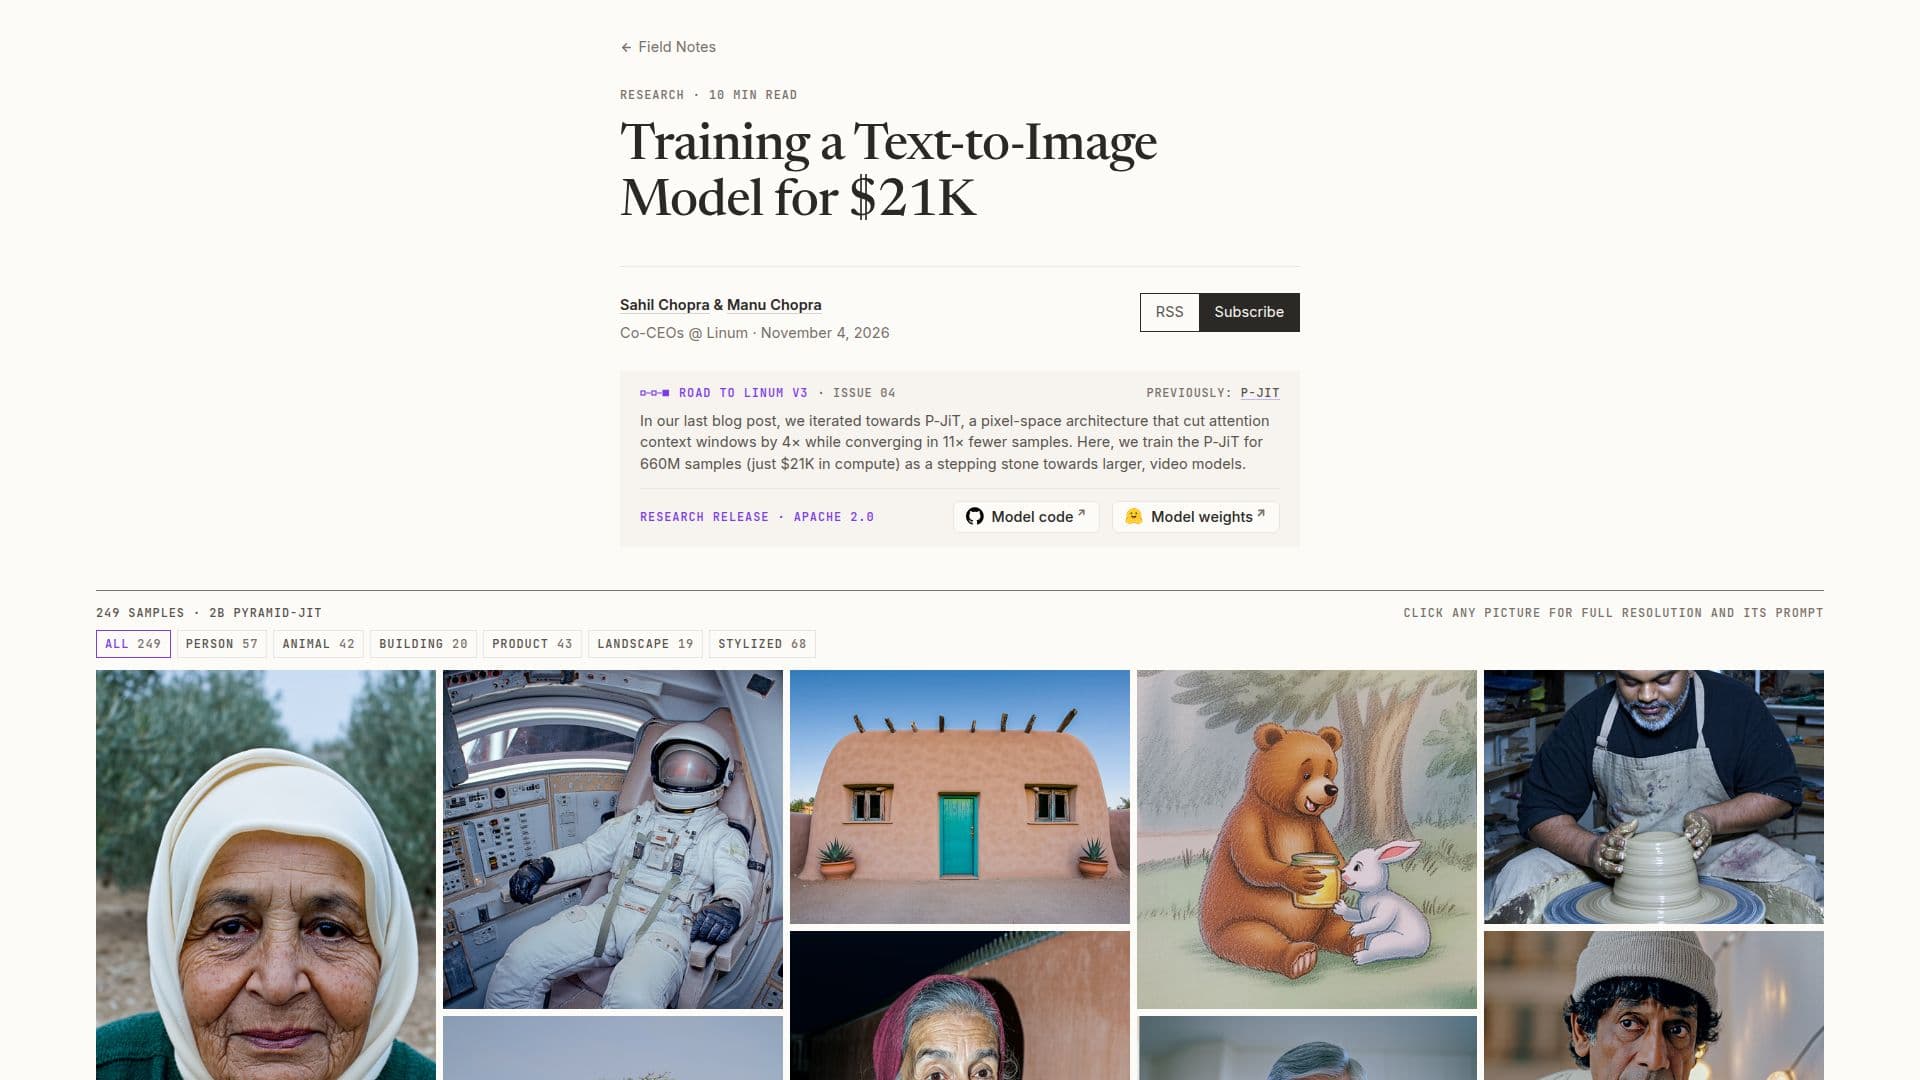
Linum P-JiT — это экспериментальная модель текст-в-изображение, разработанная Linum, двухчленной исследовательской лабораторией, посвященной обучению генеративных видео моделей с нуля. Эта конкретная модель, 2B-параметрическая Pyramid-JiT (P-JiT), служит доказательством концепции для их продолжающихся исследований по демократизации доступа к анимации через экономически эффективные и управляемые генеративные инструменты. Стоимость обучения этой модели составила примерно $21,038, что демонстрирует потенциал для получения высококачественных результатов при относительно низких вычислительных затратах.
Читать далее
Основная инновация P-JiT заключается в его способности достигать более агрессивного сжатия и более быстрого обучения за счет исключения традиционного вариационного автокодировщика (VAE) из архитектуры диффузионной модели. Вместо этого диффузионная модель изучает скрытое пространство, специально созданное для ее случая использования, что позволяет добиться большего сжатия и улучшенной генерации. Эта модель в пиксельном пространстве сходится за 11 раз меньшего количества образцов, чем Linum v2, и предлагает в четыре раза более агрессивное сокращение токенов, представляя изображение 512x512 с тем же количеством токенов, что и ранее использовалось для изображения 256x256. Это приводит к четырехкратному сокращению окна контекста внимания, значительно снижая затраты на обучение и вывод.
Архитектура P-JiT включает в себя конвейер обработки текста и изображений, где каждая модальность проходит через блоки «очистки» DiT перед объединением в поток из 22 идентичных блоков DiT. Представление текста извлекается из замороженной модели Qwen3.5-4B, в то время как изображения разбиваются на патчи 32x32 и сжимаются в 1024-мерное пространство. Модель также включает в себя считывания PixelREPA, выровненные по DINOv3-L, и дополнительные линейные головы считывания вдоль ствола для ускорения сходимости, предсказывая низкоразрешенные версии финального изображения.
Обучение проводилось в несколько этапов, начиная с разрешения 512x512 для 610 миллионов образцов и затем переходя к разрешению 1024x1024 для 50 миллионов образцов. Использовалась учебная программа по графику шума, изначально сосредоточенная на высоком уровне шума для изучения базовой структуры, а затем расширяющая распределение для тонких деталей. После обучения использовался вариант оптимизации конечной разности потока (FDFO) с JEV-Image и судьями с участием человека. Хотя модель показывает многообещающие результаты, у нее есть ограничения, особенно в генерации полных тел, множественных объектов, взаимодействиях между несколькими людьми и общем знании мира, что является обычным для моделей такого размера. Она не обучалась на изображениях с рендерингом текста, поэтому не может генерировать текст или постеры.
- КатегорияИИ-модели и LLM
- Модель ценообразованияОткрытый код
- РазвёртываниеОблако
- ПлатформыВеб
Основные функции Linum P-JiT
Архитектура Pyramid-JiT (P-JiT): Новая модель в пиксельном пространстве для эффективной генерации
2B-параметрический DiT: Основной размер модели диффузионного трансформера
4B текстовый кодировщик: Использует замороженную модель Qwen3.5-4B для представления текста
Дизайн без VAE: Исключает VAE для более агрессивного сжатия и более быстрого обучения
Сокращение токенов в 4 раза: Представляет изображения 512x512 с 4 раза меньшим количеством токенов, чем Linum v2
Сходимость в 11 раз быстрее: Достигает результатов с значительно меньшим количеством образцов для обучения
Многоступенчатое обучение: Переход от разрешения 512x512 к 1024x1024
Учебная программа по графику шума: Адаптирует распределение шума для изучения структуры и деталей
Считывания PixelREPA: Выравнивает скрытое пространство по DINOv3-L для улучшенного изучения деталей
Линейные головы считывания: Предсказывает чистые изображения с четвертью и половиной разрешения для ускоренной сходимости
Оптимизация конечной разности потока (FDFO): Используется для дообучения после обучения
Лицензия Apache 2.0: Веса выпущены под лицензией с открытым исходным кодом
Экономичное обучение: Достигнуты высококачественные результаты примерно за $21K
Фокус на исследованиях генеративного видео: Шаг к будущим видео моделям
Как использовать Linum P-JiT?
Понять архитектуру: Изучите детали архитектуры P-JiT, включая потоки обработки текста и изображений.
Изучить режим обучения: Узнайте о многоступенчатом процессе обучения, графиках шума и переходах разрешения.
Изучить ограничения модели: Поймите текущие ограничения в отношении генерации полных тел, множественных объектов и генерации текста.
Получить доступ к настройкам обучения: Обратитесь к приложению A для подробных параметров и конфигураций обучения.
Просмотреть разбивку затрат: Ознакомьтесь с разбивкой затрат на вычисления до и после обучения.
Анализировать примеры неудач: Изучите предоставленные примеры неудач модели, чтобы понять текущие возможности и области для улучшения.
Варианты использования Linum P-JiT
- Исследование генерации текст-в-изображение
- Экономичное обучение модели
- Разработка генеративных видео моделей
- Тестирование архитектурных инноваций
- Эксперименты с открытым исходным кодом AI