Описание
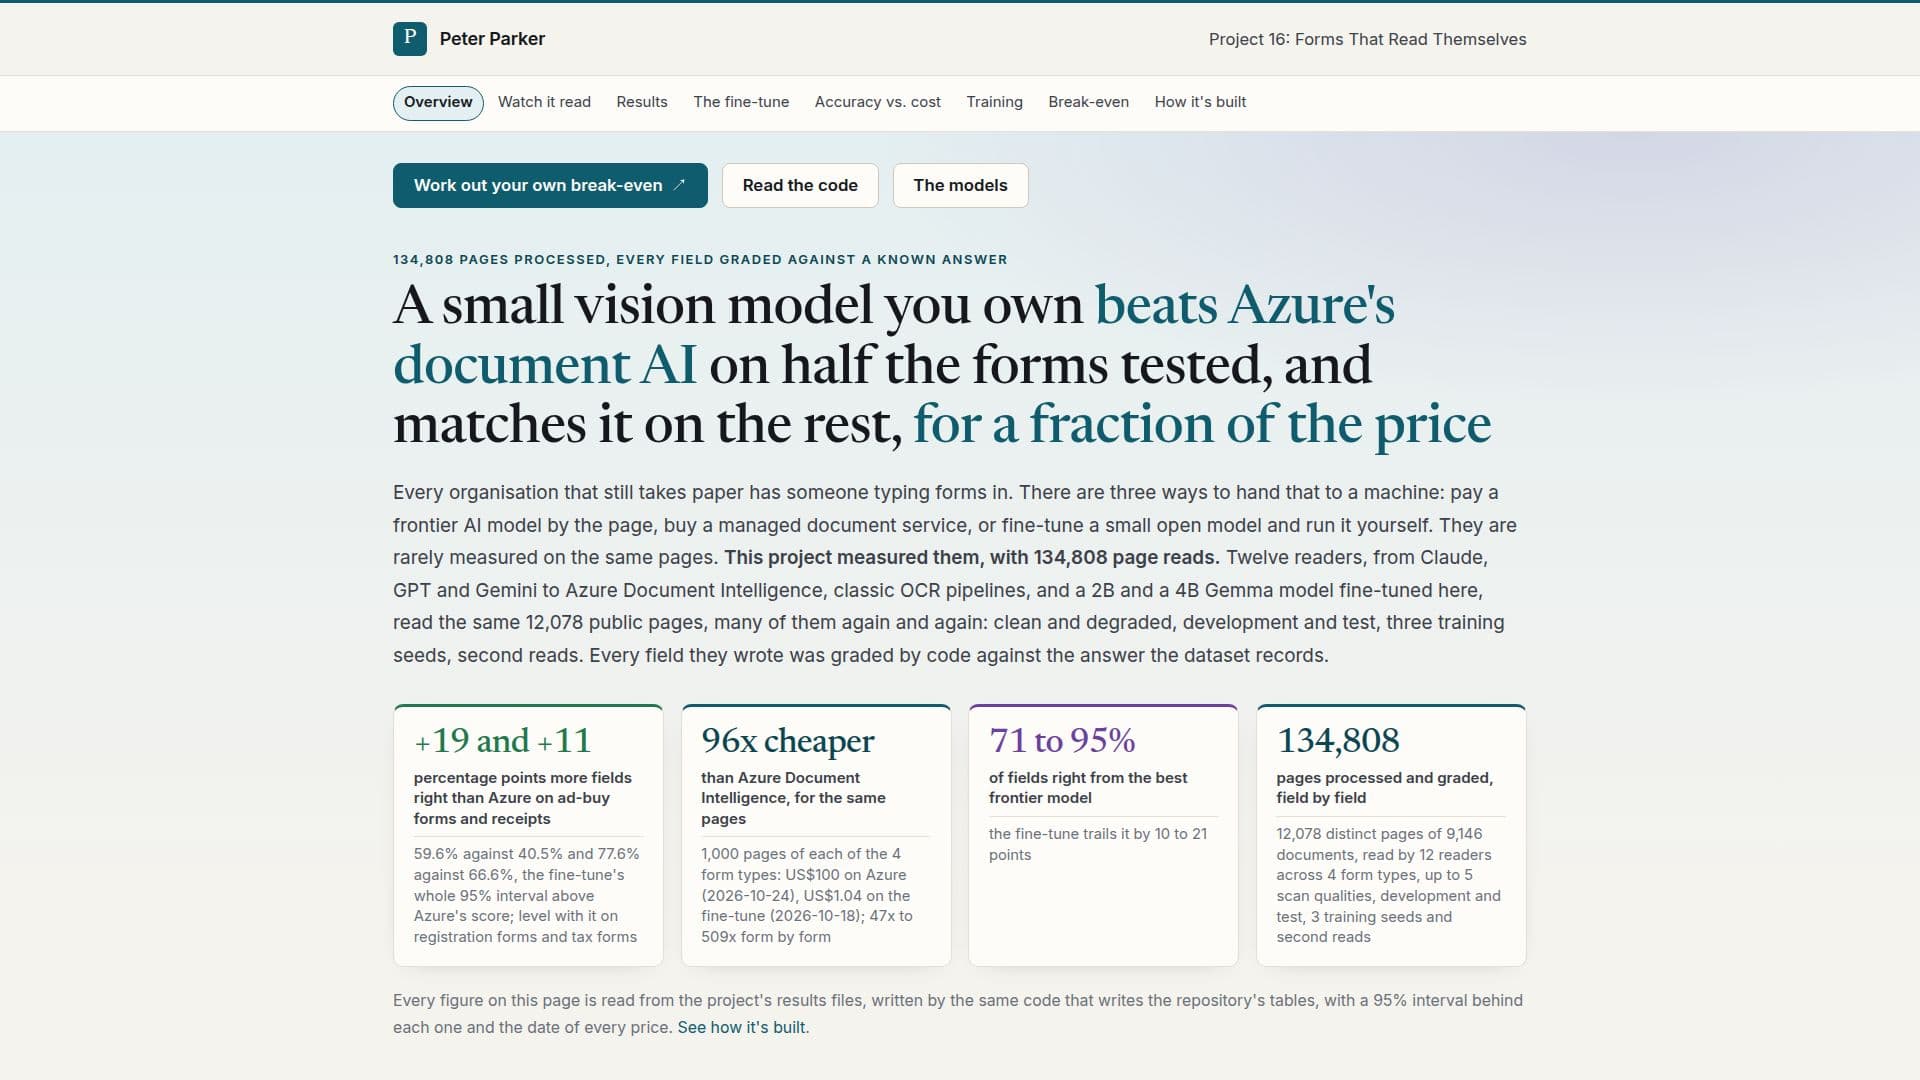
Forms That Read Themselves представляет собой всестороннюю оценку двенадцати различных считывателей для отсканированных форм, начиная от современных API для зрения и заканчивая пользовательской моделью с 2B параметрами, специально настроенной для этой цели. Основное предложение — это небольшая модель зрения, которой пользователи могут владеть и управлять, предоставляя экономически эффективную альтернативу коммерческим решениям, таким как Azure Document Intelligence.
Читать далее
Платформа тщательно оценивает каждое поле считывателя по полям на публичных наборах данных с известными ответами, включая NIST Special Database 2 для налоговых форм США 1988 года, подачи по Закону о регистрации иностранных агентов, заказы на политическую рекламу FCC и квитанции CORD v2. Это строгая оценка показывает, что тонко настроенная модель превосходит Azure Document Intelligence по половине протестированных типов форм и соответствует ее производительности по остальным, при этом работая по значительно более низкой цене. Например, по формам для покупки рекламы тонко настроенная модель достигает 59.6% точности по сравнению с 40.5% у Azure, а по квитанциям — 77.6% против 66.6%.
Ключевым выводом является трансформирующее влияние тонкой настройки на более мелкие модели. Ненастроенные модели, такие как Gemma 4 E2B, показывают значительно более низкую точность (например, 15.0% по налоговым формам), которая резко улучшается до 73.6% после тонкой настройки. Этот процесс может занять всего от 8 минут до 4.9 часов на арендованном GPU, что делает эти более мелкие модели высоко конкурентоспособными. Тонко настроенная модель также демонстрирует более низкий уровень изобретения значений по сравнению с передовыми моделями по определенным типам форм, таким как регистрационные формы и квитанции, что имеет решающее значение для приложений, где пустое поле предпочтительнее уверенного, но неправильного ввода.
Хотя передовые модели зрения, такие как GPT-6.1 Sol и Gemini 3.8 Flash, как правило, достигают более высокой точности, тонко настроенная модель предлагает убедительный баланс между производительностью и стоимостью. Например, по квитанциям она достигает 77.6% точности за US$0.16 за тысячу страниц, по сравнению с 76.7% у Claude Haiku 5.5 за US$0.38. Значительным преимуществом владения и запуска модели на потребительском GPU является повышенная конфиденциальность данных, так как ни одна страница не покидает сеть пользователя.
Проект также подчеркивает устойчивость моделей зрения к ухудшению качества сканирования. В отличие от конвейеров на основе OCR, которые страдают от резкого падения точности при плохом качестве сканирования, модели зрения, считывающие пиксели напрямую, сохраняют высокую производительность. Однако важно отметить, что ни один считыватель не достиг 99% точности по всем полям, что означает, что человеческая проверка остается необходимой для критических приложений. Модели в первую очередь автоматизируют процесс ввода, а не окончательную проверку.
Архитектура включает обучение моделей Gemma 4 E2B и E4B с открытыми весами с использованием QLoRA, замораживая веса базовой модели в 4 бита, в то время как обучаются небольшие матрицы адаптеров. Эти адаптеры обслуживаются с помощью vLLM на GPU RTX 3090, что позволяет эффективно развертывать на месте. Сайт предоставляет калькулятор для определения точки безубыточности между затратами на API и арендой GPU, подчеркивая, что истинная стоимость модели, которой вы владеете, зависит от ее использования.
- КатегорияИнструменты компьютерного зрения
- Модель ценообразованияGPU Rental Cost
- РазвёртываниеЛокально
- ПлатформыВеб
Основные функции Forms That Read Themselves
Тонко настроенные модели зрения для извлечения данных из отсканированных форм
Сравнение с передовыми API для зрения (GPT-6.1 Sol, Claude Sonnet, Gemini Flash)
Сравнение с Azure Document Intelligence
Поддержка различных типов форм: регистрационные, формы для покупки рекламы, квитанции, налоговые формы
Оценка точности по полям на публичных наборах данных
Экономически эффективная альтернатива коммерческим API
Возможность развертывания на месте на потребительских GPU (например, RTX 3090)
Сниженное изобретение значений по определенным типам форм
Устойчивость к ухудшению качества сканирования (шум, размытие, искажение, потеря контраста)
Подробные метрики производительности, включая правильные поля и стоимость за тысячу страниц
Базовые модели с открытыми весами (Gemma 4 E2B, E4B), используемые для тонкой настройки
Рецепт тонкой настройки QLoRA для эффективного обучения на одиночных GPU
vLLM для обслуживания тонко настроенных моделей
Калькулятор для анализа точки безубыточности между API и арендой GPU
Конфиденциальность данных за счет хранения страниц в вашей сети
Как использовать Forms That Read Themselves?
Выберите считыватель: выберите из различных моделей зрения или конвейеров OCR для сравнения их производительности.
Настройте качество сканирования: смоделируйте различные уровни ухудшения (шум, размытие, искажение, потеря контраста), чтобы наблюдать влияние на точность.
Просмотрите результаты по полям: посмотрите, какие поля каждый считыватель правильно извлекает, отмеченные зеленым, и какие неверные, отмеченные красным и пунктиром.
Анализируйте точность и стоимость: сравните долю правильных полей и стоимость за тысячу страниц для различных считывателей и типов форм.
Поймите влияние тонкой настройки: наблюдайте, как тонкая настройка значительно улучшает точность более мелких моделей по определенным типам форм.
Оцените затраты на развертывание: используйте предоставленный калькулятор, чтобы определить экономическую целесообразность аренды GPU по сравнению с использованием коммерческих API в зависимости от вашего объема.
Получите адаптеры: загрузите доступные тонко настроенные адаптеры для квитанций, форм для покупки рекламы и налоговых форм с Hugging Face.
Варианты использования Forms That Read Themselves
- Автоматизированное извлечение данных из форм
- Экономически эффективная обработка документов
- Обработка данных на месте
- Оценка моделей AI для зрения
- Улучшение точности OCR
- Разработка пользовательских моделей