Перейти к основному содержимому
ToolPotion
ИИ-советник
Отправить

Flide

Flide — это высокопроизводительная инфраструктура вывода, разработанная для моделей принятия решений в стиле Jev. Она ускоряет вывод решений, разделяя одно состояние на все его вопросы в одном прямом проходе, обеспечивая, чтобы каждый вопрос получал ответ, идентичный тому, который он получил бы, если бы был задан отдельно. Этот подход значительно увеличивает пропускную способность и поддерживает высокую точность для сложных процессов принятия решений.

Посетить URL
Поделиться
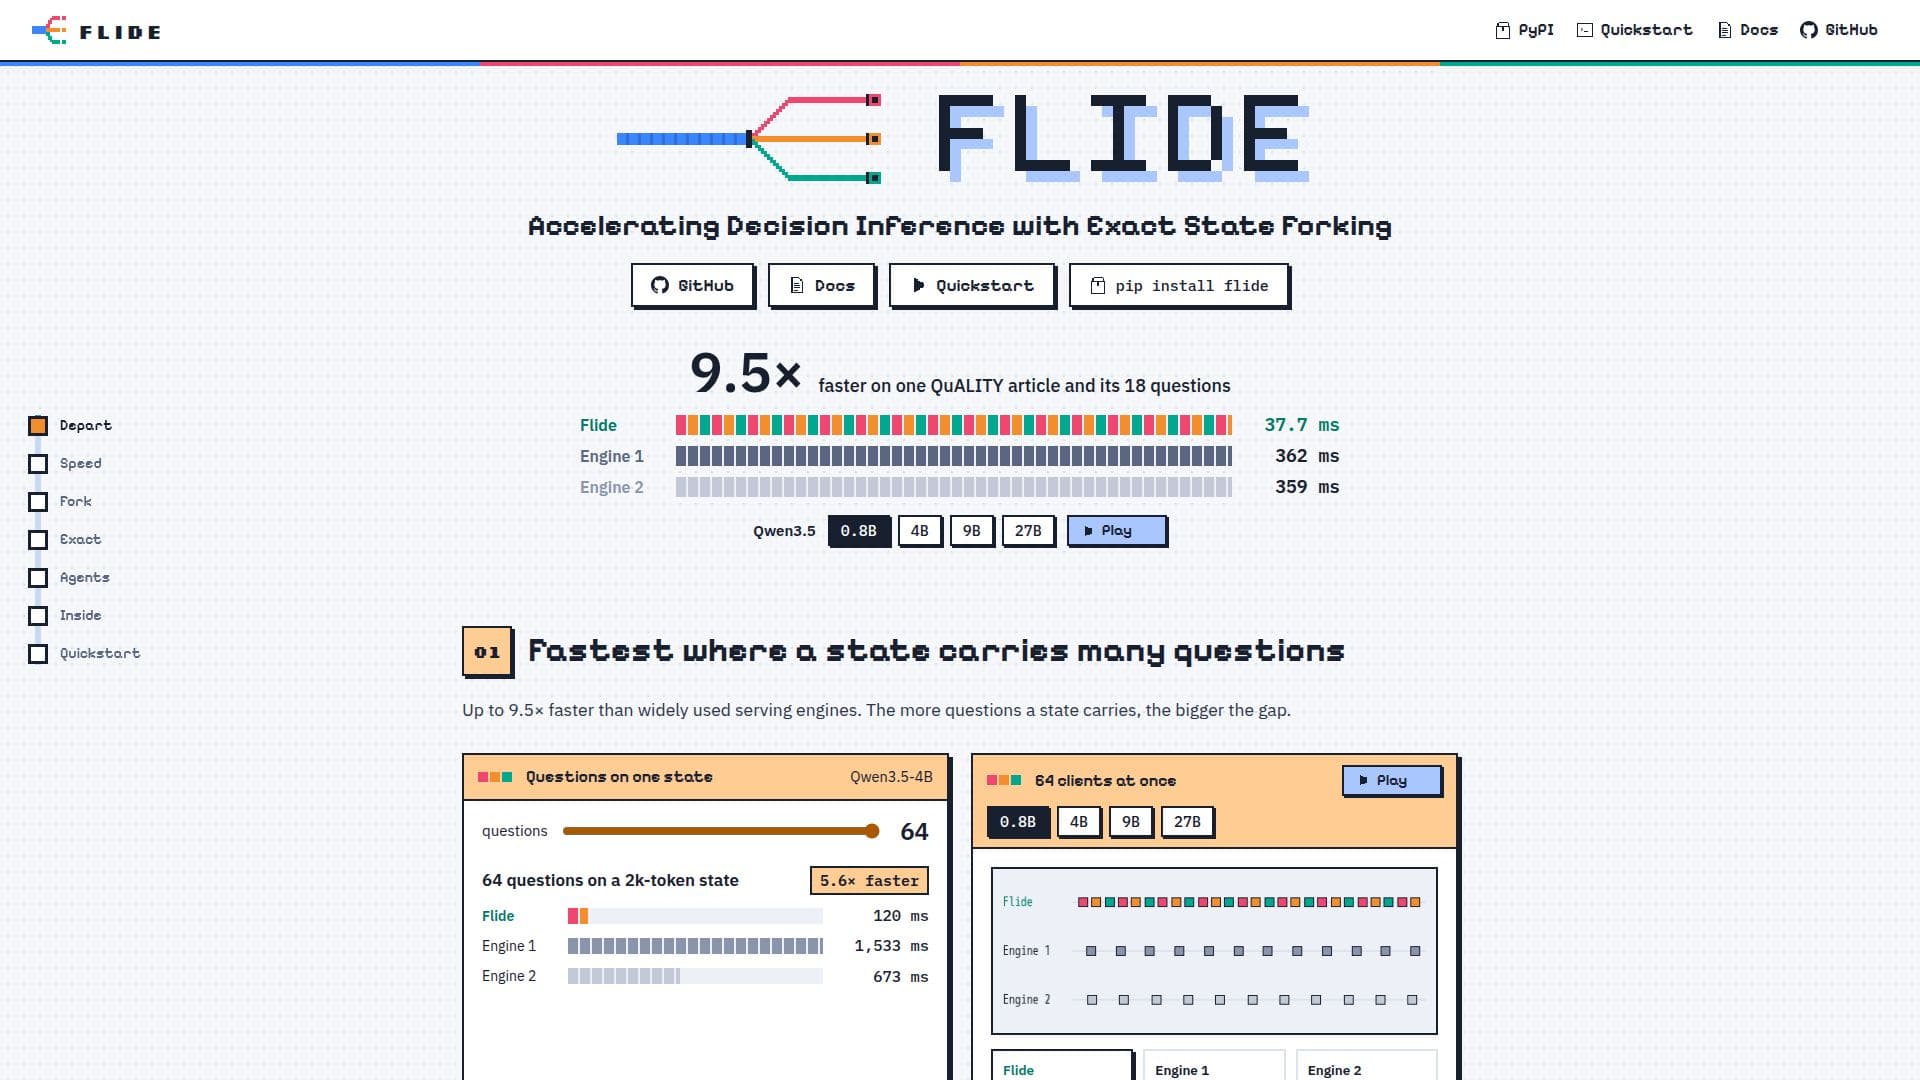
Скриншот Flide
Скриншот Flide

Flide — это продвинутая инфраструктура вывода, специально разработанная для ускорения моделей принятия решений в стиле Jev. Его основная инновация заключается в способности выполнять точное разделение состояния, позволяя обрабатывать одно входное состояние для нескольких вопросов в одном прямом проходе. Это означает, что состояние считывается только один раз, а затем эффективно разделяется, обеспечивая, чтобы каждый вопрос получал точный ответ, который он получил бы, если бы был задан в изоляции.

Читать далее

Эта уникальная архитектура обеспечивает значительные приросты производительности, при этом Flide демонстрирует до 9,5 раз более быстрое выполнение по сравнению с широко используемыми серверами, такими как vLLM и SGLang. Преимущество в производительности становится еще более заметным по мере увеличения числа вопросов, связанных с данным состоянием. Например, с 64 вопросами на состоянии в 2k токенов Flide достигает ускорения в 9,5 раз и 2,2 раза большей пропускной способности с 64 клиентами.

Помимо скорости, Flide придает первостепенное значение точности, оставаясь в пределах 1,1 пункта от эталона float32, что делает его одним из самых близких движков к эталонному значению. Он поддерживает различные модели, включая модели чата на основе Qwen3.5 и Gemma 4, а также модели OneJev. Flide также обрабатывает гибридные модели, где слои Gated DeltaNet обеспечивают, чтобы каждый вопрос начинался с точного состояния общего контекста. Система предлагает опцию `--batch-invariant`, гарантируя, что запрос дает одинаковые биты независимо от того, как он сгруппирован.

Установка проста через pip, и она поддерживает обслуживание с предустановленными ядрами для различных графических процессоров NVIDIA, включая A40, A10, RTX 30, H100 и H200. Flide предоставляет тот же API `/v1/systemone`, что и vLLM и SGLang, предоставляя вероятности для каждого варианта в ответе. Он поддерживает мультимодальные входы, включая текст, изображения и видео, в зависимости от основной модели. Такие функции, как квантование FP8 для Qwen3.5 на графических процессорах Ada, Hopper и Blackwell, а также кэш сессий для возобновления состояний агентов, дополнительно улучшают его возможности.

  • КатегорияMLOps и развёртывание моделей
  • РазвёртываниеСамостоятельный хостинг
  • ПлатформыВеб

  • Точное разделение состояния: Обрабатывает одно состояние для всех вопросов в одном прямом проходе.

  • Ускоренный вывод: До 9,5 раз быстрее, чем другие серверы.

  • Высокая пропускная способность: Достигает 2,2 раза большей пропускной способности с 64 клиентами на определенных тестах.

  • Близость к эталону float32: Остается в пределах 1,1 пункта от эталона float32 для точности.

  • Непрерывность пакетов: Обеспечивает последовательные результаты независимо от группировки с помощью `--batch-invariant`.

  • Механизм ForkAttention: Каждый вопрос считывает свое состояние на месте, как если бы он был задан отдельно.

  • Точность для гибридных моделей: Поддерживает слои Gated DeltaNet для точной обработки контекста.

  • Обработка одного потока: Выполняет запросы как один поток токенов, воспроизводимый графиками CUDA.

  • Совместимый API vLLM/SGLang: Использует стандарт API `/v1/systemone`.

  • Предустановленные ядра: Оптимизированы для графических процессоров NVIDIA A40, A10, RTX 30, H100 и H200.

  • Основные модели: Поддерживает Qwen3.5 (0.8B, 2B, 4B, 9B, 27B) и Gemma 4 (E2B, E4B, 12B, 26B-A4B, 31B).

  • Мультимодальные входы: Обрабатывает текстовые, изображенческие и видео входы.

  • Квантование FP8: Запускает Qwen3.5 в FP8 на графических процессорах Ada, Hopper и Blackwell.

  • Кэш сессий: Сохраняет предыдущие состояния для агентов для возобновления (например, `--session-cache-gb 40`).

  • Процессы фронтенда: Поддерживает выполнение HTTP, рендеринг и токенизацию в отдельных процессах для многих клиентов.

  1. Установите Flide: Используйте pip для установки пакета Flide.

  2. Запустите сервер: Выполните `flide serve`, чтобы запустить сервер вывода, при необходимости указав `--host`.

  3. Настройте модели: Обслуживайте модели чата, такие как Qwen3.5 или Gemma 4 напрямую, или объедините адаптеры Open-Jev.

  4. Отправляйте запросы: Взаимодействуйте с сервером, используя API `/v1/systemone`, чтобы отправлять состояния и вопросы.

  5. Обрабатывайте мультимодальные входы: Включите пути к изображениям в состояние и отправьте медиа для моделей, поддерживающих изображения.

  • Ускоренные модели принятия решений
  • Мультимодальный вывод
  • Последовательная обработка пакетов
  • Управление состоянием агентов
  • Обслуживание высокопроизводительных LLM
  • Исследования и разработки

Отзывы о Flide

Загрузка...

Популярные ИИ-инструменты, похожие на Flide

vLLM

AI-приложения

vLLM — это высокопроизводительный и экономичный по памяти движок для вывода и обслуживания больших языковых моделей (LLM). Он обеспечивает более быструю развертку AI-моделей с…

MLOps и развёртывание моделей
Открыть инструмент

AI-приложения

Высокопроизводительный и экономичный по памяти движок для вывода и обслуживания больших языковых моделей (LLM). Он обеспечивает более быструю развертку AI-моделей с…vLLM — это высокопроизводительный и экономичный по памяти движок для вывода и обслуживания больших языковых моделей (LLM). Он обеспечивает более быструю развертку AI-моделей с…

MLOps и развёртывание моделей
Топ-250: AI-приложения

Поставщик высокоскоростного вывода ИИ, который обслуживает модели на специализированной инфраструктуре ASIC через совместимый с OpenAI API, предлагая низкое время до первого…

MLOps и развёртывание моделей
Открыть инструмент

Поставщик высокоскоростного вывода ИИ, который обслуживает модели на специализированной инфраструктуре ASIC через совместимый с OpenAI API, предлагая низкое время до первого…

MLOps и развёртывание моделей
Топ-250: AI-приложения

Inference.net

AI-приложения

Inference.net предоставляет инфраструктуру для команд, работающих с ИИ, для запуска, мониторинга и оптимизации ИИ-нагрузок. Он предлагает молниеносный вывод для моделей с открытым…

MLOps и развёртывание моделей

№78 — Тонкая настройка AI-моделей

Открыть инструмент

AI-приложения

Предоставляет инфраструктуру для команд, работающих с ИИ, для запуска, мониторинга и оптимизации ИИ-нагрузок. Он предлагает молниеносный вывод для моделей с открытым…Inference.net предоставляет инфраструктуру для команд, работающих с ИИ, для запуска, мониторинга и оптимизации ИИ-нагрузок. Он предлагает молниеносный вывод для моделей с открытым…

MLOps и развёртывание моделей
№78 — Тонкая настройка AI-моделей

Jev AI

AI-приложения

Jev AI — это инструмент интеллектуального принятия решений для команд разработчиков программного обеспечения, предлагающий быструю модель ИИ без очереди. Он преобразует реальные…

AI-инструменты для DevOps и облака
Открыть инструмент

AI-приложения

Инструмент интеллектуального принятия решений для команд разработчиков программного обеспечения, предлагающий быструю модель ИИ без очереди. Он преобразует реальные…Jev AI — это инструмент интеллектуального принятия решений для команд разработчиков программного обеспечения, предлагающий быструю модель ИИ без очереди. Он преобразует реальные…

AI-инструменты для DevOps и облака
Топ-250: AI-приложения

JevModel

AI-приложения

JevModel — это платформа, использующая модель Jev для структурированных решений ИИ, предлагающая выходы Choice, Score и Noul. Она позволяет пользователям тестировать текст или…

Платформы машинного обучения
Открыть инструмент

AI-приложения

Платформа, использующая модель Jev для структурированных решений ИИ, предлагающая выходы Choice, Score и Noul. Она позволяет пользователям тестировать текст или…JevModel — это платформа, использующая модель Jev для структурированных решений ИИ, предлагающая выходы Choice, Score и Noul. Она позволяет пользователям тестировать текст или…

Платформы машинного обучения
Топ-250: AI-приложения

Morph

AI-приложения

Платформа вывода, созданная для кодирующих агентов, предлагающая быстрые фронтовые модели и специализированные модели для поиска кода, применения правок, компактации контекста и…

MLOps и развёртывание моделей
Открыть инструмент

AI-приложения

Платформа вывода, созданная для кодирующих агентов, предлагающая быстрые фронтовые модели и специализированные модели для поиска кода, применения правок, компактации контекста и…

MLOps и развёртывание моделей
Топ-250: AI-приложения

vLLM

AI-репозитории на GitHub

vllm-project/vllm — это высокопроизводительный и экономичный по памяти движок вывода и обслуживания, разработанный для больших языковых моделей (LLM). Он оптимизирует…

MLOps и развёртывание моделей

№23 в AI-репозитории на GitHub

Открыть инструмент

AI-репозитории на GitHub

Высокопроизводительный и экономичный по памяти движок вывода и обслуживания, разработанный для больших языковых моделей (LLM). Он оптимизирует…vllm-project/vllm — это высокопроизводительный и экономичный по памяти движок вывода и обслуживания, разработанный для больших языковых моделей (LLM). Он оптимизирует…

РекомендованоMLOps и развёртывание моделей
№23 в AI-репозитории на GitHub

trnrt

AI-репозитории на GitHub

trnrt — это движок вывода LLM с открытым исходным кодом, разработанный для AWS Trainium, предлагающий мегакернелы NKI и поддерживающий контекст в 1 миллион токенов. Разработанный…

MLOps и развёртывание моделей

№160 в MLOps и развёртывание моделей

Открыть инструмент

AI-репозитории на GitHub

Движок вывода LLM с открытым исходным кодом, разработанный для AWS Trainium, предлагающий мегакернелы NKI и поддерживающий контекст в 1 миллион токенов. Разработанный…trnrt — это движок вывода LLM с открытым исходным кодом, разработанный для AWS Trainium, предлагающий мегакернелы NKI и поддерживающий контекст в 1 миллион токенов. Разработанный…

MLOps и развёртывание моделей
№160 в MLOps и развёртывание моделей
1 из 8