Описание
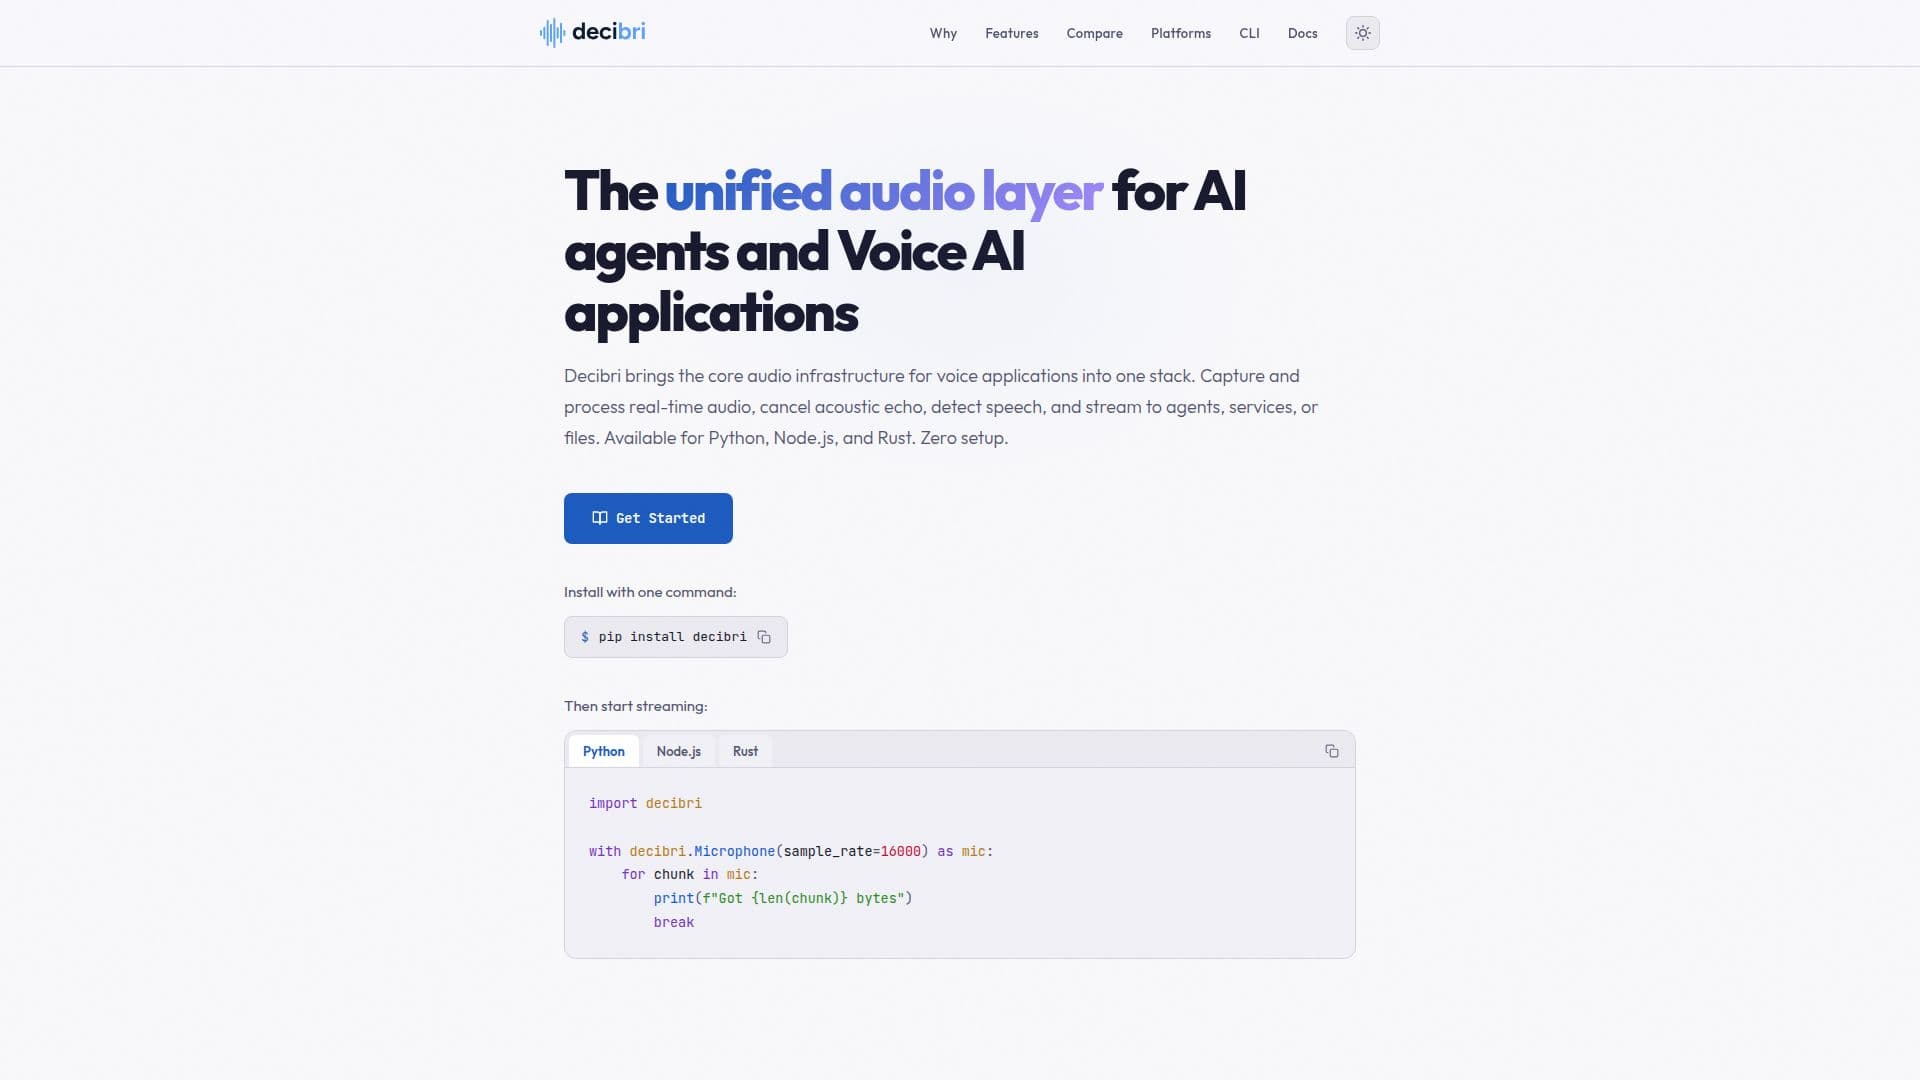
Decibri служит унифицированным аудиослойом, специально разработанным для AI-агентов и приложений Voice AI. Он предоставляет основные возможности аудио в реальном времени, включая захват звука с микрофона, вывод на динамики и обнаружение активности голоса (VAD). Платформа поддерживает несколько языков программирования, а именно Python, Node.js и Rust, что делает ее универсальной для различных сред разработки.
Читать далее
Одним из ключевых преимуществ Decibri является простота установки и кроссплатформенная совместимость. Он предлагает предварительно собранные бинарные файлы для Python и Node.js на всех поддерживаемых платформах (Windows, macOS, Linux), устраняя необходимость в компиляции или сложных инструментах сборки. Этот подход «нулевой настройки» обеспечивает быструю интеграцию функций аудио в реальном времени в проекты разработчиков. Ядро на Rust, которое управляет пакетами для Python, Node.js и Rust, компилируется в нативный код, обеспечивая предсказуемое низкое время задержки аудио непосредственно из аудиослоя операционной системы.
Decibri захватывает звук непосредственно из аудиослоя ОС, предоставляя по умолчанию аудиочасти по 100 мс в формате 16-битного знакового целого PCM, который является стандартом, ожидаемым большинством движков речи и пробуждения, таких как Vosk, sherpa-onnx и whisper.cpp. Также доступен формат 32-битного числа с плавающей запятой. Он поддерживает идиомы потоков для каждого языка, позволяя разработчикам эффективно передавать аудио в файлы, WebSockets или голосовые агенты. Платформа также включает в себя встроенную модель Silero VAD v6.2 для точного обнаружения речи в шумной среде, работающую локально через ONNX Runtime без необходимости в облачных API.
Помимо базового захвата и воспроизведения, Decibri предлагает расширенные функции обработки аудио через свой Audio Capture Engine (ACE), включая удаление постоянной составляющей, шумоподавление, высокочастотную фильтрацию, автоматическое управление уровнем громкости и ограничение. Он также предоставляет Acoustic Echo Cancellation (AEC) для удаления звука динамиков из захвата микрофона. Для оффлайн-обработки Audio File Processor (AFP) позволяет обрабатывать записанные или находящиеся в памяти образцы. Decibri интегрируется с многочисленными поставщиками распознавания речи (STT), как облачными (AssemblyAI, AWS Transcribe, Azure AI Speech, Deepgram, Google Cloud Speech-to-Text, Mistral Voxtral, OpenAI Realtime API), так и локальными (Sherpa-ONNX, Whisper.cpp), а также с локальными системами синтеза речи (TTS) с моделью Kokoro и обнаружением ключевых слов (KWS) с Sherpa-ONNX.
Decibri создан для систем реального времени, обеспечивая низкое время задержки аудио I/O без внешних аудиоустройств или специфической обработки для платформ. Он поддерживает асинхронные операции в Python с помощью `asyncio` и работает как в Node.js, так и в браузерных средах из одного пакета. Инструмент `decibri-cli` предоставляет возможности командной строки для захвата аудио, воспроизведения и перечисления устройств, что дополнительно расширяет его полезность для сценариев и CI/CD пайплайнов.
- КатегорияКонструкторы AI-агентов
- Модель ценообразованияБесплатно
- РазвёртываниеЛокальный
- ПлатформыWindows, macOS, Linux, Browser
Основные функции Decibri
Захват звука с микрофона в реальном времени
Вывод и воспроизведение звука
Обнаружение активности голоса (VAD)
Кроссплатформенная поддержка (Python, Node.js, Rust)
Предварительно собранные бинарные файлы для нулевой настройки
Прямой доступ к аудиослою ОС
16-битный PCM и 32-битный формат с плавающей запятой
Поддержка асинхронного API (asyncio для Python)
Совместимость с браузерами (пакет для Node.js)
Двигатель захвата аудио (удаление постоянной составляющей, шумоподавление, AGC)
Устранение акустической эха (AEC)
Локальное обнаружение голоса с помощью ML (Silero VAD)
Интеграция с облачными сервисами STT
Интеграция с локальными моделями STT/TTS/KWS
Интерфейс командной строки (decibri-cli)
Как использовать Decibri?
Установите Decibri: Используйте `pip install decibri` для Python или `npm install decibri` для Node.js, чтобы получить предварительно собранные бинарные файлы.
Откройте микрофон: Используйте `decibri.Microphone.open()` в Python или `new Microphone()` в Node.js, чтобы начать захват звука.
Передайте аудио: Читайте аудиочасти с помощью итераторов Python, читаемых потоков Node.js или каналов Rust.
Обработайте аудио: Примените встроенные условия, такие как удаление постоянной составляющей, шумоподавление или устранение акустического эха.
Обнаружьте речь: Включите встроенную модель Silero VAD для локального обнаружения активности голоса.
Интегрируйтесь с AI-сервисами: Передавайте необработанное PCM-аудио в сервисы распознавания речи, голосовые агенты или другие AI-модели.
Воспроизведите аудио: Используйте API динамиков Decibri для воспроизведения звука через системный динамик.
Запишите в файл: Используйте `record_to_file()` для простого аудиозаписи или полного контроля потоковой передачи для сложных случаев использования.
Варианты использования Decibri
- AI-агенты голосового взаимодействия в реальном времени
- Интеграция распознавания речи
- Обнаружение активности голоса
- Запись аудио для ASR
- Кроссплатформенные аудиоприложения
- Серверные голосовые бэкенды
- Обнаружение ключевых слов
- Полудуплексная аудиосвязь