Описание
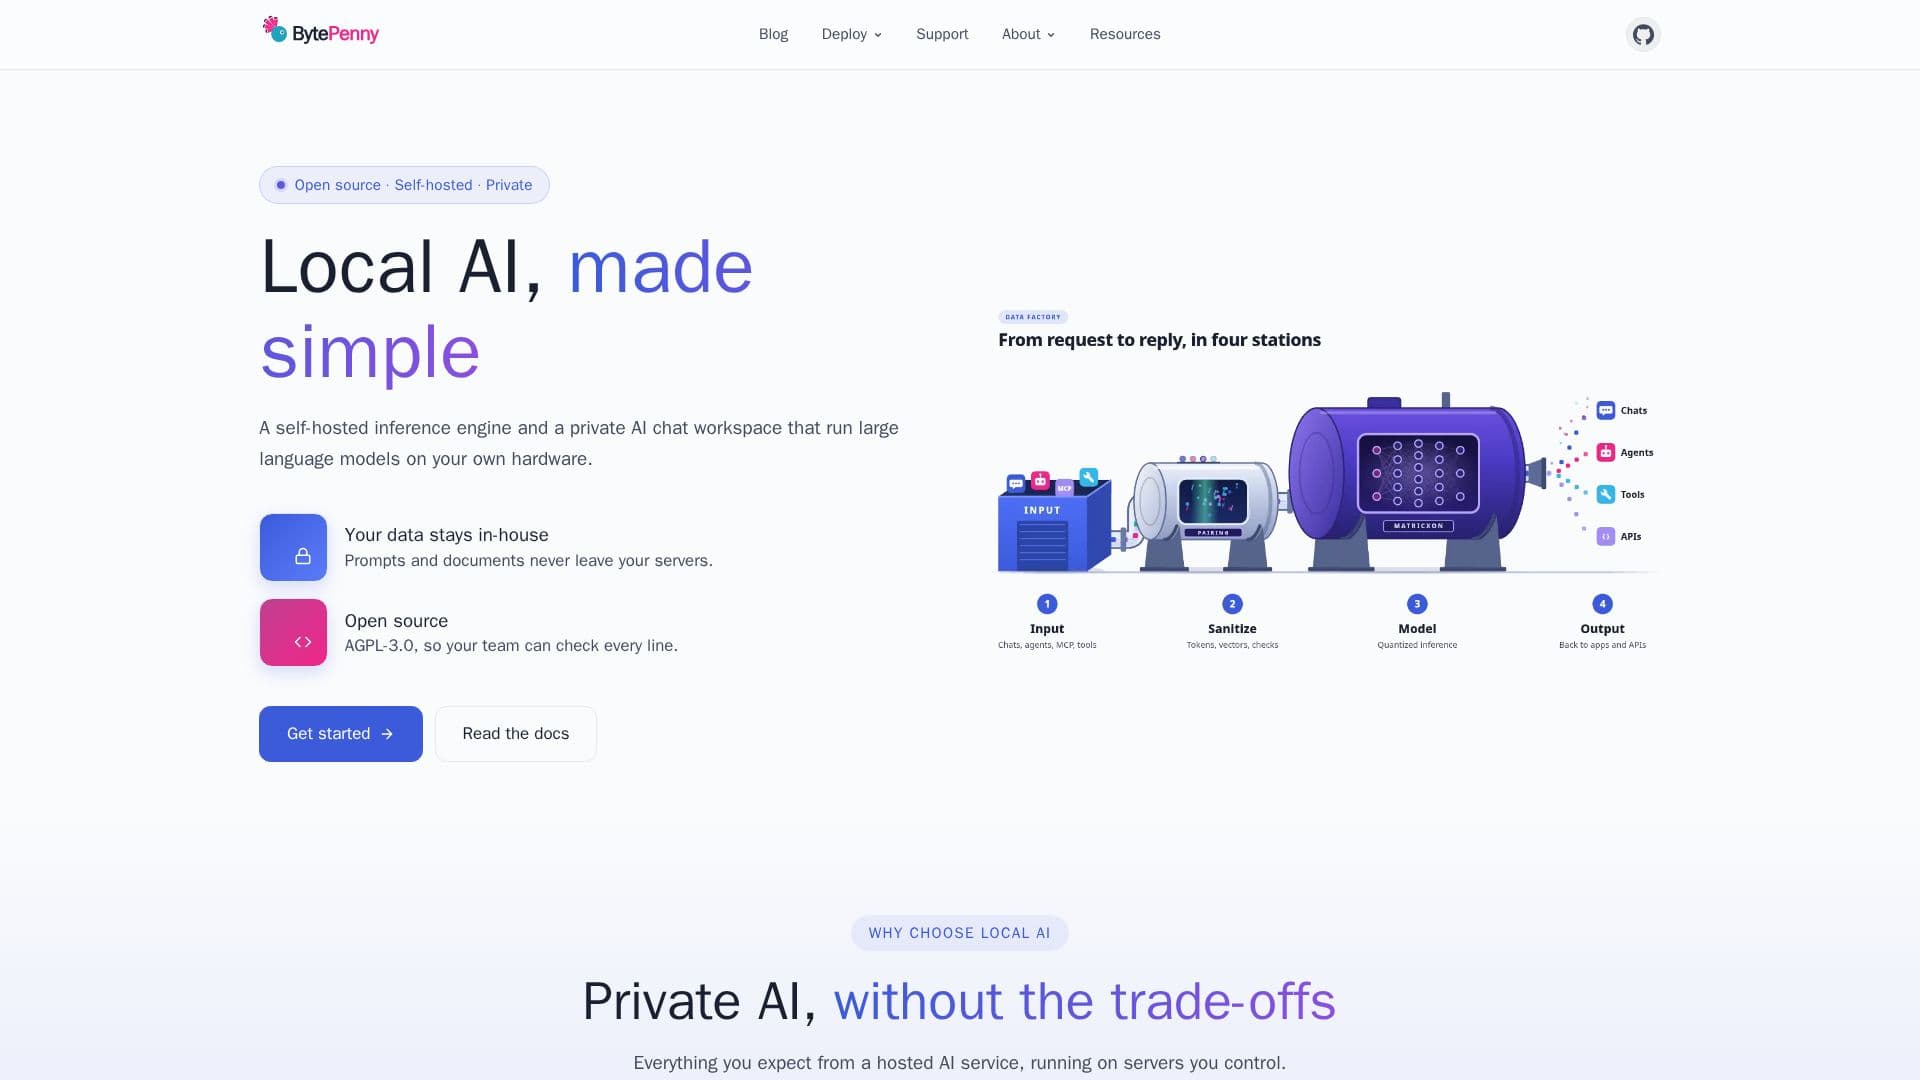
BytePenny предоставляет комплексный набор открытых, самостоятельно размещаемых AI-инструментов, разработанных для обеспечения конфиденциальности и контроля. Основное предложение включает Matricxon, открытый GGUF движок вывода, и pAIring, частное рабочее пространство AI-чата, адаптированное для команд. Эти продукты позволяют организациям запускать большие языковые модели непосредственно на своем оборудовании, гарантируя, что запросы, документы и данные чата никогда не покинут их серверы.
Читать далее
Платформа акцентирует внимание на конфиденциальности данных, полностью работая в оффлайне, чтобы сохранить всю чувствительную информацию внутри компании. Она поддерживает различные GGUF модели из таких источников, как Hugging Face, llama.cpp или движки Matricxon, и может интегрироваться с серверами инструментов MCP. BytePenny построен на философии открытого кода, используя лицензию AGPL-3.0, что позволяет командам проверять и изменять каждую строку кода, способствуя прозрачности и доверию.
Matricxon, движок вывода, представляет собой легковесный, читаемый LLM-исполнитель, написанный на Python и PyTorch, с родными C-ядрами для ускоренной работы. Он поддерживает GGUF модели для задач, таких как чат, генерация текста, встраивания, повторная сортировка, модели «язык-изображение» и прогнозирование временных рядов, предоставляя их через HTTP API. Он эффективно работает на ЦП и предлагает BETA поддержку для графических процессоров NVIDIA, с планами расширения на графические процессоры AMD и Apple Silicon. Matricxon также поддерживает кластерный режим для совместно используемых моделей и кэшей чата на нескольких узлах, управляемых из интерфейса pAIring.
pAIring, частное рабочее пространство AI-чата, предназначено для командного сотрудничества, предлагая такие функции, как доступ на основе ролей, общие каналы и интегрированная база знаний. Оно предоставляет зашифрованные кэши чата и гарантирует, что запросы никогда не используются для обучения модели. Система масштабируема, позволяя пользователям начинать с одного сервера и расширяться, добавляя узлы с балансировкой нагрузки и возможностями резервирования. Для сценариев, требующих большей мощности, pAIring может подключаться к различным облачным провайдерам, таким как Bedrock, Vertex AI, Azure OpenAI, Gemini, Groq и другим, предлагая гибкость для смешивания локальных и облачных движков.
BytePenny устраняет оплату за токены, позволяя организациям использовать существующее оборудование и поддерживать фиксированные затраты по мере роста использования. Весь стек разработан как открытый, от кода AGPL-3.0 до моделей с открытыми весами, что делает его идеальным для частных и закрытых сетей. Безопасность является первоочередной задачей, с такими функциями, как пароли с хешированием bcrypt, зашифрованные хранимые секреты, зашифрованные кэши чата AES-256-GCM и проверки ролей на стороне сервера для действий администраторов. Как Matricxon, так и pAIring получили значок «прохода» лучших практик OpenSSF, демонстрируя приверженность безопасным методам разработки.
- КатегорияMLOps и развёртывание моделей
- Модель ценообразованияOpen Source (AGPL-3.0), No Per-Token Bills
- РазвёртываниеSelf-Hosted, On-Premise, Cloud (Hybrid)
- ПлатформыWindows, Linux
Основные функции BytePenny
Самостоятельно размещаемый AI движок вывода (Matricxon)
Частное рабочее пространство AI-чата для команд (pAIring)
Запуск больших языковых моделей на вашем собственном оборудовании
Данные остаются внутри компании; запросы и документы никогда не покидают серверы
Открытый код с лицензией AGPL-3.0
Полностью работает в оффлайне
Зашифрованные кэши чата с AES-256-GCM
Доступ на основе ролей для команд
Запросы никогда не используются для обучения модели
Поддерживает GGUF модели от Hugging Face, llama.cpp, Matricxon
Квантованные ядра для поддержки ЦП и графических процессоров NVIDIA
Без оплаты за токены; фиксированные затраты при росте использования
Масштабируемое развертывание: один узел, общий кластер или отдельные серверы
Подключается к более чем 12 облачным провайдерам (Bedrock, Vertex AI, Azure OpenAI, Gemini, Groq и др.)
Написан с нуля на Python для читаемости и настраиваемости
Как использовать BytePenny?
Разверните BytePenny: Установите Matricxon и pAIring на своих серверах или облачной инфраструктуре.
Настройте движок вывода: Настройте Matricxon как локальный движок вывода или подключите pAIring к предпочитаемому облачному провайдеру.
Добавьте модели: Интегрируйте GGUF модели от Hugging Face или других источников, или используйте модели, размещенные в облаке, через коннекторы.
Управляйте пользователями и командами: Настройте доступ на основе ролей, создайте общие каналы и установите базу знаний в pAIring.
Начните общение: Начните частные AI-беседы и используйте базу знаний для командного сотрудничества.
Мониторьте и масштабируйте: Наблюдайте за состоянием системы, управляйте узлами кластера и расширяйте оборудование по мере роста использования без дополнительных затрат на токены.
Варианты использования BytePenny
- Частный командный чат
- Локальный вывод LLM
- Безопасный анализ документов
- Контроль затрат на AI-операции
- Оффлайн AI-рабочие процессы
- Развертывание пользовательских моделей
- Масштабируемая AI-инфраструктура
- Разработка AI с открытым исходным кодом