Descrição
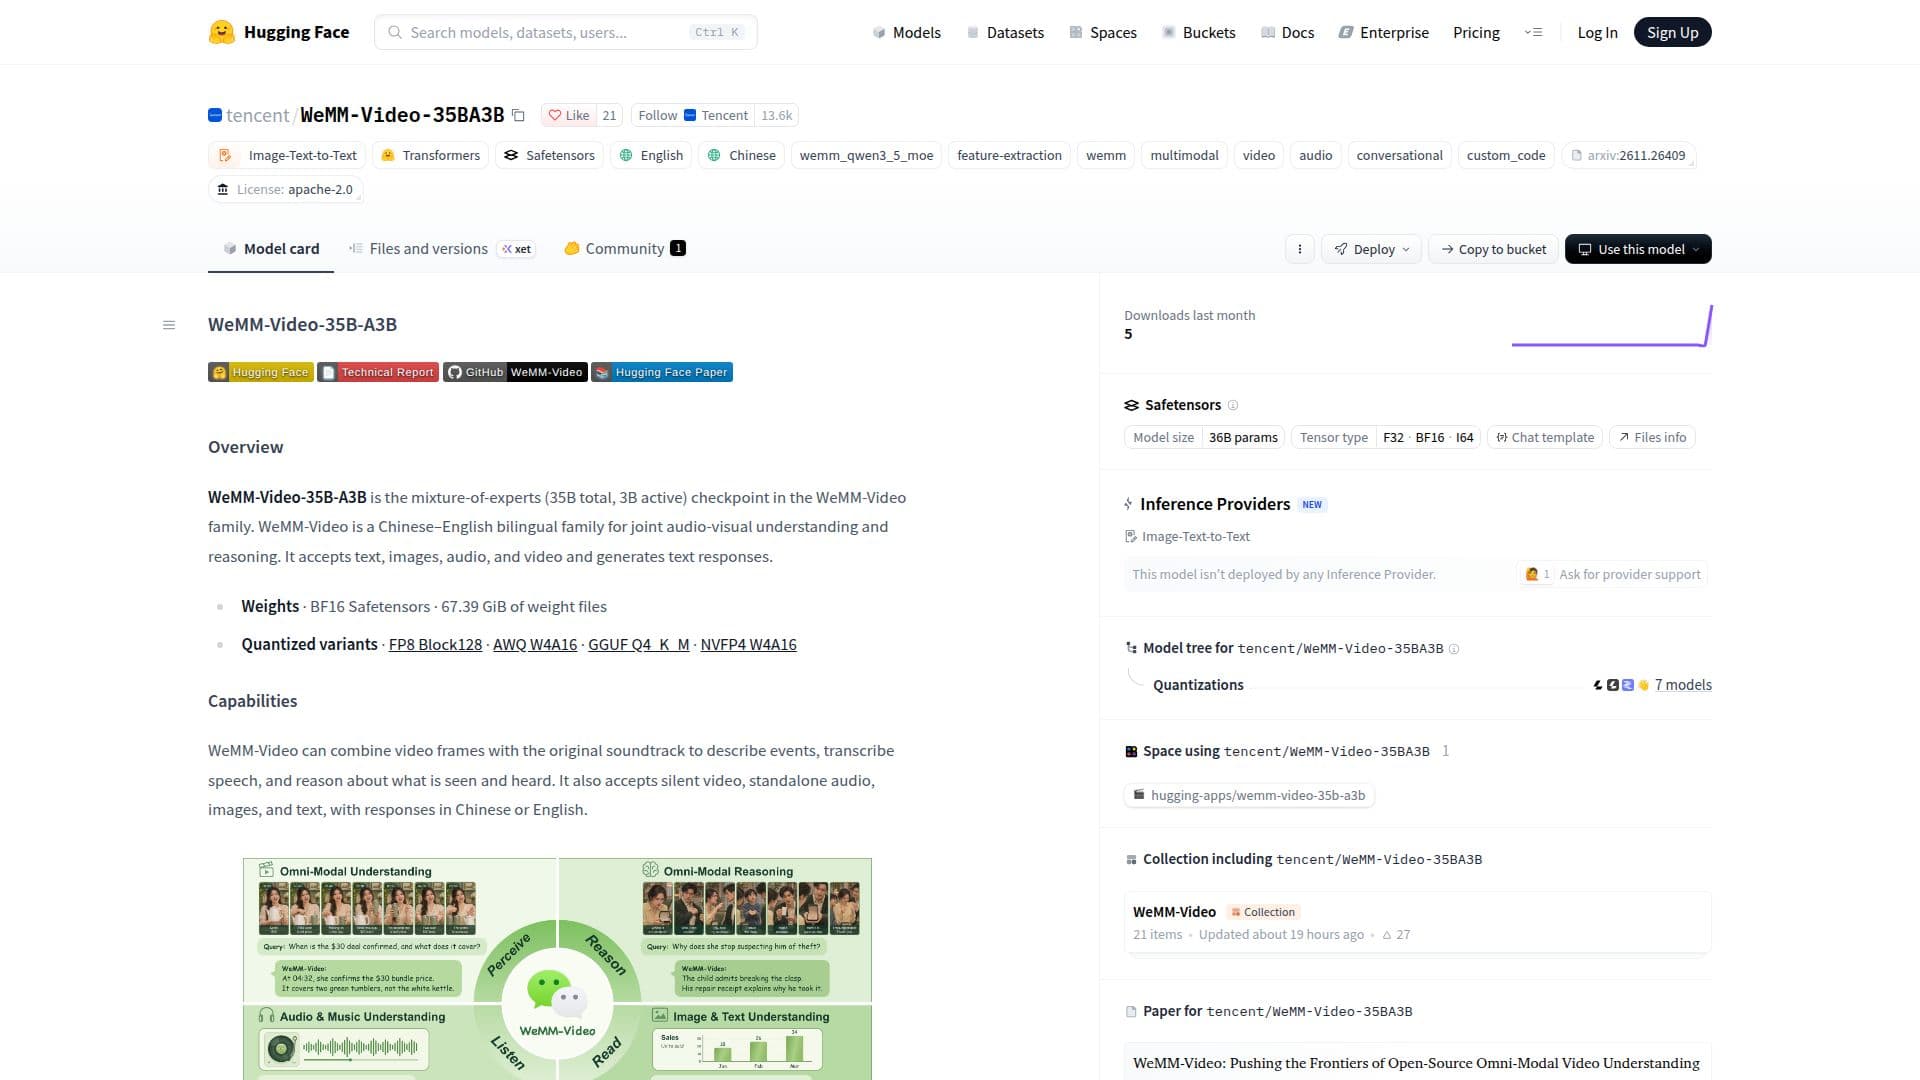
WeMM-Video-35B-A3B é um sofisticado modelo de mistura de especialistas, parte da ampla família WeMM-Video, desenvolvido para compreensão e raciocínio áudio-visual abrangentes. Com 35 bilhões de parâmetros totais e 3 bilhões de parâmetros ativos, este modelo é especificamente projetado para processar e interpretar entradas multimodais, incluindo texto, imagens, áudio e vídeo, gerando respostas textuais coerentes em chinês ou inglês.
Ler mais
As principais capacidades do modelo incluem a habilidade de combinar quadros de vídeo com suas trilhas sonoras originais para descrever eventos, transcrever fala com precisão e realizar tarefas de raciocínio com base em informações visuais e auditivas. Ele também é versátil o suficiente para lidar com vídeo silencioso, áudio independente, imagens e entradas de texto de forma independente. Isso o torna adequado para uma ampla gama de aplicações que exigem uma compreensão contextual profunda em diferentes tipos de mídia.
Arquitetonicamente, WeMM-Video-35B-A3B emprega codificadores de visão e áudio para converter entradas de mídia em tokens, que são então processados por um modelo de linguagem juntamente com texto. Os quadros de vídeo são enriquecidos com timestamps para manter o contexto temporal. A família do modelo passou por um extenso pré-treinamento em aproximadamente 1,2 trilhões de tokens multimodais, seguido por técnicas avançadas de pós-treinamento, como OPD de múltiplos professores, MrDPO anti-repetição e aprendizado por reforço especializado para melhorar seu desempenho e robustez.
A implantação e integração são facilitadas através de várias opções de serviço. Os usuários podem configurar o ambiente Transformers e executar exemplos diretamente do repositório WeMM-Video. O modelo suporta variantes quantizadas como FP8 Block128, AWQ W4A16, GGUF Q4_K_M e NVFP4 W4A16. Para o serviço, é compatível com versões corrigidas do vLLM (0.18.0 e 0.31.0) e SGLang (0.5.16 ou 0.5.19), permitindo uma inferência eficiente, incluindo paralelismo de tensor em várias GPUs. O modelo também oferece diferentes modos de chat, incluindo um modo de instrução padrão e um 'Modo de Pensamento' para respostas de raciocínio.
WeMM-Video-35B-A3B demonstrou um desempenho forte, estabelecendo um novo estado da arte de código aberto. Ele mostrou superar modelos proprietários como Qwen3.5-Omni-Flash e Seed2.0-Mini-0428, reduzindo significativamente a diferença de desempenho com modelos avançados como Gemini-3.0-Flash. O modelo é lançado sob a Licença Apache 2.0, promovendo acesso aberto e colaboração dentro da comunidade de IA.
- CategoriaModelos de IA e LLMs
- Modelo de preçosCódigo aberto
- ImplantaçãoNuvem
- PlataformasWeb
Destaques de WeMM-Video-35B-A3B
Processamento bilíngue chinês-inglês
Compreensão e raciocínio áudio-visual conjuntos
Aceita entradas de texto, imagens, áudio e vídeo
Gera respostas em texto
Descreve eventos a partir de quadros de vídeo e trilhas sonoras
Transcreve fala a partir de áudio
Raciocina sobre informações visuais e auditivas
Suporta vídeo silencioso e processamento de áudio independente
Arquitetura de mistura de especialistas (35B totais, 3B parâmetros ativos)
Pré-treinado em 1,2 trilhões de tokens multimodais
Pós-treinado com OPD de múltiplos professores e MrDPO
Aprendizado por reforço especializado para desempenho aprimorado
Suporta várias variantes quantizadas (FP8, AWQ, GGUF, NVFP4)
Compatível com vLLM e SGLang corrigidos para serviço
Oferece modos de chat Instruct e Thinking
Primeiros passos com WeMM-Video-35B-A3B
Configurar Ambiente: Instale o ambiente Transformers e as dependências necessárias.
Carregar Modelo: Carregue o modelo WeMM-Video-35B-A3B e o processador do Hugging Face Hub.
Preparar Entradas: Forneça entradas de mídia, como arquivos de vídeo MP4, áudio independente, imagens ou texto.
Processar Mídia: Use o script para processar quadros de vídeo sozinhos ou com a trilha sonora original.
Gerar Respostas: Envie solicitações ao modelo, especificando o modo de chat (Instruct ou Thinking) para geração de texto.
Servir Modelo (Opcional): Instale o patch de tempo de execução WeMM e use vLLM ou SGLang corrigidos para serviço de API.
Enviar Solicitações de API: Use o cliente de solicitação incluído para enviar mídia inline ao endpoint de chat compatível com OpenAI.
Casos de uso de WeMM-Video-35B-A3B
- Análise de Conteúdo de Vídeo
- Transcrição de Fala
- Raciocínio Multimodal
- Processamento de Conteúdo Bilíngue
- Descrição de Eventos Áudio-Visuais
- Desenvolvimento de Modelos de IA
- Pesquisa e Experimentação