Descrição
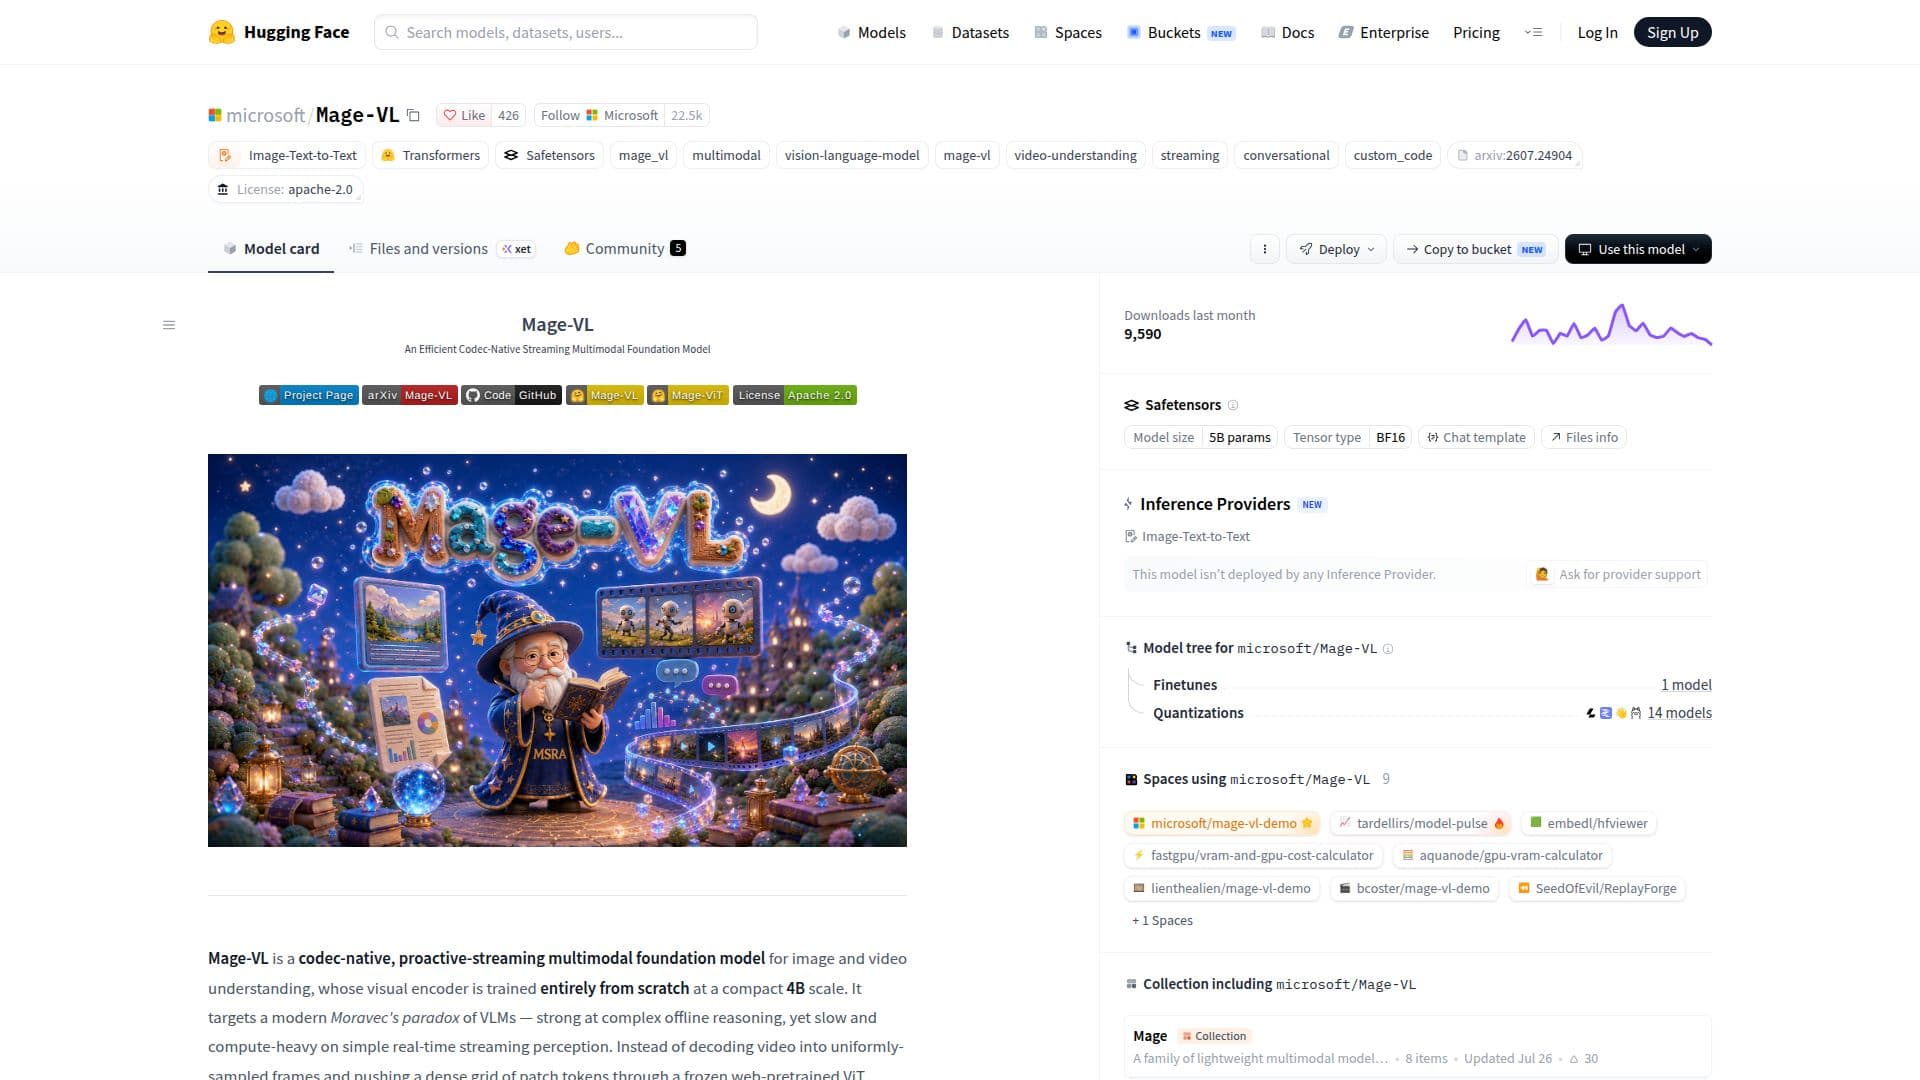
Mage-VL é um modelo de fundação multimodal inovador desenvolvido para enfrentar os desafios da compreensão de imagens e vídeos. Ele é projetado como um modelo nativo de codec e de streaming proativo que processa dados visuais de forma eficiente. O codificador visual do modelo, Mage-ViT, é treinado do zero e opera em uma escala compacta de 4B. Este codificador é único em sua capacidade de alocar tokens com base na importância espaço-temporal derivada do codec, permitindo processar vídeos até oito vezes mais longos sob o mesmo orçamento computacional.
Ler mais
A arquitetura do Mage-VL inclui um decodificador causal Qwen3-4B, que é o único componente pré-treinado. Este decodificador trabalha em conjunto com o Mage-ViT para lidar com fluxos de tokens de comprimento variável, suportando uma interface unificada para imagens e vídeos de diferentes comprimentos. O design de processo duplo do modelo incorpora um portão de cognição que permite o streaming proativo, monitorando o conteúdo e ativando o modelo completo de linguagem visual apenas quando necessário.
A abordagem nativa de codec do modelo reduz significativamente o consumo de tokens visuais em mais de 75%, resultando em um aumento de 3,5× na inferência em tempo real em comparação com métodos tradicionais. Essa eficiência é alcançada sem comprometer a precisão, tornando o Mage-VL uma ferramenta poderosa para análise e compreensão de vídeo em tempo real.
O Mage-VL é particularmente forte na compreensão de vídeo e inteligência espacial, superando modelos comparáveis em vários benchmarks. Suas capacidades de streaming proativo são demonstradas por seu desempenho em tarefas de streaming do SoccerNet, onde oferece comentários com baixa latência e baseados em eventos.
No geral, o Mage-VL representa um avanço significativo em modelos de IA multimodal, oferecendo uma solução eficiente em dados para tarefas visuais complexas. Sua natureza de código aberto e capacidades abrangentes o tornam um recurso valioso para desenvolvedores e pesquisadores na área de inteligência artificial.
- CategoriaModelos de IA e LLMs
- Modelo de preçosCódigo aberto
- ImplantaçãoNuvem
- PlataformasWeb
Destaques de Mage-VL
Codificador visual nativo de codec
Portão de streaming proativo
Decodificador causal Qwen3-4B
Aumento de velocidade de inferência de 3,5×
Tokenizador eficiente em dados
Pré-treinamento de resolução variável
Modelo unificado para imagens e vídeos
Comentários baseados em eventos
Primeiros passos com Mage-VL
Acesse a página do modelo: Visite o repositório do Hugging Face
Autentique-se: Use suas credenciais da conta do Hugging Face
Configure: Defina os parâmetros e o ambiente do modelo
Envie prompts: Insira seus dados de imagem ou vídeo para processamento
Ajuste: Ajuste as configurações do modelo para tarefas específicas
Casos de uso de Mage-VL
- Análise de Vídeo em Tempo Real
- Inteligência Espacial
- Comentários Baseados em Eventos
- Compreensão de Imagens
- Streaming Proativo