Descrição
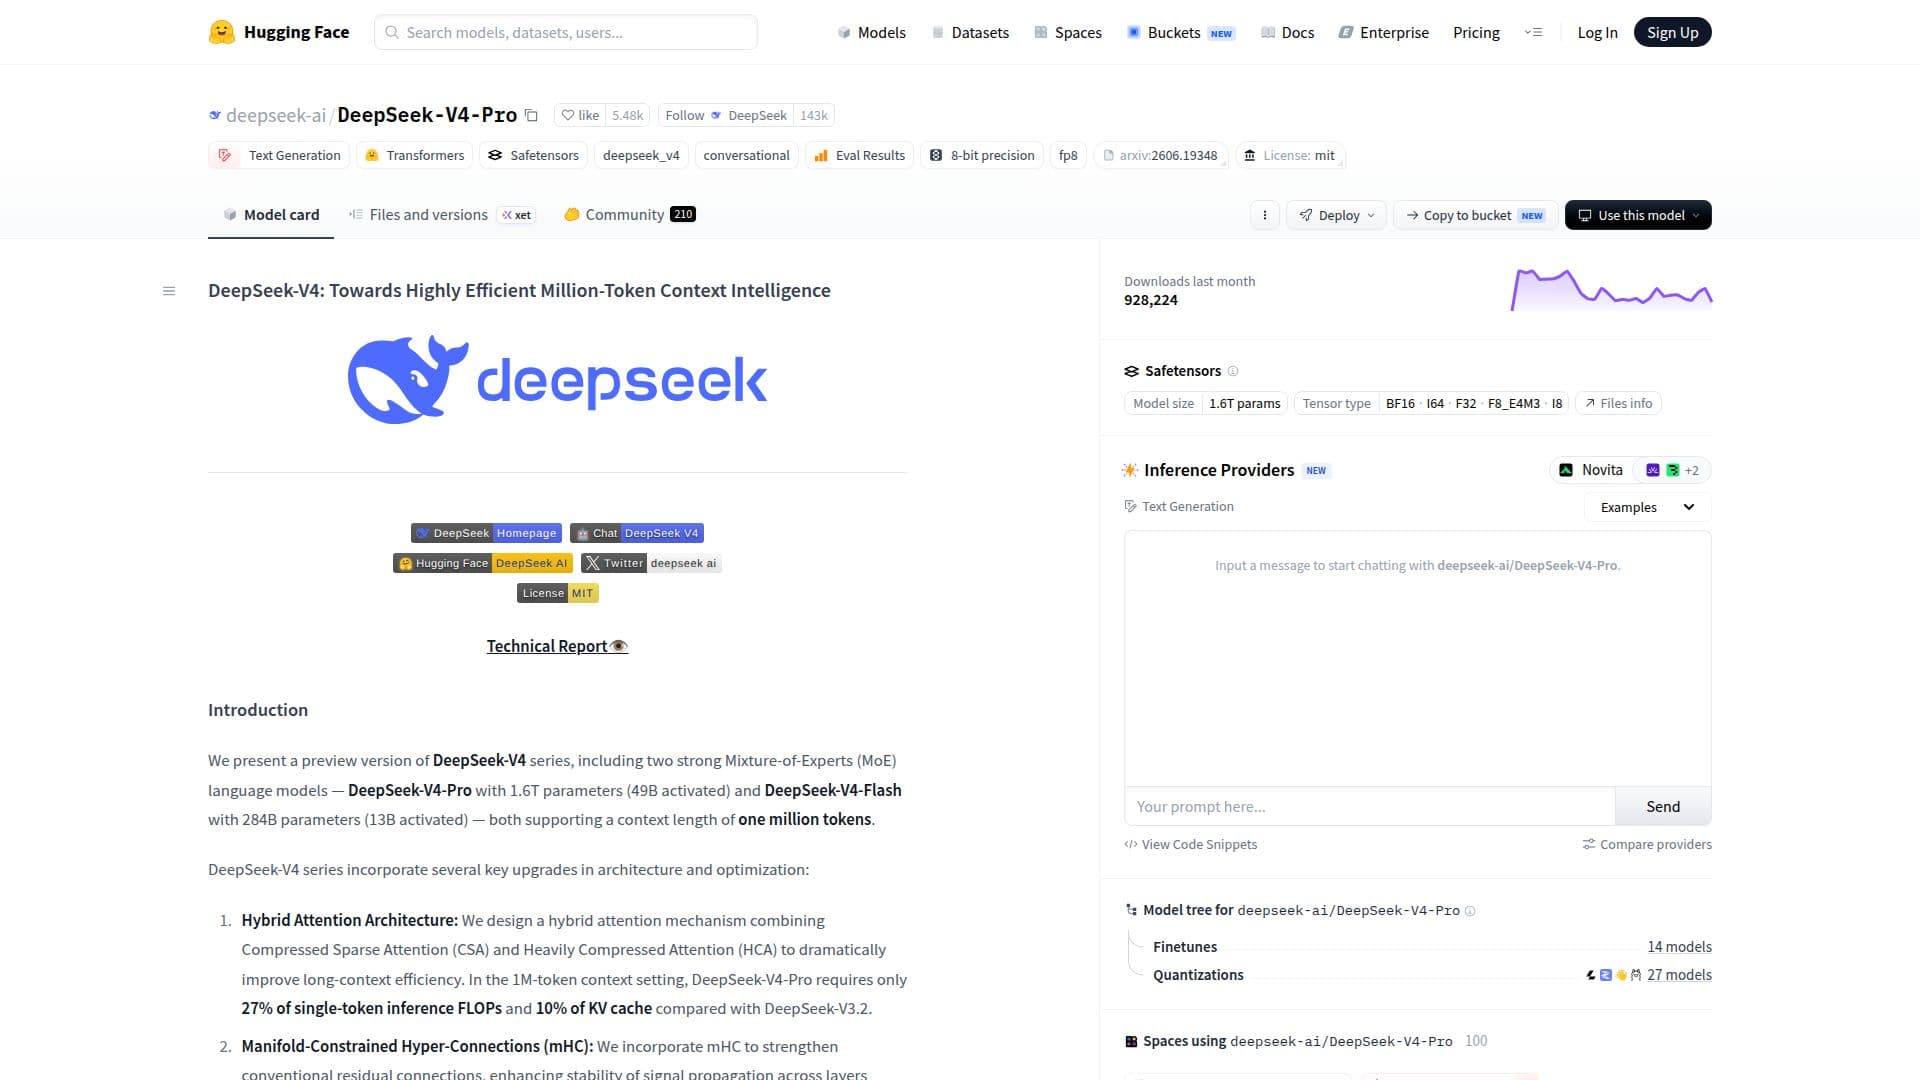
DeepSeek-V4-Pro faz parte da série DeepSeek-V4, que visa avançar e democratizar a inteligência artificial por meio de código aberto e ciência aberta. Este modelo incorpora dois fortes modelos de linguagem Mixture-of-Experts (MoE), com o DeepSeek-V4-Pro ostentando 1,6 trilhões de parâmetros e suportando um comprimento de contexto de um milhão de tokens.
A arquitetura do DeepSeek-V4-Pro inclui várias atualizações importantes, como um mecanismo de atenção híbrido que combina Compressed Sparse Attention (CSA) e Heavily Compressed Attention (HCA). Este design melhora drasticamente a eficiência de longo contexto, exigindo apenas 27% dos FLOPs de inferência de token único e 10% do cache KV em comparação com seu predecessor, DeepSeek-V3.2. Além disso, o modelo emprega Manifold-Constrained Hyper-Connections (mHC) para melhorar a estabilidade na propagação de sinais entre camadas, mantendo a expressividade do modelo.
Para garantir uma convergência mais rápida e maior estabilidade no treinamento, o otimizador Muon é utilizado. O modelo é pré-treinado em um conjunto de dados diversificado de mais de 32 trilhões de tokens, seguido por um pipeline abrangente de pós-treinamento que inclui o cultivo independente de especialistas específicos de domínio e a consolidação unificada do modelo por meio de destilação em política.
DeepSeek-V4-Pro-Max, o modo de esforço máximo de raciocínio do DeepSeek-V4-Pro, melhora significativamente as capacidades de conhecimento dos modelos de código aberto. Ele alcança desempenho de alto nível em benchmarks de codificação e efetivamente fecha a lacuna com os principais modelos de código fechado em tarefas de raciocínio e agentes. As capacidades do modelo o tornam adequado para uma ampla gama de aplicações, incluindo resolução de problemas complexos e tarefas de planejamento, tornando-o uma ferramenta valiosa para desenvolvedores e pesquisadores na área de IA.
Destaques de DeepSeek-V4-Pro
Tipo de Modelo: Mixture-of-Experts
Total de Parâmetros: 1.6T
Parâmetros Ativados: 49B
Comprimento do Contexto: 1M tokens
Arquitetura de Atenção Híbrida: Sim
Otimizador Muon: Sim
Pré-treinado em: 32T tokens
Licença: MIT
Primeiros passos com DeepSeek-V4-Pro
Acessar modelo: Visite a página do Hugging Face para DeepSeek-V4-Pro.
Autenticar: Crie uma conta se necessário.
Configurar ambiente: Certifique-se de ter as bibliotecas e dependências necessárias.
Integrar via API: Use a documentação da API fornecida para se conectar ao modelo.
Otimizar: Ajuste os parâmetros de amostragem para melhor desempenho.
Casos de uso de DeepSeek-V4-Pro
- Resolução de Problemas Complexos
- Benchmarks de Codificação
- Aplicações de Pesquisa
- Processamento de Linguagem Natural
- Tarefas Agentes