Descrição
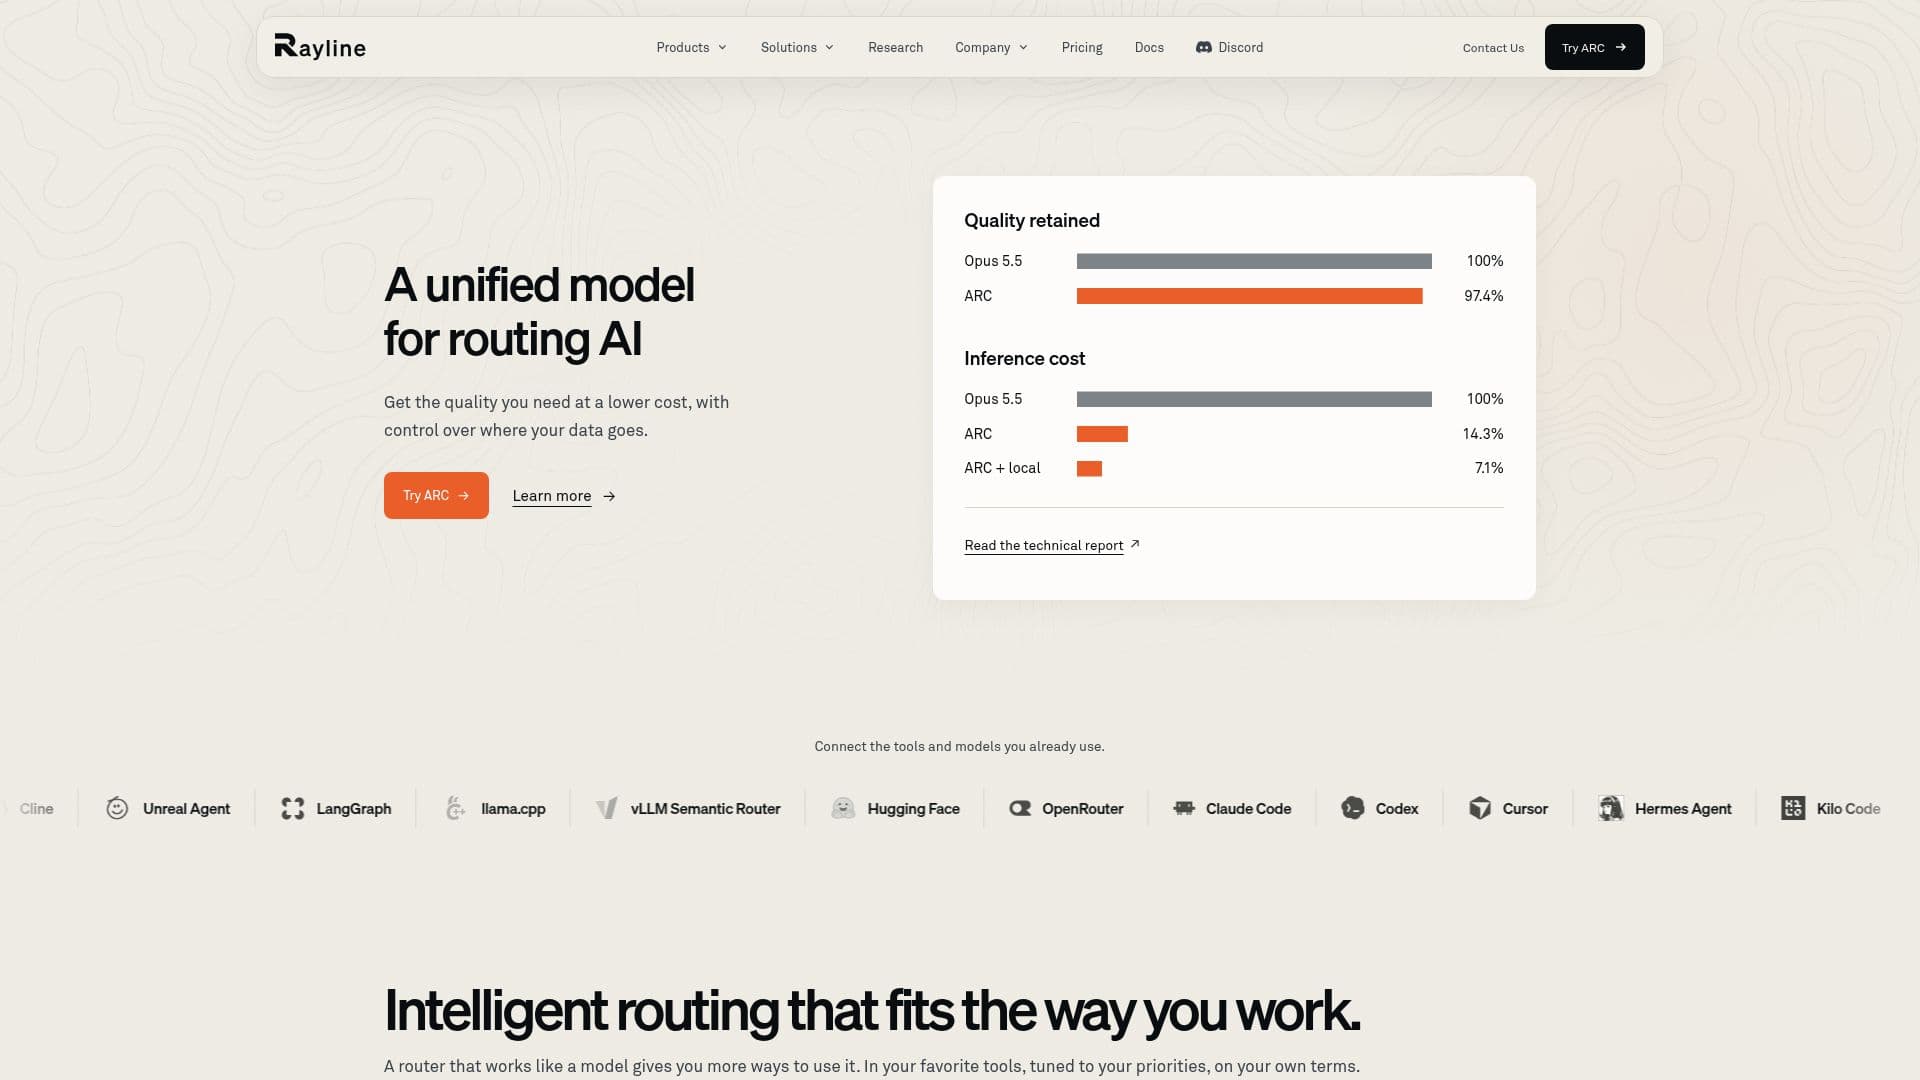
Rayline fornece um modelo unificado para roteamento de IA, projetado para oferecer qualidade ideal a um custo mais baixo, garantindo que os usuários mantenham controle sobre seus dados. No seu núcleo está o ARC, o sistema de roteamento adaptativo da Rayline que escolhe inteligentemente o modelo de IA e o nível de raciocínio mais adequados para cada turno de conversa, com base em fatores como contexto da conversa, qualidade desejada e custo.
Ler mais
A plataforma se integra perfeitamente a uma ampla gama de ferramentas e modelos existentes, incluindo llama.cpp, vLLM, Semantic Router, Hugging Face, OpenRouter, Claude, OpenAI, DeepSeek, GLM, Kimi, Qwen, Gemini, Gemma e Mistral. Essa flexibilidade permite que as equipes continuem trabalhando em seus ambientes familiares enquanto se beneficiam das capacidades de roteamento inteligente da Rayline. Os usuários podem moldar as decisões do ARC em torno de suas prioridades específicas de carga de trabalho e custos reais dos modelos, incluindo quaisquer descontos negociados.
Rayline oferece flexibilidade de implantação, permitindo que os usuários deixem a Rayline executar a inferência ou levem a recomendação do modelo para seu próprio gateway, provedor de nuvem ou modelos locais. A API Decisions fornece respostas estruturadas, escolhas, probabilidades e pontuações a partir de qualquer entrada, treinada especificamente para roteamento de modelos, mas útil para aplicações mais amplas. Para geração hospedada, os usuários podem começar com ARC Swift ou Sage, ou utilizar a API Routes para inferência autogerida.
Para desenvolvedores, a Rayline oferece Workshop Cloud e Workshop Desktop, permitindo a construção de software pronto para produção com agentes adaptativos. O Rayline CLI conecta modelos locais e serviços de nuvem, integrando-os a ferramentas existentes. A plataforma também apresenta economias significativas de custo, com potenciais economias anuais de até $108.000 ao alcançar até 90% de redução nos custos de inferência. A abordagem da Rayline é respaldada por extensa pesquisa, detalhada no relatório técnico do ARC, que explica a metodologia e os resultados de benchmark por trás do equilíbrio entre qualidade e custo.
Rayline oferece vários modelos de precificação, incluindo presets de taxa fixa como ARC Swift para trabalho eficiente com API no dia a dia e ARC Sage para tarefas de agentes focadas na qualidade. O ARC Dynamic fornece seleção de modelo adaptativa com precificação de passagem com base no modelo selecionado, incorrendo em 0% de comissão. A API Routes permite que os usuários paguem pela seleção de modelo e nível de raciocínio, gerenciando seus próprios custos de inferência. A API Decisions é precificada com base em tokens de entrada para respostas estruturadas. O Rayline CLI é de código aberto, sem taxa de software, com inferência de hardware e nuvem cobradas separadamente. Modelos de contribuidores oferecem taxas de token mais baixas em troca de permitir que a Rayline use dados de solicitação elegíveis para treinamento de modelos.
- CategoriaMLOps e implantação de modelos
- Modelo de preçosFreemium
- ImplantaçãoNuvem, Local
- PlataformasWeb
Recursos principais de Rayline
Roteamento Unificado de Modelo de IA (ARC)
Seleção de Modelo Otimizada para Custo
Controle de Dados e Privacidade
Integração com Ferramentas e Modelos de IA Existentes
Roteamento Adaptativo com Base em Prioridades
Implantação Flexível de Inferência (Hospedada ou Autogerida)
API Decisions para Respostas Estruturadas
API Routes para Seleção de Modelo
Workshop Cloud e Desktop para Desenvolvimento
Rayline CLI para Integração de Modelos Locais
Economias Significativas em Custos de Inferência
Relatório Técnico e Pesquisa de Apoio
Modelos de Precificação de Taxa Fixa e Dinâmica
Opções de Precificação de Modelos de Contribuidores
Plataforma de Monitoramento de Uso e Gastos
Como usar Rayline?
Conectar Ferramentas: Integre modelos e ferramentas de IA existentes como Claude, OpenAI e Hugging Face com a Rayline.
Configurar Roteamento: Defina suas prioridades para qualidade e custo para moldar as decisões de seleção de modelo do ARC.
Implantar Inferência: Escolha executar a inferência através dos serviços hospedados da Rayline (Swift, Sage) ou gerenciá-la em sua própria infraestrutura usando a API Routes.
Desenvolver Aplicações: Utilize o Workshop Cloud ou Desktop para construir software pronto para produção com agentes adaptativos.
Monitorar e Otimizar: Acompanhe o uso e os gastos na Plataforma Rayline e ajuste as políticas de roteamento para melhoria contínua.
Casos de uso de Rayline
- Otimização da Seleção de Modelos de IA
- Redução de Custos de Inferência
- Integração de Diversas Ferramentas de IA
- Desenvolvimento de Agentes de IA Adaptativos
- Garantindo Controle de Dados
- Tomada de Decisão Estruturada
- Personalização da Economia de Roteamento
- Avaliação de Políticas de Roteamento