Descrição
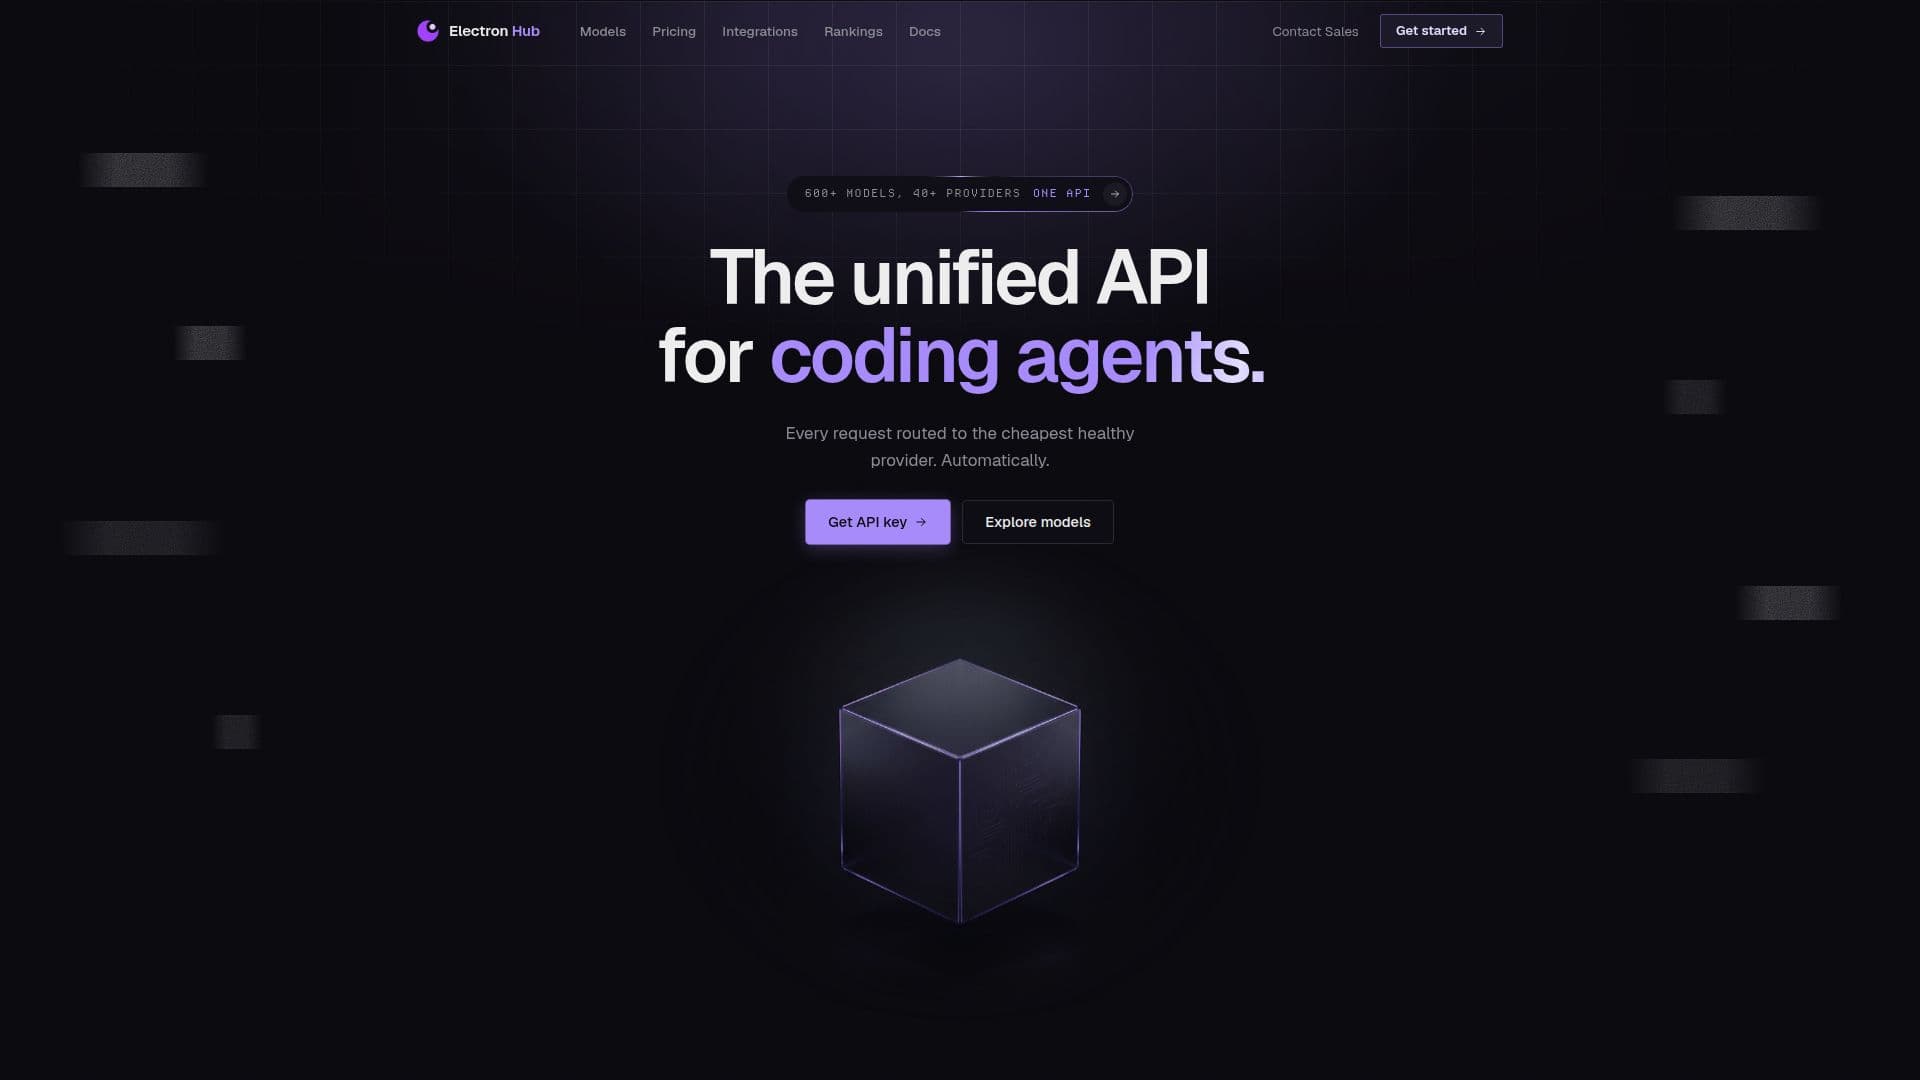
Electron Hub oferece um gateway de API abrangente projetado para otimizar a inferência de modelos de linguagem de grande porte (LLM) para desenvolvedores e empresas. Ele consolida o acesso a mais de 600 modelos de mais de 40 provedores diferentes através de um único endpoint compatível com OpenAI. Essa abordagem unificada elimina o bloqueio de provedores e simplifica o processo de integração, permitindo que os usuários mudem de modelo alterando apenas uma string em seu código.
Ler mais
A funcionalidade central da plataforma gira em torno de seu roteador inteligente, que direciona automaticamente cada solicitação para o provedor saudável mais barato com base na pontuação em tempo real de preço, latência e saúde. Isso garante desempenho ideal e eficiência de custos sem exigir que os usuários gerenciem lógica complexa de failover ou infraestrutura de GPU. Electron Hub gerencia toda a pilha de inferência, incluindo a API, tempo de execução para agrupamento e cache, e a frota de GPU subjacente, liberando os usuários da sobrecarga operacional.
Além do roteamento básico, Electron Hub incorpora recursos avançados de nível de produção. Ele inclui barreiras de segurança em linha, como redação de PII, varredura de injeção e filtros de políticas que processam solicitações antes de chegarem ao modelo, garantindo a segurança dos dados. O sistema também possui alta disponibilidade com múltiplos upstreams por modelo e mecanismos automáticos de reintento, transformando possíveis interrupções em pequenos problemas. Os usuários se beneficiam de um rastreamento detalhado de custo por solicitação, mostrando tokens, latência e gastos por chave, modelo e dia.
Electron Hub suporta até 100 chaves de API com escopo, cada uma com limites de gastos mensais individuais, prevenindo cobranças inesperadas. Ele garante acesso rápido a novos modelos, muitas vezes dentro de minutos após seu lançamento, sem exigir esforços de migração. A plataforma é compatível com qualquer agente ou cliente que fale OpenAI, permitindo integração perfeita apenas apontando para `api.electronhub.ai` e selecionando um modelo do catálogo. Um console central fornece uso em tempo real, gastos, gerenciamento de chaves e monitoramento da saúde do provedor, com capacidades de exportação completas.
Segurança e privacidade são primordiais, com a inferência opcionalmente executada dentro de Ambientes de Execução Confiáveis (TEEs) com suporte de hardware. Isso garante que segredos permaneçam em memória criptografada e cada execução envie uma prova de execução assinada. O serviço é distribuído globalmente, com capacidade de GPU nas Américas, Europa e Ásia, roteando automaticamente solicitações para a região saudável mais próxima para baixa latência. O sistema é projetado para alta taxa de transferência, reequilibrando continuamente milhões de solicitações diariamente entre provedores. Os usuários podem começar rapidamente com créditos semanais gratuitos e sem necessidade de cartão de crédito.
- CategoriaMLOps e implantação de modelos
- Modelo de preçosFreemium
- ImplantaçãoNuvem
- PlataformasWeb
Recursos principais de Electron Hub
Gateway de API unificado para mais de 600 modelos de LLM
Suporta mais de 40 provedores de LLM
Único endpoint compatível com OpenAI
Failover automático de provedores e balanceamento de carga
Roteamento baseado em custo, latência e saúde em tempo real
Faturamento unificado para todos os provedores
Pools de GPU gerenciados e escalabilidade
Redação de PII em linha e varredura de injeção
Filtros de políticas para moderação de conteúdo
Reintento automático para interrupções
Rastreamento detalhado de custos por chave, modelo e dia
Chaves de API com escopo e limites de gastos mensais
Integração rápida de novos modelos
Compatibilidade com agentes/clientes que falam OpenAI
Console de uso e gastos em tempo real
TEEs com suporte de hardware para inferência segura
Capacidade global de GPU para baixa latência
Como usar Electron Hub?
Comece com Créditos Gratuitos: Acesse créditos semanais sem necessidade de cartão de crédito para começar a usar a plataforma.
Configure o Endpoint da API: Aponte seu cliente ou agente compatível com OpenAI para `api.electronhub.ai` como a URL base.
Selecione Modelos: Escolha entre mais de 600 modelos de mais de 40 provedores alterando uma única string em sua configuração.
Integre com Ferramentas: Adicione Electron Hub a ferramentas como Cursor, Cline, Zed ou Aider editando a configuração do OpenCode.
Monitore o Uso: Use o console central para rastrear uso, gastos, gerenciar chaves e visualizar a saúde do provedor em tempo real.
Casos de uso de Electron Hub
- Roteamento de Inferência de LLM
- Acesso Unificado à API
- Otimização de Custos
- Segurança Aprimorada
- Alta Disponibilidade
- Produtividade do Desenvolvedor
- Tempo de Execução do Agente
- Experimentação de Modelos
- Monitoramento de Uso
- Gerenciamento de Chaves de API