Descrição
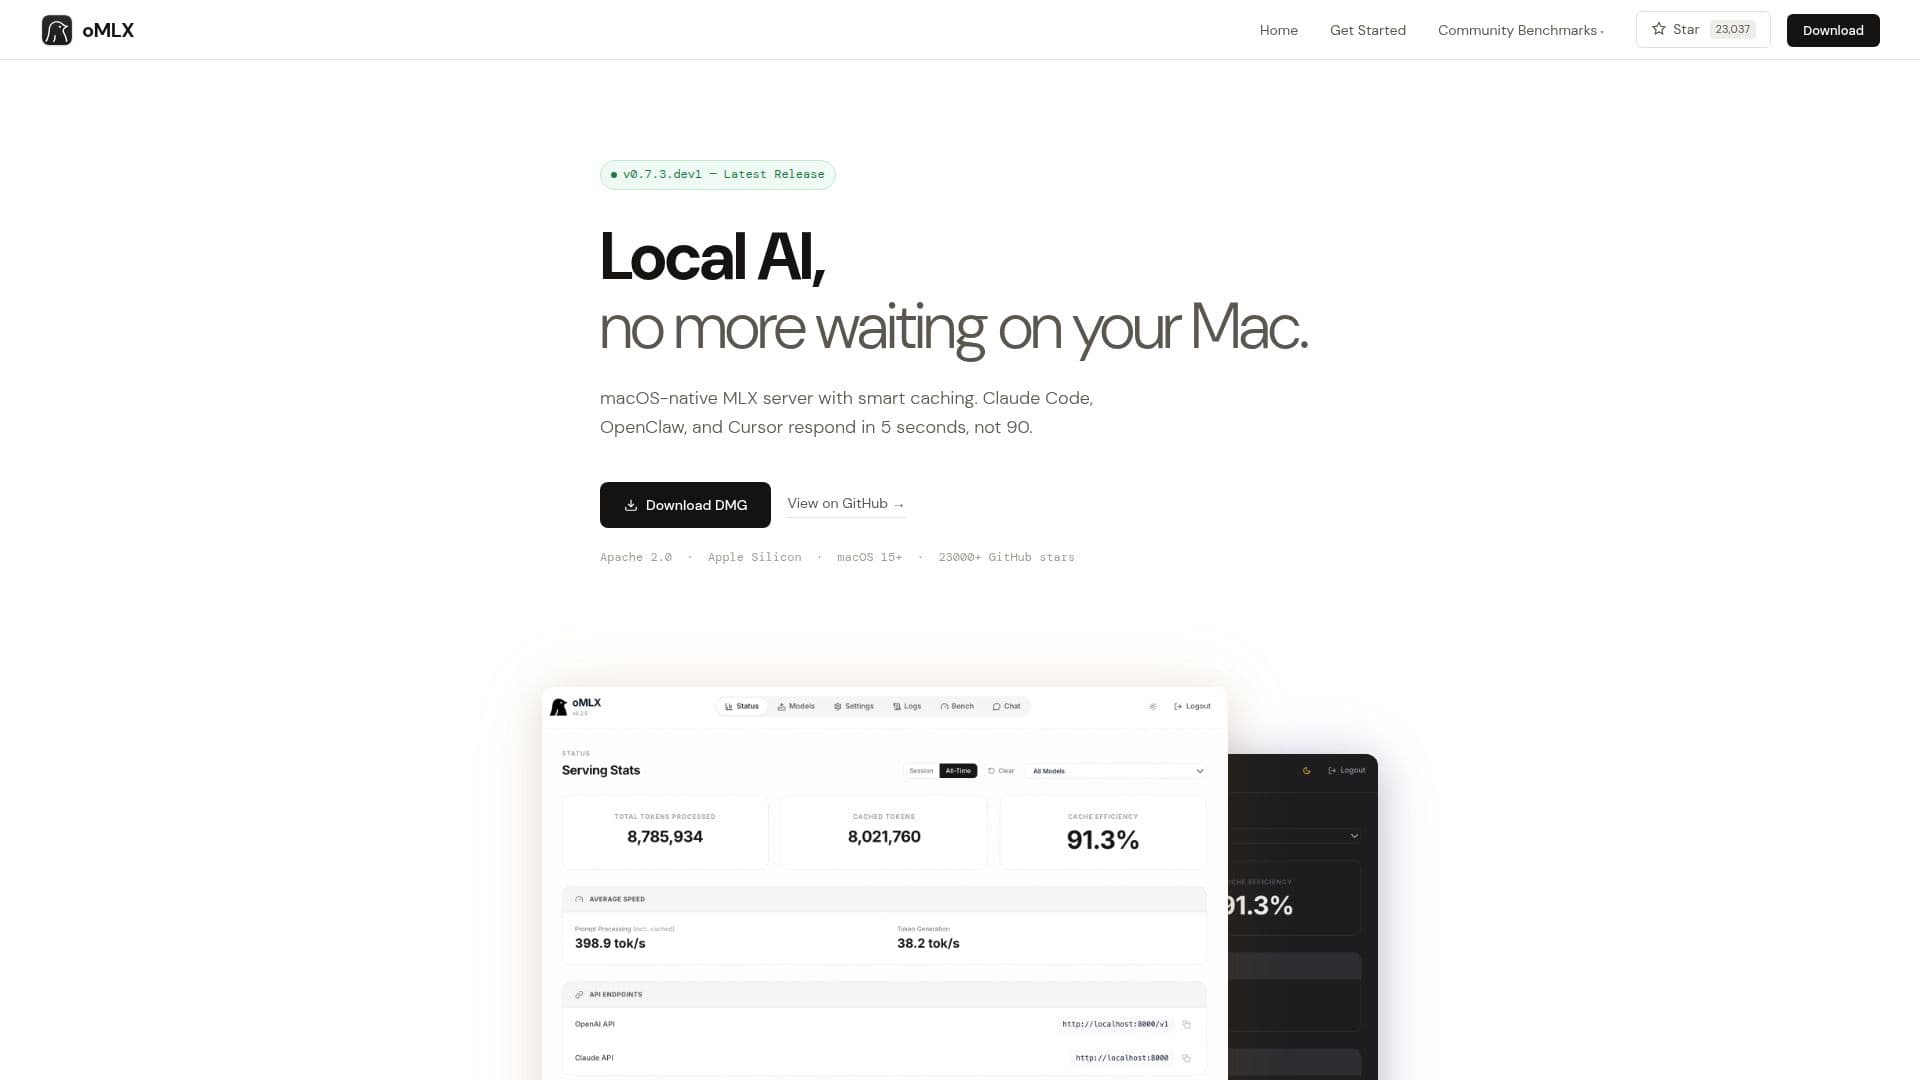
oMLX é um servidor de inferência de ponta projetado especificamente para macOS, aproveitando o poder do Apple Silicon. Construído sobre a estrutura MLX, oferece uma solução nativa para executar grandes modelos de linguagem (LLMs) localmente em computadores Mac. Uma de suas características de destaque é o cache KV em SSD paginado, que reduz drasticamente o tempo até o primeiro token (TTFT) de 30-90 segundos para menos de 5 segundos. Essa melhoria é particularmente benéfica para agentes de codificação que frequentemente invalidam o cache, pois o oMLX garante que cada bloco de cache seja persistido no SSD, permitindo uma rápida restauração a partir do disco.
Ler mais
O servidor é compatível com APIs populares como OpenAI e Anthropic, tornando-se uma ferramenta versátil para desenvolvedores que trabalham com essas plataformas. Ele suporta processamento em lote contínuo e fornece uma API de substituição para modelos como Claude Code, OpenClaw e Cursor, garantindo que as respostas sejam entregues em questão de segundos. Os benchmarks de desempenho realizados em um M3 Ultra com 512GB de RAM demonstram uma impressionante eficiência de throughput e memória em vários contextos e tamanhos de lote.
oMLX é projetado para desenvolvedores e entusiastas de IA que exigem uma solução de IA local confiável e rápida em seus Macs. Ele elimina a necessidade de inferência baseada em nuvem, reduzindo a latência e a dependência de servidores externos. A ferramenta é de código aberto sob a licença Apache 2.0, com uma forte presença na comunidade, como evidenciado por suas mais de 23.000 estrelas no GitHub. Os usuários podem facilmente começar baixando o DMG ou instalando a partir do código-fonte, com compatibilidade para caches padrão do Hugging Face e pastas do LM Studio.
No geral, o oMLX oferece uma solução robusta e eficiente para executar modelos de IA localmente no macOS, proporcionando melhorias significativas de velocidade e integração perfeita com fluxos de trabalho de IA existentes.
- CategoriaMLOps e implantação de modelos
- Modelo de preçosCódigo aberto
- ImplantaçãoLocal
- PlataformasmacOS 15+
Recursos principais de oMLX
Servidor de inferência nativo para macOS
Cache KV em SSD paginado
Compatibilidade com APIs da OpenAI e da Anthropic
Suporte a processamento em lote contínuo
API de substituição para Claude Code, OpenClaw e Cursor
Restauração rápida de cache a partir do SSD
Código aberto sob Apache 2.0
Mais de 23.000 estrelas no GitHub
Como usar oMLX?
Baixar: Obtenha o DMG ou o código-fonte
Instalar: Siga as instruções de instalação
Configurar: Configure com o cache do Hugging Face
Usar: Execute modelos com TTFT reduzido
Otimizar: Aproveite o processamento em lote contínuo
Casos de uso de oMLX
- Desenvolvimento de IA Local
- Integração de API
- Agentes de Codificação
- Processamento em Lote
- Contribuição de Código Aberto