

Descrição
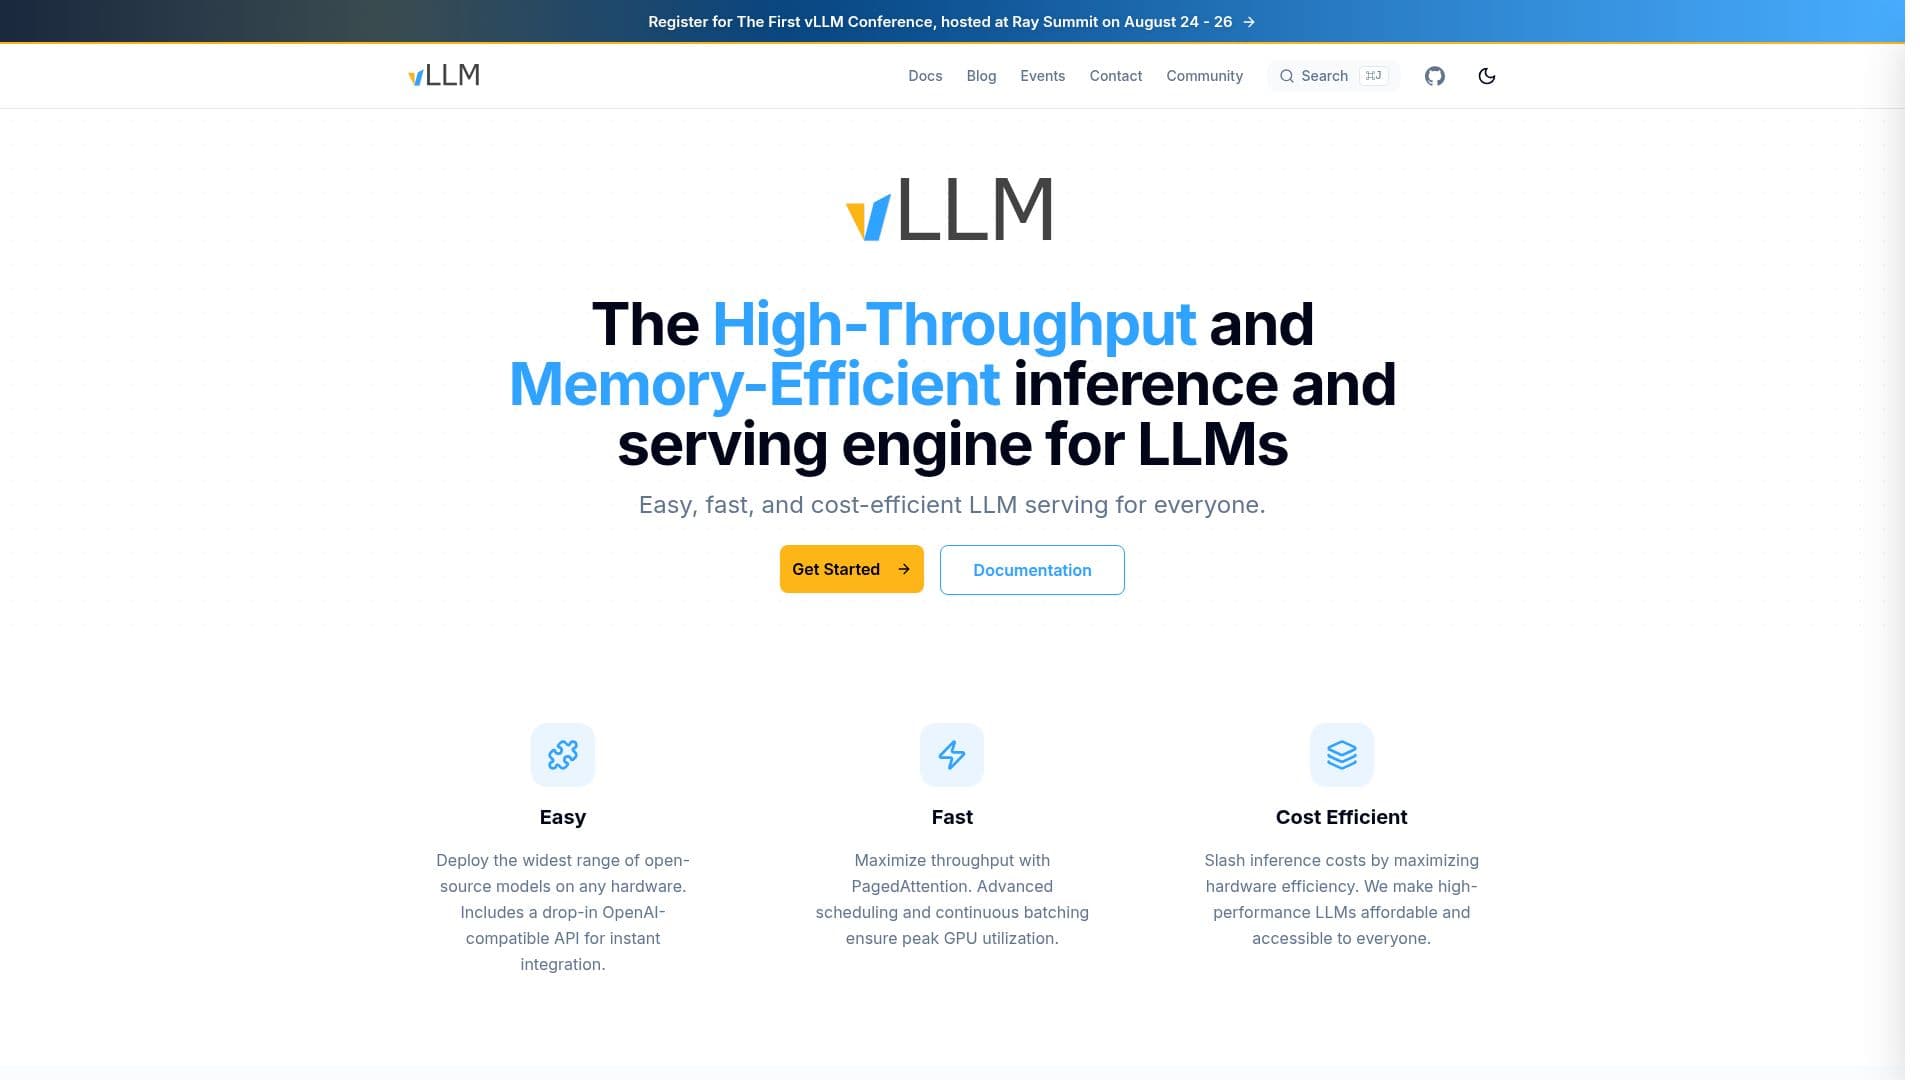
vLLM é projetado para otimizar a inferência e o serviço de Modelos de Linguagem de Grande Escala (LLMs) com foco em alto rendimento e eficiência de memória. Este mecanismo aproveita técnicas avançadas, como núcleos GEMM/MoE otimizados para várias precisões, utilizando frameworks como CUTLASS e TRTLLM-GEN. O objetivo do vLLM é proporcionar uma experiência sem interrupções para a implantação de modelos de IA, garantindo que os usuários possam alcançar desempenho de ponta sem as complexidades normalmente associadas ao serviço de LLM.
Ler mais
A plataforma é construída para compatibilidade universal, permitindo que se integre a várias configurações de hardware, incluindo suporte para GPUs NVIDIA, GPUs AMD e TPUs do Google. Essa flexibilidade torna o vLLM uma escolha ideal para desenvolvedores e organizações que buscam implementar soluções de IA em diferentes ambientes. Os usuários podem começar a usar o vLLM rapidamente com uma configuração mínima, graças ao seu processo de configuração simples.
vLLM também oferece uma abordagem orientada pela comunidade, com fóruns disponíveis para os usuários discutirem tópicos que vão desde suporte a hardware até integração de modelos. Esse ambiente colaborativo promove a troca de conhecimentos e ajuda os usuários a otimizar seu uso da plataforma. Além disso, o vLLM suporta uma ampla gama de modelos, incluindo arquiteturas populares como Llama, BART e GPT, entre outras.
Em resumo, o vLLM se destaca como uma ferramenta poderosa para quem busca implantar LLMs de forma eficiente. Sua combinação de desempenho, facilidade de uso e suporte comunitário o posiciona como um recurso valioso no campo em rápida evolução da IA.
- CategoriaMLOps e implantação de modelos
- Modelo de preçosCódigo Aberto
- ImplantaçãoNuvem
- PlataformasNVIDIA, AMD, Google TPU
Recursos principais de vLLM
Alto Rendimento
Eficiência de Memória
Compatibilidade Universal
Núcleos GEMM/MoE Otimizados
Suporte para Múltiplos Hardwares
Fóruns Comunitários
Configuração Rápida
Amplo Suporte a Modelos
Como usar vLLM?
Configurar: Prepare seu ambiente de hardware para suportar o vLLM.
Instalar: Siga as instruções de instalação fornecidas na documentação.
Implantar: Carregue seu modelo de IA desejado no mecanismo vLLM.
Otimizar: Ajuste as configurações para desempenho com base em seu caso de uso específico.
Casos de uso de vLLM
- Implantação de Modelos de IA
- Otimização de Desempenho
- Engajamento Comunitário
- Integração de Modelos Personalizados
- Compatibilidade entre Plataformas






