Descrição
Flide é uma infraestrutura de inferência avançada especificamente projetada para acelerar modelos de decisão estilo Jev. Sua inovação central reside em sua capacidade de realizar bifurcação de estado exata, permitindo que um único estado de entrada seja processado para múltiplas perguntas em uma única passagem para frente. Isso significa que o estado é lido apenas uma vez e, em seguida, bifurcado de forma eficiente, garantindo que cada pergunta receba a resposta precisa que obteria se fosse feita isoladamente.
Ler mais
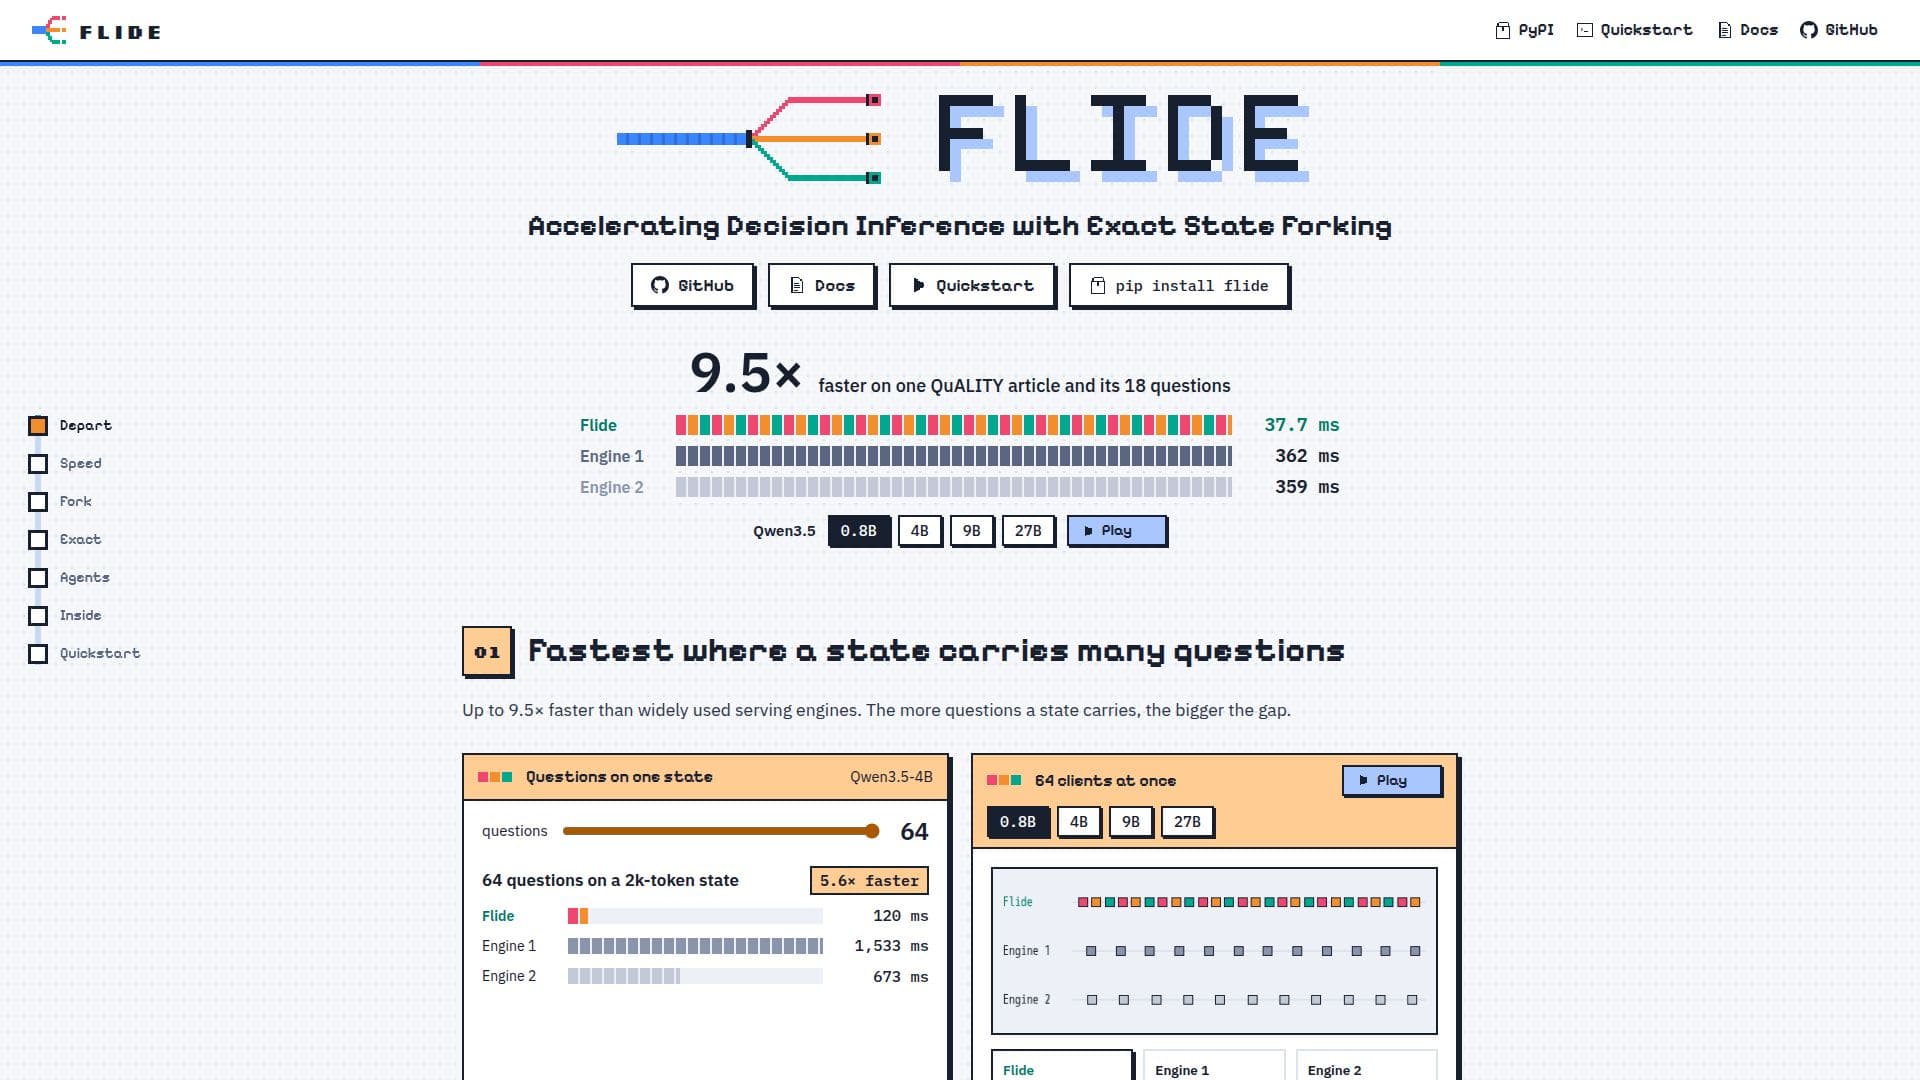
Essa arquitetura única proporciona ganhos substanciais de desempenho, com Flide demonstrando até 9,5 vezes mais rápido em inferência em comparação com motores de serviço amplamente utilizados, como vLLM e SGLang. A vantagem de desempenho se torna ainda mais pronunciada à medida que o número de perguntas associadas a um determinado estado aumenta. Por exemplo, com 64 perguntas em um estado de 2k tokens, Flide alcança um aumento de 9,5x na velocidade e 2,2x maior taxa de transferência com 64 clientes.
Além da velocidade, Flide prioriza a precisão, mantendo-se dentro de 1,1 pontos de uma referência float32, tornando-se um dos motores mais próximos de uma referência de verdade. Ele suporta uma variedade de modelos, incluindo modelos de chat baseados em Qwen3.5 e Gemma 4, bem como modelos OneJev. Flide também lida com modelos híbridos, onde camadas Gated DeltaNet garantem que cada pergunta comece a partir do estado exato do contexto compartilhado. O sistema oferece uma opção `--batch-invariant`, garantindo que uma solicitação produza os mesmos bits, independentemente de como é agrupada.
A instalação é simples via pip, e suporta serviço com núcleos pré-construídos para várias GPUs NVIDIA, incluindo A40, A10, RTX 30, H100 e H200. Flide expõe a mesma API `/v1/systemone` que vLLM e SGLang, fornecendo probabilidades para cada opção na resposta. Ele suporta entradas multimodais, incluindo texto, imagens e vídeo, dependendo do modelo de backbone. Recursos como quantização FP8 para Qwen3.5 em GPUs Ada, Hopper e Blackwell, e um cache de sessão para retomar estados de agentes, aprimoram ainda mais suas capacidades.
- CategoriaMLOps e implantação de modelos
- ImplantaçãoAuto-hospedado
- PlataformasWeb
Recursos principais de Flide
Bifurcação de Estado Exata: Processa um estado para todas as perguntas em uma única passagem para frente.
Inferência Acelerada: Até 9,5x mais rápido que outros motores de serviço.
Alta Taxa de Transferência: Alcança 2,2x de taxa de transferência com 64 clientes em benchmarks específicos.
Proximidade à Referência Float32: Mantém-se dentro de 1,1 pontos de uma referência float32 para precisão.
Invariância de Lote: Garante resultados consistentes, independentemente do agrupamento com `--batch-invariant`.
Mecanismo ForkAttention: Cada pergunta lê seu estado no lugar, como se fosse feita isoladamente.
Exato em Modelos Híbridos: Suporta camadas Gated DeltaNet para manipulação precisa de contexto.
Processamento de Fluxo Único: Executa solicitações como um único fluxo de tokens reproduzido por gráficos CUDA.
API Compatível com vLLM/SGLang: Usa o padrão de API `/v1/systemone`.
Núcleos Pré-construídos: Otimizado para GPUs NVIDIA A40, A10, RTX 30, H100 e H200.
Backbones de Modelos: Suporta Qwen3.5 (0,8B, 2B, 4B, 9B, 27B) e Gemma 4 (E2B, E4B, 12B, 26B-A4B, 31B).
Entradas Multimodais: Lida com entradas de texto, imagens e vídeo.
Quantização FP8: Executa Qwen3.5 em FP8 em GPUs Ada, Hopper e Blackwell.
Cache de Sessão: Mantém estados anteriores para agentes retomar (por exemplo, `--session-cache-gb 40`).
Processos Frontend: Suporta execução de HTTP, renderização e tokenização em processos separados para muitos clientes.
Como usar Flide?
Instalar Flide: Use pip para instalar o pacote Flide.
Iniciar um Servidor: Execute `flide serve` para iniciar o servidor de inferência, especificando opcionalmente `--host`.
Configurar Modelos: Sirva modelos de chat como Qwen3.5 ou Gemma 4 diretamente, ou mescle adaptadores Open-Jev.
Enviar Solicitações: Interaja com o servidor usando a API `/v1/systemone` para enviar estados e perguntas.
Processar Entradas Multimodais: Inclua caminhos de imagem no estado e envie mídia para modelos que suportam imagens.
Casos de uso de Flide
- Modelos de Decisão Acelerados
- Inferência Multimodal
- Processamento de Lote Consistente
- Gerenciamento de Estado de Agentes
- Serviço de LLM de Alto Desempenho
- Pesquisa e Desenvolvimento