Langsung ke konten utama
ToolPotion
Penasihat AI
Kirim (Gratis)

WeMM-Video-35B-A3B

LLM#38Model AI & LLMOpen source · Web

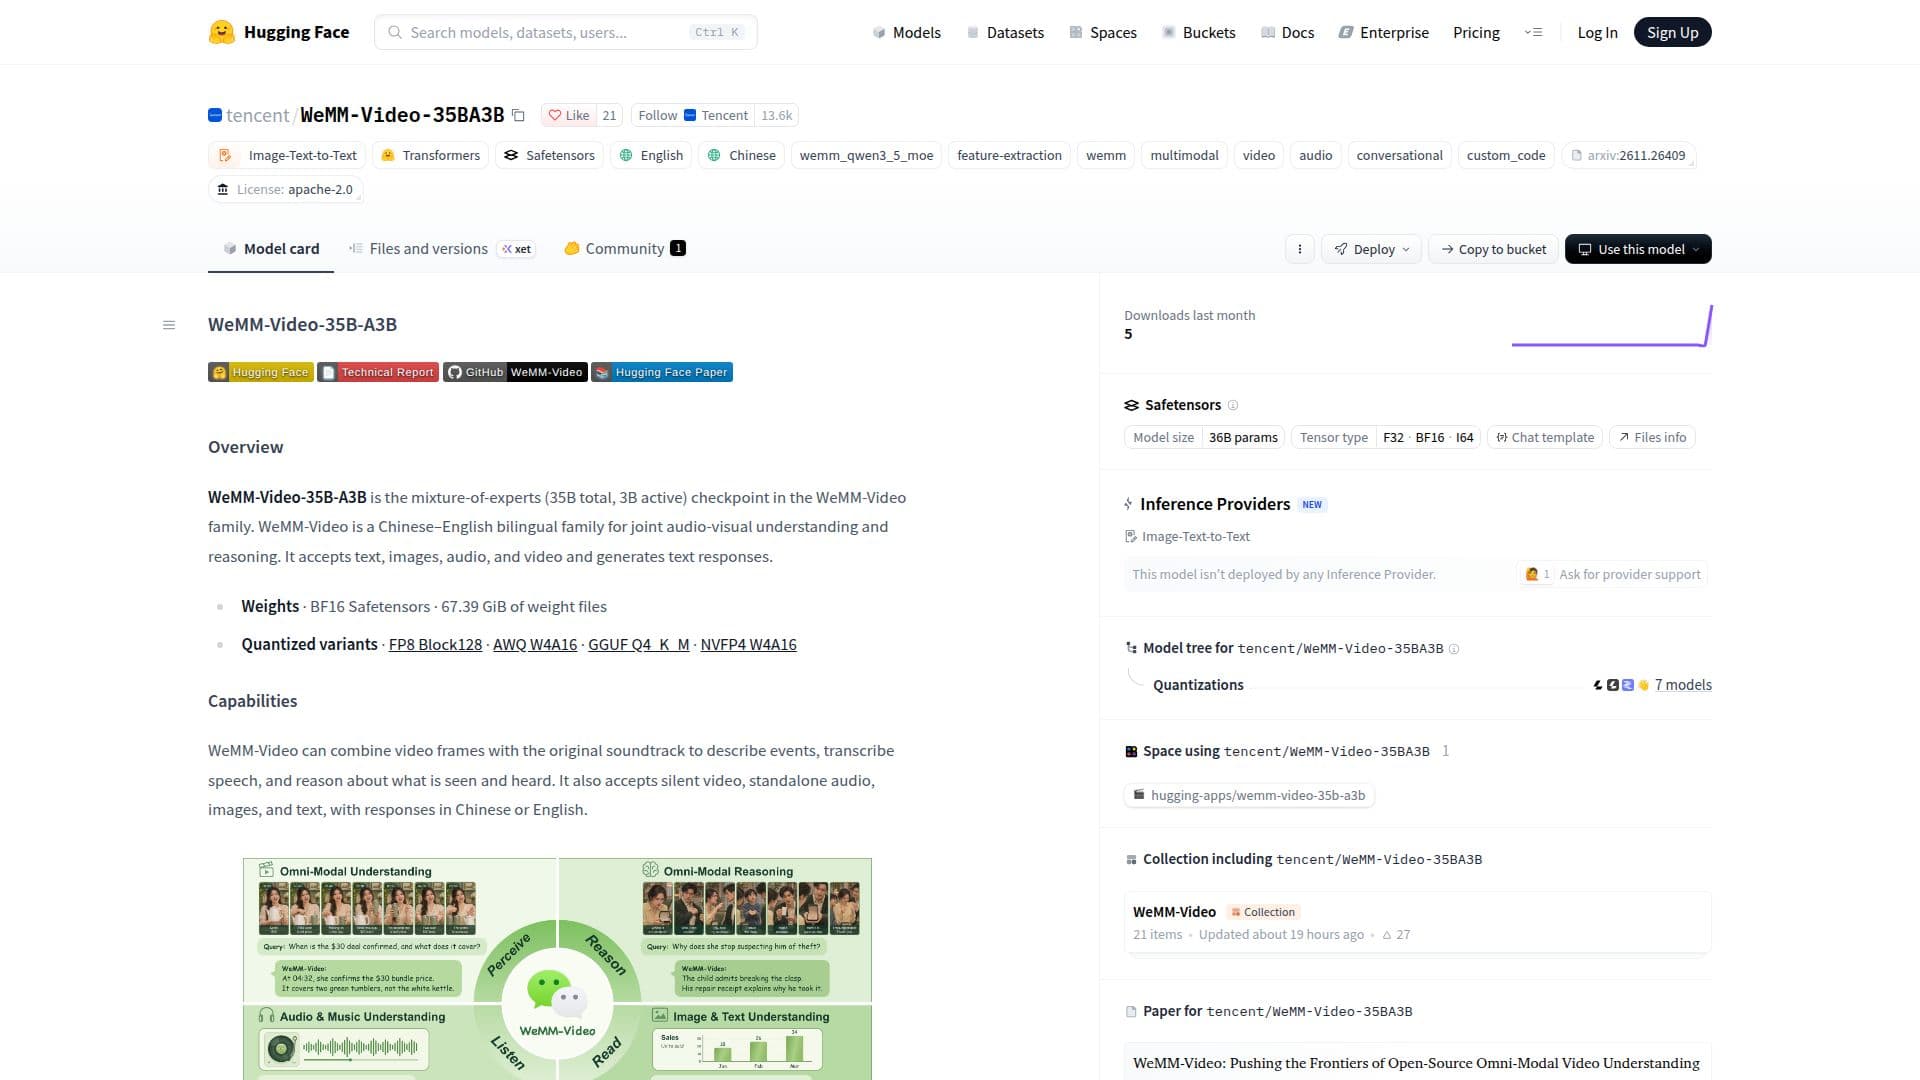
WeMM-Video-35B-A3B adalah model campuran-para ahli dari keluarga WeMM-Video, dirancang untuk pemahaman dan penalaran audio-visual secara bersama. Model bilingual Cina-Inggris ini menerima input teks, gambar, audio, dan video untuk menghasilkan respons teks. Model ini dapat mendeskripsikan peristiwa, mentranskripsi ucapan, dan melakukan penalaran tentang apa yang dilihat dan didengar, menawarkan mode respons langsung dan penalaran.

Kunjungi URL
Bagikan
Tangkapan layar WeMM-Video-35B-A3B

WeMM-Video-35B-A3B adalah model campuran-para ahli yang canggih, bagian dari keluarga WeMM-Video yang lebih luas, dikembangkan untuk pemahaman dan penalaran audio-visual yang komprehensif. Dengan total 35 miliar parameter dan 3 miliar parameter aktif, model ini dirancang khusus untuk memproses dan menginterpretasikan input multimodal, termasuk teks, gambar, audio, dan video, menghasilkan respons teks yang koheren dalam bahasa Cina atau Inggris.

Baca Selengkapnya

Kemampuan inti model ini mencakup kemampuan untuk menggabungkan bingkai video dengan trek suara aslinya untuk mendeskripsikan peristiwa, mentranskripsi ucapan dengan akurat, dan melakukan tugas penalaran berdasarkan informasi visual dan auditori. Model ini juga cukup fleksibel untuk menangani video tanpa suara, audio mandiri, gambar, dan input teks secara independen. Ini menjadikannya cocok untuk berbagai aplikasi yang memerlukan pemahaman kontekstual yang mendalam di berbagai jenis media.

Secara arsitektural, WeMM-Video-35B-A3B menggunakan pengkode visi dan audio untuk mengubah input media menjadi token, yang kemudian diproses oleh model bahasa bersama dengan teks. Bingkai video diperkaya dengan cap waktu untuk mempertahankan konteks temporal. Keluarga model ini menjalani pelatihan awal yang ekstensif pada sekitar 1,2 triliun token multimodal, diikuti oleh teknik pasca-pelatihan lanjutan seperti multi-teacher OPD, anti-repetition MrDPO, dan pembelajaran penguatan spesialis untuk meningkatkan kinerja dan ketahanannya.

Penerapan dan integrasi difasilitasi melalui berbagai opsi penyajian. Pengguna dapat mengatur lingkungan Transformers dan menjalankan contoh langsung dari repositori WeMM-Video. Model ini mendukung varian terkuantisasi seperti FP8 Block128, AWQ W4A16, GGUF Q4_K_M, dan NVFP4 W4A16. Untuk penyajian, model ini kompatibel dengan versi yang diperbaiki dari vLLM (0.18.0 dan 0.31.0) dan SGLang (0.5.16 atau 0.5.19), memungkinkan inferensi yang efisien, termasuk paralelisme tensor di beberapa GPU. Model ini juga menawarkan berbagai mode obrolan, termasuk mode instruksi default dan mode 'Berpikir' untuk respons penalaran.

WeMM-Video-35B-A3B telah menunjukkan kinerja yang kuat, menetapkan standar baru dalam sumber terbuka. Model ini terbukti mengungguli model proprietary seperti Qwen3.5-Omni-Flash dan Seed2.0-Mini-0428, secara signifikan mempersempit kesenjangan kinerja dengan model canggih seperti Gemini-3.0-Flash. Model ini dirilis di bawah Lisensi Apache 2.0, mempromosikan akses terbuka dan kolaborasi dalam komunitas AI.

  • KategoriModel AI & LLM
  • Model HargaOpen source
  • PenerapanCloud
  • PlatformWeb

  • Pemrosesan bilingual Cina-Inggris

  • Pemahaman dan penalaran audio-visual bersama

  • Menerima input teks, gambar, audio, dan video

  • Menghasilkan respons teks

  • Mendeskripsikan peristiwa dari bingkai video dan trek suara

  • Mentranskripsi ucapan dari audio

  • Melakukan penalaran tentang informasi visual dan auditori

  • Mendukung pemrosesan video tanpa suara dan audio mandiri

  • Arsitektur campuran-para ahli (35B total, 3B parameter aktif)

  • Dilatih sebelumnya pada 1,2 triliun token multimodal

  • Dilatih pasca dengan multi-teacher OPD dan MrDPO

  • Pembelajaran penguatan spesialis untuk meningkatkan kinerja

  • Mendukung berbagai varian terkuantisasi (FP8, AWQ, GGUF, NVFP4)

  • Kompatibel dengan vLLM dan SGLang yang diperbaiki untuk penyajian

  • Menawarkan mode obrolan Instruct dan Thinking

  1. Siapkan Lingkungan: Instal lingkungan Transformers dan ketergantungan yang diperlukan.

  2. Muat Model: Muat model WeMM-Video-35B-A3B dan pemroses dari Hugging Face Hub.

  3. Siapkan Input: Berikan input media seperti file video MP4, audio mandiri, gambar, atau teks.

  4. Proses Media: Gunakan skrip untuk memproses bingkai video sendiri atau dengan trek audio asli.

  5. Hasilkan Respons: Kirim permintaan ke model, menentukan mode obrolan (Instruct atau Thinking) untuk menghasilkan teks.

  6. Sajikan Model (Opsional): Instal patch runtime WeMM dan gunakan vLLM atau SGLang yang diperbaiki untuk penyajian API.

  7. Kirim Permintaan API: Gunakan klien permintaan yang disertakan untuk mengirim media secara inline ke endpoint obrolan yang kompatibel dengan OpenAI.

  • Analisis Konten Video
  • Transkripsi Ucapan
  • Penalaran Multimodal
  • Pemrosesan Konten Bilingual
  • Deskripsi Peristiwa Audio-Visual
  • Pengembangan Model AI
  • Penelitian dan Eksperimen
Alat AI Populer Seperti WeMM-Video-35B-A3B

Llama-3.2-11B-Vision-Instruct adalah model AI multimodal yang dirancang untuk pengenalan visual, penalaran gambar, dan penulisan keterangan. Dikembangkan oleh Meta, model ini…

Model AI & LLM
Lihat Alat

Model AI multimodal yang dirancang untuk pengenalan visual, penalaran gambar, dan penulisan keterangan. Dikembangkan oleh Meta, model ini…Llama-3.2-11B-Vision-Instruct adalah model AI multimodal yang dirancang untuk pengenalan visual, penalaran gambar, dan penulisan keterangan. Dikembangkan oleh Meta, model ini…

Model AI & LLM
Lihat Top 5 Model AI

Step 3.7 Flash adalah model visi-bahasa Mixture-of-Experts yang jarang dirancang untuk beban kerja produksi frekuensi tinggi. Model ini menggabungkan backbone bahasa dengan…

Model AI & LLM

Peringkat 81 di LLM

Lihat Alat

Model visi-bahasa Mixture-of-Experts yang jarang dirancang untuk beban kerja produksi frekuensi tinggi. Model ini menggabungkan backbone bahasa dengan…Step 3.7 Flash adalah model visi-bahasa Mixture-of-Experts yang jarang dirancang untuk beban kerja produksi frekuensi tinggi. Model ini menggabungkan backbone bahasa dengan…

Model AI & LLM
Peringkat 81 di LLM

Apertus 1.5 adalah keluarga model bahasa multibahasa dan multimodal yang dirancang untuk mendukung berbagai bahasa dan konteks. Ini menawarkan akses sumber terbuka dan kemampuan…

Model AI & LLM

Peringkat 72 di LLM

Lihat Alat

Keluarga model bahasa multibahasa dan multimodal yang dirancang untuk mendukung berbagai bahasa dan konteks. Ini menawarkan akses sumber terbuka dan kemampuan…Apertus 1.5 adalah keluarga model bahasa multibahasa dan multimodal yang dirancang untuk mendukung berbagai bahasa dan konteks. Ini menawarkan akses sumber terbuka dan kemampuan…

Model AI & LLM
Peringkat 72 di LLM

Llama-4 Maverick 17B-128E Instruct adalah model AI multimodal yang dikembangkan oleh Meta, dirancang untuk pemahaman teks dan gambar yang canggih. Model ini memanfaatkan…

Model AI & LLM
Lihat Alat

Model AI multimodal yang dikembangkan oleh Meta, dirancang untuk pemahaman teks dan gambar yang canggih. Model ini memanfaatkan…Llama-4 Maverick 17B-128E Instruct adalah model AI multimodal yang dikembangkan oleh Meta, dirancang untuk pemahaman teks dan gambar yang canggih. Model ini memanfaatkan…

Model AI & LLM
Lihat Top 5 Model AI

Nemotron-Labs-Audex-2B adalah model bahasa besar audio-teks terpadu yang dirancang untuk tugas audio seperti pemahaman, pengenalan, dan terjemahan. Model ini mendukung mode…

Model AI & LLM

Peringkat 33 di LLM

Lihat Alat

Model bahasa besar audio-teks terpadu yang dirancang untuk tugas audio seperti pemahaman, pengenalan, dan terjemahan. Model ini mendukung mode…Nemotron-Labs-Audex-2B adalah model bahasa besar audio-teks terpadu yang dirancang untuk tugas audio seperti pemahaman, pengenalan, dan terjemahan. Model ini mendukung mode…

Model AI & LLM
Peringkat 33 di LLM

Gemini 3.1 Pro adalah model AI canggih yang dirancang untuk tugas kompleks dan penalaran mendalam. Model ini unggul dalam pemahaman multimodal, memberikan respons yang cerdas dan…

Model AI & LLM
Lihat Alat

Model AI canggih yang dirancang untuk tugas kompleks dan penalaran mendalam. Model ini unggul dalam pemahaman multimodal, memberikan respons yang cerdas dan…Gemini 3.1 Pro adalah model AI canggih yang dirancang untuk tugas kompleks dan penalaran mendalam. Model ini unggul dalam pemahaman multimodal, memberikan respons yang cerdas dan…

UnggulanModel AI & LLM
Lihat Top 5 Model AI

Llama-4-Scout-17B-16E-Instruct adalah model AI multimodal yang dirancang oleh Meta. Model ini memanfaatkan arsitektur campuran ahli untuk memberikan kemampuan pemahaman teks dan…

Model AI & LLM
Lihat Alat

Model AI multimodal yang dirancang oleh Meta. Model ini memanfaatkan arsitektur campuran ahli untuk memberikan kemampuan pemahaman teks dan…Llama-4-Scout-17B-16E-Instruct adalah model AI multimodal yang dirancang oleh Meta. Model ini memanfaatkan arsitektur campuran ahli untuk memberikan kemampuan pemahaman teks dan…

Model AI & LLM
Lihat Top 5 Model AI

Qwen3-VL

Repositori GitHub AI

Qwen3-VL adalah seri model bahasa-visual dari tim Qwen Alibaba Cloud, dirilis dalam ukuran Dense dan Mixture-of-Experts dengan edisi instruksi dan penalaran ("Berpikir"). Model…

Model AI & LLM
Lihat Alat

Repositori GitHub AI

Seri model bahasa-visual dari tim Qwen Alibaba Cloud, dirilis dalam ukuran Dense dan Mixture-of-Experts dengan edisi instruksi dan penalaran ("Berpikir"). Model…Qwen3-VL adalah seri model bahasa-visual dari tim Qwen Alibaba Cloud, dirilis dalam ukuran Dense dan Mixture-of-Experts dengan edisi instruksi dan penalaran ("Berpikir"). Model…

Model AI & LLM
Lihat Top 250 Repositori GitHub AI
1 dari 8