Deskripsi
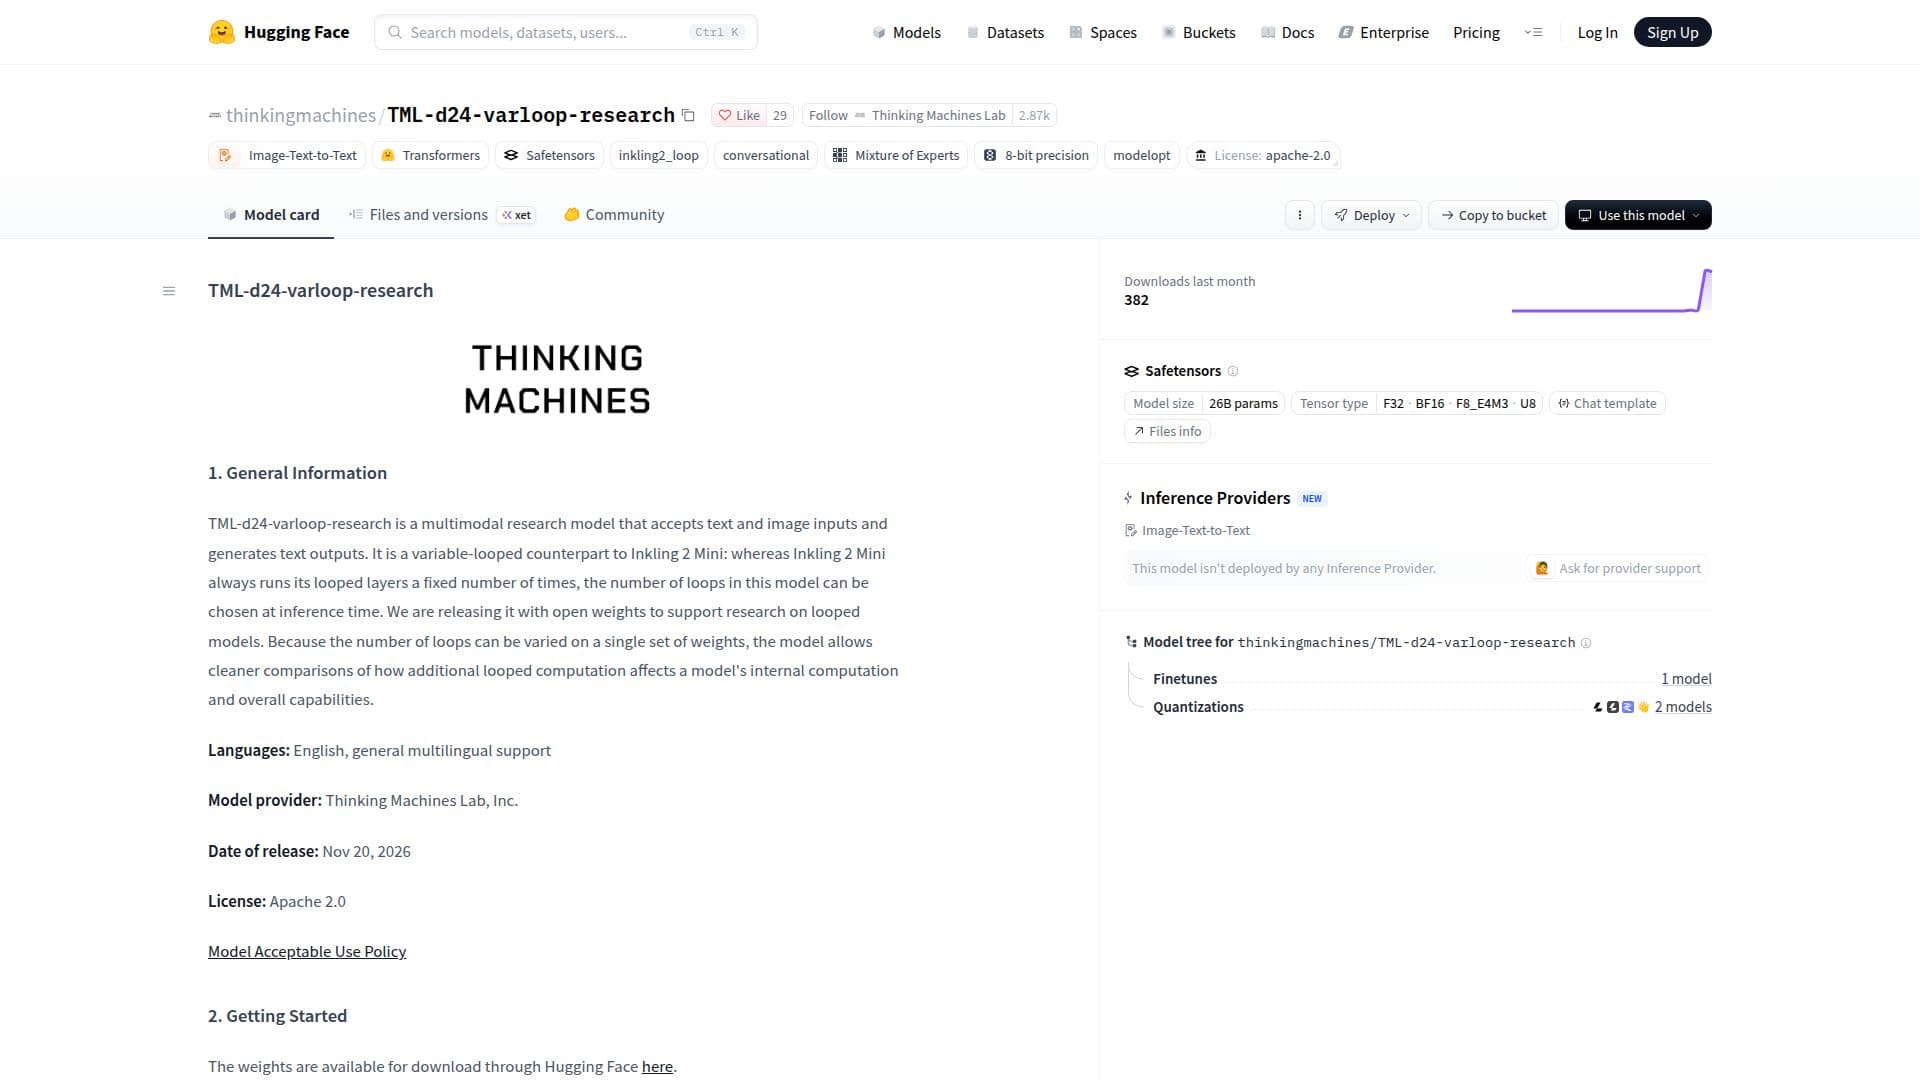
TML-d24-varloop-research adalah model penelitian multimodal yang dikembangkan oleh Thinking Machines Lab, Inc., dirancang untuk memproses input teks dan gambar serta menghasilkan output teks. Dirilis pada 20 November 2026, di bawah lisensi Apache 2.0, model ini merupakan kontribusi signifikan bagi bidang model loop, menawarkan arsitektur loop variabel yang berbeda dari rekan loop tetapnya, Inkling 2 Mini. Peneliti dapat secara dinamis menyesuaikan jumlah loop selama inferensi, memungkinkan perbandingan yang lebih bersih tentang bagaimana tambahan komputasi mempengaruhi proses internal model dan kemampuan keseluruhannya.
Baca Selengkapnya
Model ini didistribusikan sebagai bobot terbuka melalui Hugging Face, dengan ukuran checkpoint tunggal sekitar 20GB. Model ini memerlukan mesin dengan setidaknya 32GB GPU atau memori terpadu, kompatibel dengan konfigurasi seperti NVIDIA DGX Spark, GPU NVIDIA (misalnya, GeForce RTX 5090 atau RTX PRO 6000 Blackwell), atau Mac dengan silikon Apple. TML-d24-varloop-research mendukung inferensi lokal menggunakan berbagai kerangka kerja, termasuk Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth, llama.cpp, Llama App, Ollama, dan Exo Labs. Model ini juga mendukung pelatihan pasca dengan Miles dan SkyRL.
Secara arsitektural, TML-d24-varloop-research adalah transformer dekoder 24-lapisan yang hanya memiliki lapisan feed-forward Mixture-of-Experts (MoE) yang jarang. 12 lapisan tengah dapat dijalankan sejumlah kali yang bervariasi, berbagi bobot, dan dilatih dengan 1 hingga 5 kali lewat. Setiap lapisan mengarahkan token ke 8 dari 128 ahli, dan perhatian adalah kombinasi dari lapisan lokal dan global. Model ini secara native multimodal, mengkodekan gambar melalui transformer visi dan memprosesnya secara bersama dengan teks dalam ruang tersembunyi yang sama. Model ini memiliki 26,4 miliar parameter (3,4 miliar aktif pada 1 kali lewat) dan mendukung numerik NVFP4 dan MXFP8. Model ini menangani teks yang dikodekan UTF-8 dan input gambar berbasis piksel (40px hingga 4096px per dimensi) dengan jendela konteks hingga 1 juta token.
Data pelatihan untuk TML-d24-varloop-research mencakup berbagai jenis konten dari sumber yang tersedia untuk umum, akuisisi pihak ketiga, dan data yang dihasilkan secara internal/sintetis. Kurasi data melibatkan pembersihan, penghapusan duplikasi, dan penyaringan untuk memastikan kualitas dan keamanan. Model ini berbagi pra-pelatihan dan tahap pertama pelatihan tengah dengan Inkling 2 Mini tetapi menyimpang di tahap selanjutnya, terutama dalam pelatihan looping variabelnya, di mana 1 hingga 5 kali lewat diambil sampelnya. Meskipun evaluasi menunjukkan kinerja yang bervariasi dibandingkan dengan Inkling 2 Mini di berbagai tolok ukur seperti Pemrograman Agen, Interpretasi Visi, dan Penalaran, model ini terutama dimaksudkan sebagai artefak penelitian dan tidak disarankan untuk penggunaan produksi karena potensi perilaku yang tidak dapat diprediksi pada jumlah lewat yang berbeda dan keterbatasan umum yang umum pada model dasar, seperti halusinasi dan bias dari data pelatihan.
- KategoriModel AI & LLM
- Model HargaOpen source
- PenerapanBerjalan lokal
- PlatformWeb
Sorotan TML-d24-varloop-research
Input Multimodal: Menerima input teks dan gambar
Output Teks: Menghasilkan teks berdasarkan input
Looping Variabel: Jumlah lapisan loop dapat dipilih pada saat inferensi
Bobot Terbuka: Tersedia untuk diunduh untuk mendukung penelitian
26,4 Miliar Parameter: Model skala besar dengan 3,4B parameter aktif pada 1 kali lewat
Dukungan Multibahasa: Dukungan umum untuk berbagai bahasa
Lisensi Apache 2.0: Lisensi sumber terbuka untuk penggunaan dan modifikasi
Dukungan Inferensi Lokal: Kompatibel dengan Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth, llama.cpp, Llama App, Ollama, Exo Labs
Dukungan Pasca-pelatihan: Dapat dilatih pasca dengan Miles dan SkyRL
Sparse Mixture-of-Experts (MoE): Menggunakan lapisan feed-forward MoE
Perhatian Hibrida: Menggabungkan lapisan perhatian lokal dan global
Multimodalitas Native: Gambar dikodekan melalui transformer visi dan diproses bersama dengan teks
Jendela Konteks Tinggi: Mendukung hingga 1 juta token
Numerik Presisi Campuran: Mendukung NVFP4 dan MXFP8
Memulai dengan TML-d24-varloop-research
Unduh Bobot: Akses bobot model melalui Hugging Face.
Siapkan Perangkat Keras: Pastikan satu mesin dengan setidaknya 32GB GPU atau memori terpadu tersedia.
Instal Perangkat Lunak: Siapkan kerangka kerja inferensi yang diperlukan seperti Hugging Face, SGLang, atau vLLM beserta dependensinya.
Konfigurasi Model: Muat checkpoint 20GB ke dalam kerangka kerja yang dipilih.
Atur Jumlah Loop: Pilih jumlah lapisan loop yang diinginkan untuk inferensi.
Berikan Input: Masukkan teks yang dikodekan UTF-8 dan gambar berbasis piksel (dimensi 40px-4096px) ke dalam model.
Hasilkan Output: Terima output teks dari model berdasarkan input yang diberikan.
Kasus Penggunaan TML-d24-varloop-research
- Penelitian Multimodal
- Studi Model Loop
- Generasi Teks dari Gambar
- Pemrosesan Teks Multibahasa
- Pengembangan Model Bobot Terbuka
- Penerapan Inferensi Lokal
- Penyempurnaan Model