Langsung ke konten utama
ToolPotion
Penasihat AI
Kirim (Gratis)

Mage-VL

LLM#20Model AI & LLMOpen source · Web

Mage-VL adalah model dasar multimodal yang bersifat codec-native dan proaktif-streaming, dirancang untuk pemahaman gambar dan video yang efisien. Model ini memanfaatkan pengkode visual yang unik dan dekoder kausal untuk meningkatkan persepsi streaming waktu nyata sambil mengurangi tuntutan komputasi.

Kunjungi URL
Bagikan
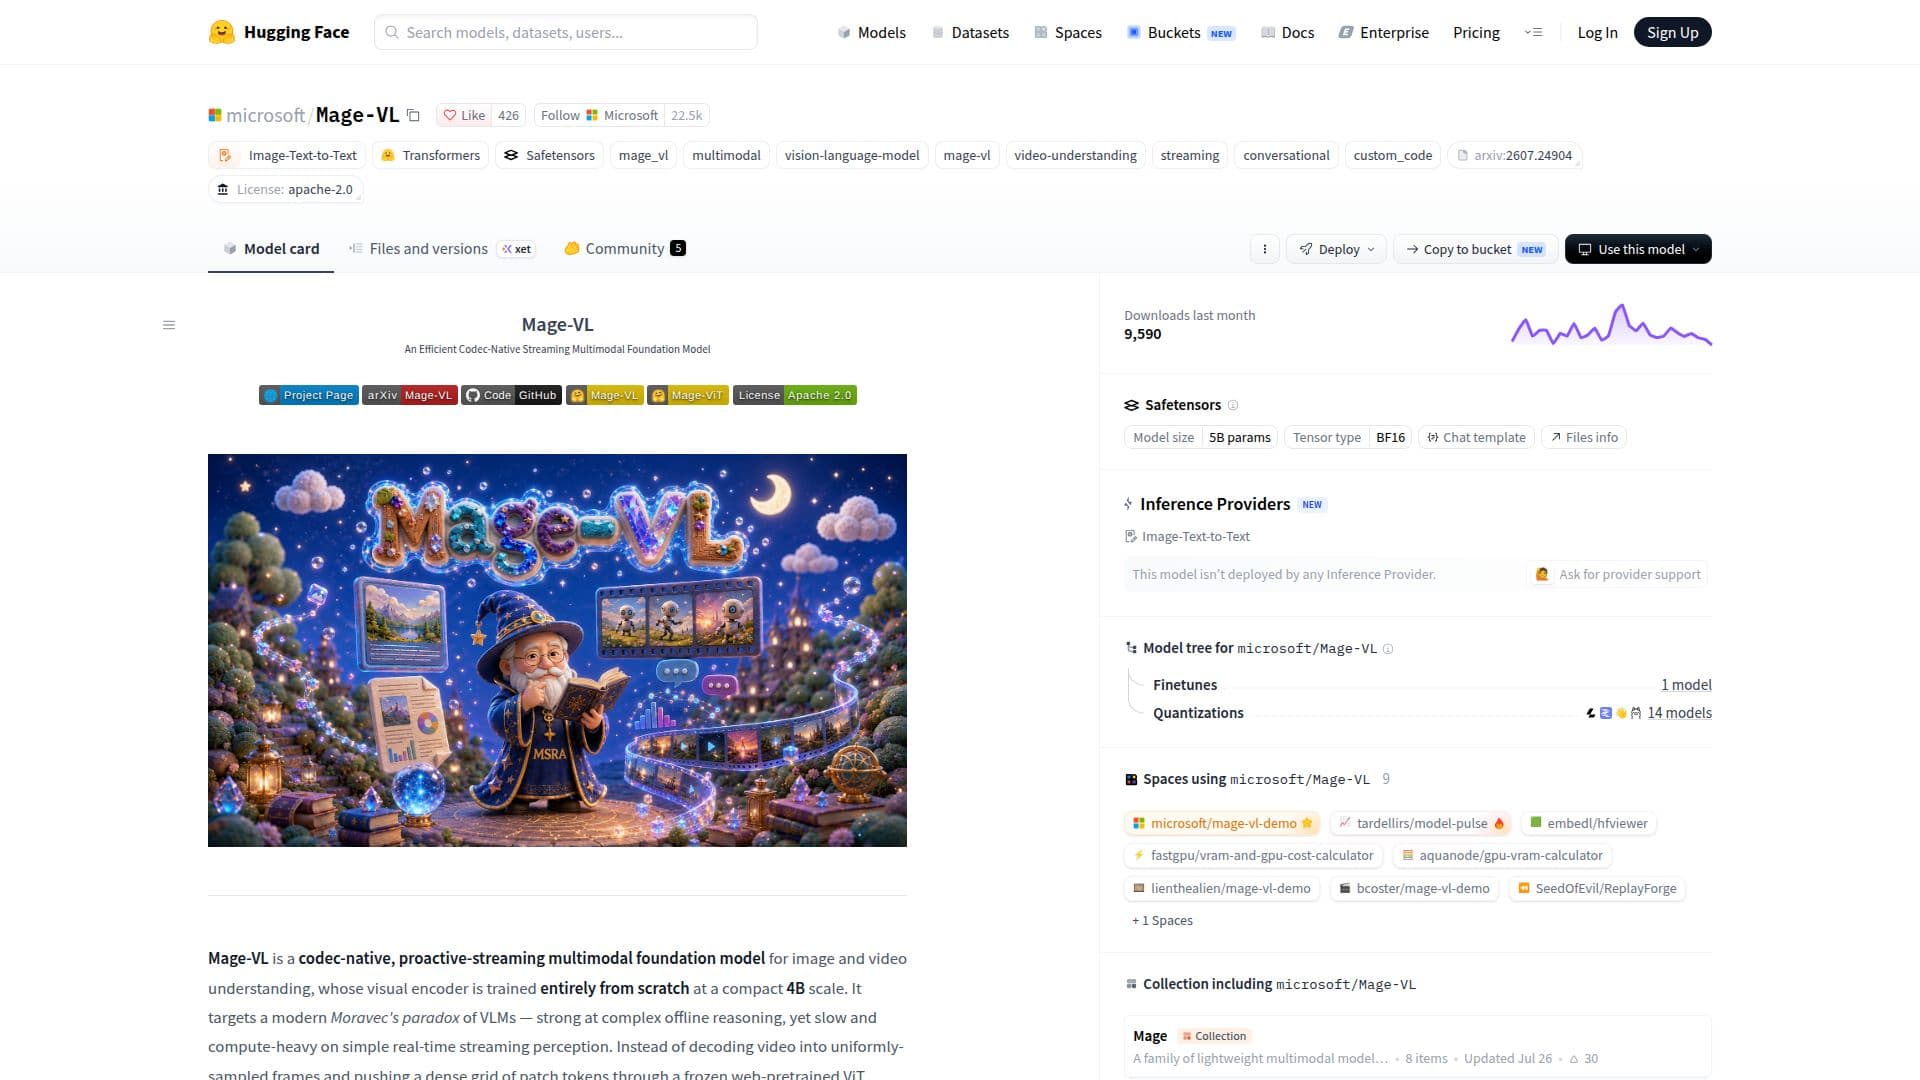
Tangkapan layar Mage-VL

Mage-VL adalah model dasar multimodal inovatif yang dikembangkan untuk mengatasi tantangan pemahaman gambar dan video. Model ini dirancang sebagai model codec-native dan proaktif-streaming yang secara efisien memproses data visual. Pengkode visual model ini, Mage-ViT, dilatih dari awal dan beroperasi pada skala kompak 4B. Pengkode ini unik dalam kemampuannya untuk mengalokasikan token berdasarkan pentingnya spatio-temporal yang berasal dari codec, memungkinkan pemrosesan video hingga delapan kali lebih lama dengan anggaran komputasi yang sama.

Baca Selengkapnya

Arsitektur Mage-VL mencakup dekoder kausal Qwen3-4B, yang merupakan satu-satunya komponen yang telah dilatih sebelumnya. Dekoder ini bekerja sama dengan Mage-ViT untuk menangani aliran token dengan panjang variabel, mendukung antarmuka terpadu untuk gambar dan video dengan panjang yang bervariasi. Desain proses ganda model ini menggabungkan gerbang kognisi yang memungkinkan streaming proaktif dengan memantau konten dan mengaktifkan model bahasa visual secara penuh hanya saat diperlukan.

Pendekatan codec-native model ini secara signifikan mengurangi konsumsi token visual lebih dari 75%, menghasilkan percepatan inferensi 3.5× dibandingkan metode tradisional. Efisiensi ini dicapai tanpa mengorbankan akurasi, menjadikan Mage-VL alat yang kuat untuk analisis dan pemahaman video waktu nyata.

Mage-VL sangat unggul dalam pemahaman video dan kecerdasan spasial, melampaui model sebanding pada beberapa tolok ukur. Kemampuan streaming proaktifnya ditunjukkan melalui kinerjanya pada tugas streaming SoccerNet, di mana ia memberikan komentar berbasis acara dengan latensi rendah.

Secara keseluruhan, Mage-VL mewakili kemajuan signifikan dalam model AI multimodal, menawarkan solusi yang efisien dalam data untuk tugas visual yang kompleks. Sifatnya yang open-source dan kemampuan yang komprehensif menjadikannya sumber daya yang berharga bagi pengembang dan peneliti di bidang kecerdasan buatan.

  • KategoriModel AI & LLM
  • Model HargaOpen source
  • PenerapanCloud
  • PlatformWeb

  • Pengkode visual codec-native

  • Gerbang streaming proaktif

  • Dekoder kausal Qwen3-4B

  • Percepatan inferensi 3.5×

  • Tokenizer efisien data

  • Pra-pelatihan resolusi variabel

  • Model terpadu untuk gambar dan video

  • Komentar berbasis acara

  1. Akses halaman model: Kunjungi repositori Hugging Face

  2. Autentikasi: Gunakan kredensial akun Hugging Face Anda

  3. Konfigurasi: Atur parameter dan lingkungan model

  4. Kirim prompt: Masukkan data gambar atau video Anda untuk diproses

  5. Fine-tune: Sesuaikan pengaturan model untuk tugas tertentu

  • Analisis Video Waktu Nyata
  • Kecerdasan Spasial
  • Komentar Berbasis Acara
  • Pemahaman Gambar
  • Streaming Proaktif

Alat AI Populer Seperti Mage-VL

Qwen3.5-4B adalah model bahasa kausal dengan pengkode visi, dirancang untuk pembelajaran multimodal berkinerja tinggi. Model ini mendukung 201 bahasa dan menawarkan arsitektur…

Model AI & LLM
Lihat Alat

Qwen3.5-4B adalah model bahasa kausal dengan pengkode visi, dirancang untuk pembelajaran multimodal berkinerja tinggi. Model ini mendukung 201 bahasa dan menawarkan arsitektur…

Model AI & LLM
Lihat Top 5 Model AI

DeepSeek-V4-Flash-Vision-Exp adalah model multimodal eksperimental dalam keluarga DeepSeek-V4, yang meningkatkan kemampuan pemahaman visual. Model ini dibangun di atas arsitektur…

Model AI & LLM
Lihat Alat

Model multimodal eksperimental dalam keluarga DeepSeek-V4, yang meningkatkan kemampuan pemahaman visual. Model ini dibangun di atas arsitektur…DeepSeek-V4-Flash-Vision-Exp adalah model multimodal eksperimental dalam keluarga DeepSeek-V4, yang meningkatkan kemampuan pemahaman visual. Model ini dibangun di atas arsitektur…

Model AI & LLM
Lihat Top 50 LLM

MiniMax M3 adalah model AI canggih yang unggul dalam pengkodean dan tugas agens. Ini memiliki jendela konteks 1M dan pemahaman multimodal asli, didukung oleh arsitektur MSA. Model…

Model AI & LLM

Peringkat 49 di LLM

Lihat Alat

Model AI canggih yang unggul dalam pengkodean dan tugas agens. Ini memiliki jendela konteks 1M dan pemahaman multimodal asli, didukung oleh arsitektur MSA. Model…MiniMax M3 adalah model AI canggih yang unggul dalam pengkodean dan tugas agens. Ini memiliki jendela konteks 1M dan pemahaman multimodal asli, didukung oleh arsitektur MSA. Model…

Model AI & LLM
Peringkat 49 di LLM

Ideogram 4

Model AI

Ideogram 4 adalah model teks-ke-gambar mutakhir yang menawarkan kontrol tak tertandingi atas komposisi, gaya, dan tata letak gambar. Ini mendukung resolusi 2k asli dan rendering…

Model AI & LLM
Lihat Alat

Model AI

Model teks-ke-gambar mutakhir yang menawarkan kontrol tak tertandingi atas komposisi, gaya, dan tata letak gambar. Ini mendukung resolusi 2k asli dan rendering…Ideogram 4 adalah model teks-ke-gambar mutakhir yang menawarkan kontrol tak tertandingi atas komposisi, gaya, dan tata letak gambar. Ini mendukung resolusi 2k asli dan rendering…

Model AI & LLM
Lihat Top 5 Model AI

SmolVLM2 adalah model pemahaman video canggih yang dirancang untuk beroperasi secara efisien di berbagai perangkat. Ini menawarkan analisis video yang lebih baik dan kemampuan…

Model AI & LLM
Lihat Alat

Model pemahaman video canggih yang dirancang untuk beroperasi secara efisien di berbagai perangkat. Ini menawarkan analisis video yang lebih baik dan kemampuan…SmolVLM2 adalah model pemahaman video canggih yang dirancang untuk beroperasi secara efisien di berbagai perangkat. Ini menawarkan analisis video yang lebih baik dan kemampuan…

Model AI & LLM
Lihat Top 5 Model AI

Pixtral-12B-2409 adalah model AI multimodal dengan 12 miliar parameter dan pengkode visi 400 juta parameter, dirancang untuk tugas pemrosesan gambar dan teks yang canggih.

Model AI & LLM
Lihat Alat

Pixtral-12B-2409 adalah model AI multimodal dengan 12 miliar parameter dan pengkode visi 400 juta parameter, dirancang untuk tugas pemrosesan gambar dan teks yang canggih.

Model AI & LLM
Lihat Top 5 Model AI

V-JEPA

Repositori GitHub AI

V-JEPA adalah implementasi PyTorch untuk pembelajaran mandiri dari video. Ia memanfaatkan arsitektur prediktif joint-embedding untuk mempelajari representasi visual tanpa anotasi…

Model AI & LLM
Lihat Alat

Repositori GitHub AI

Implementasi PyTorch untuk pembelajaran mandiri dari video. Ia memanfaatkan arsitektur prediktif joint-embedding untuk mempelajari representasi visual tanpa anotasi…V-JEPA adalah implementasi PyTorch untuk pembelajaran mandiri dari video. Ia memanfaatkan arsitektur prediktif joint-embedding untuk mempelajari representasi visual tanpa anotasi…

Model AI & LLM
Lihat Top 250 Repositori GitHub AI

LTX-2

Model AI

LTX-2 adalah model dasar audio-video berbasis DiT yang dirancang untuk menghasilkan video dan audio yang disinkronkan. Model ini menggabungkan teknik generasi video modern dengan…

Model AI & LLM
Lihat Alat

Model AI

Model dasar audio-video berbasis DiT yang dirancang untuk menghasilkan video dan audio yang disinkronkan. Model ini menggabungkan teknik generasi video modern dengan…LTX-2 adalah model dasar audio-video berbasis DiT yang dirancang untuk menghasilkan video dan audio yang disinkronkan. Model ini menggabungkan teknik generasi video modern dengan…

UnggulanModel AI & LLM
Lihat Top 5 Model AI
1 dari 8