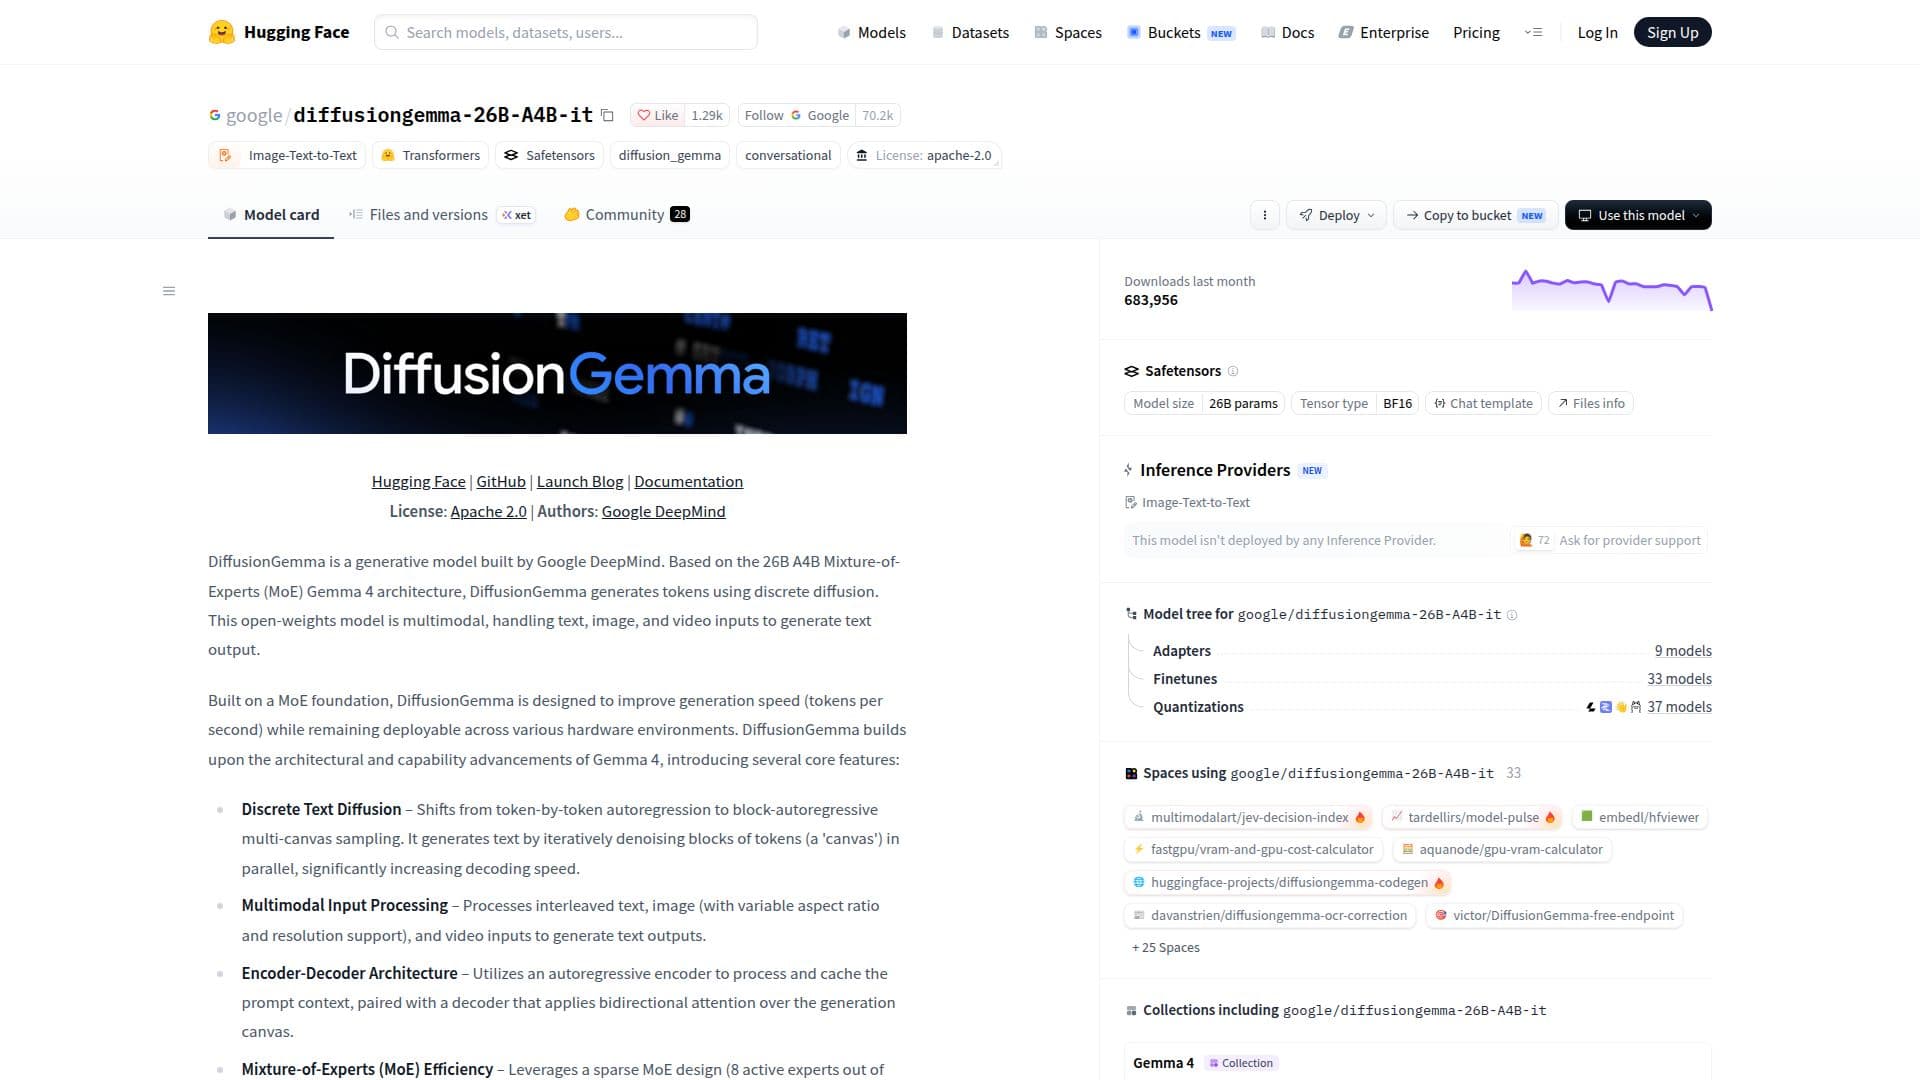
Deskripsi
DiffusionGemma, yang dikembangkan oleh Google DeepMind, adalah model generatif yang memanfaatkan arsitektur 26B A4B Mixture-of-Experts (MoE) Gemma 4. Model ini dirancang untuk menghasilkan output teks dari input multimodal, termasuk teks, gambar, dan video. Model ini menggunakan difusi diskrit untuk meningkatkan kecepatan generasi token, sehingga cocok untuk diterapkan di berbagai lingkungan perangkat keras.
Baca Selengkapnya
Arsitektur model ini memiliki metode pengambilan sampel multi-canvas autoregresif blok, yang secara signifikan meningkatkan kecepatan decoding dengan menghilangkan noise dari blok token secara paralel. Pendekatan ini memungkinkan DiffusionGemma untuk menghasilkan teks dengan kecepatan lebih tinggi dibandingkan model autoregresif tradisional. Arsitektur encoder-decoder memanfaatkan encoder autoregresif untuk memproses dan menyimpan konteks prompt, sementara decoder menerapkan perhatian bidirectional di atas kanvas generasi.
Desain MoE yang jarang pada DiffusionGemma, dengan 8 ahli aktif dari 128, memberikan kemampuan penalaran yang kuat sambil mempertahankan jejak memori yang rendah. Efisiensi ini membuatnya cocok untuk eksekusi lokal dan dioptimalkan untuk inferensi dengan ukuran batch kecil, mencapai generasi berkecepatan tinggi pada satu akselerator yang mampu.
Model ini mendukung pembaruan prompt sistem asli, memungkinkan percakapan yang terstruktur dan dapat dikendalikan. Ini juga mencakup mode berpikir yang dapat dikonfigurasi untuk meningkatkan kemampuan penalaran. Dengan jendela konteks hingga 256K token, DiffusionGemma dapat menangani tugas konteks panjang dengan efektif.
DiffusionGemma telah dievaluasi terhadap berbagai tolok ukur, menunjukkan kinerja yang kompetitif dalam tugas generasi teks dan penalaran. Model ini mendukung kemampuan multibahasa, dilatih pada lebih dari 140 bahasa, dan menawarkan fitur pemahaman gambar dan video yang kuat, termasuk deteksi objek, pemrosesan dokumen, dan analisis konten video.
Secara keseluruhan, DiffusionGemma adalah model serbaguna yang dirancang untuk generasi teks multimodal berkecepatan tinggi, cocok untuk berbagai aplikasi dalam pembuatan konten, penelitian, dan pendidikan.
- KategoriModel AI & LLM
- Model HargaOpen Weights
- PenerapanCloud
- PlatformWeb
Sorotan DiffusionGemma
Difusi Teks Diskrit
Pemrosesan Input Multimodal
Arsitektur Encoder-Decoder
Efisiensi Mixture-of-Experts
Mode Berpikir
Dioptimalkan untuk Inferensi Ukuran Batch Kecil
Dukungan Prompt Sistem Asli
Penanganan Konteks Panjang
Memulai dengan DiffusionGemma
Akses halaman model: Kunjungi halaman model Hugging Face
Autentikasi: Masuk atau buat akun
Konfigurasi: Atur parameter model
Kirim prompt: Masukkan teks, gambar, atau video prompt
Fine-tune: Sesuaikan pengaturan untuk tugas tertentu
Kasus Penggunaan DiffusionGemma
- Generasi Teks
- Ekstraksi Data Gambar
- Pemahaman Video
- Dukungan Multibahasa
- Penelitian dan Pendidikan